안녕하세요. 모릭월드입니다. 챗GPT나 클로드 같은 AI를 쓸 때, 우리는 사실 회사가 운영하는 AI를 인터넷 너머로 ‘빌려 쓰는’ 거예요. AI의 두뇌 자체는 회사 서버 안에 꽁꽁 잠겨 있죠. 그런데 이 두뇌를 통째로 내려받을 수 있게 풀어 주는 회사들도 있어요. 이런 AI를 ‘오픈 웨이트(open-weight) 모델’이라고 불러요.
현지 시간 10월 5일, 미국 AI 스타트업 리플렉션(Reflection AI)이 첫 오픈 웨이트 모델 ‘빔(Beam)’을 공개했어요. 회사는 “서방(미국·유럽) 진영 오픈 모델의 최전선을 끌어올렸다”고 소개했고요. 오늘 새벽엔 오픈 웨이트가 뭔지, 빔이 어떤 점에서 화제인지, 그리고 아직 조심해서 봐야 할 부분까지 차근차근 풀어 볼게요.
먼저, ‘웨이트’가 뭐예요?
AI 모델은 공부를 하면서 수천억 개의 숫자를 조금씩 고쳐 나가요. 이 숫자 하나하나가 웨이트(가중치), 흔히 말하는 매개변수(파라미터)예요. 비유하자면 요리사의 손맛이 담긴 ‘비법 레시피 노트’라고 할 수 있어요. 오픈 웨이트는 이 노트를 누구나 내려받게 공개한다는 뜻이에요.
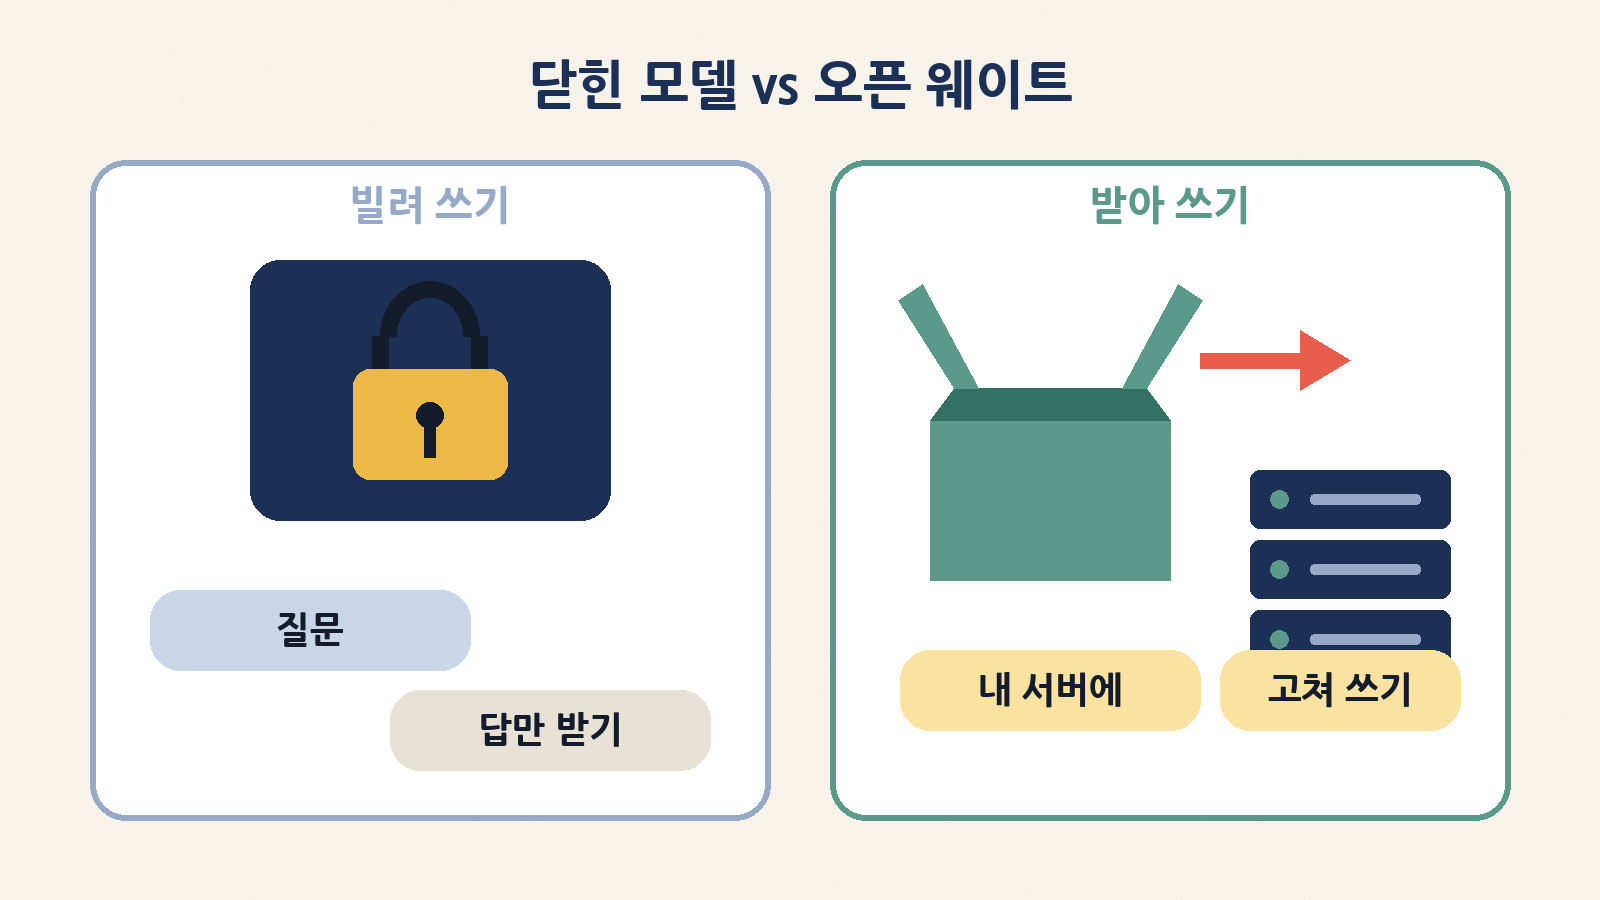
| 구분 | 닫힌 모델 (예: 챗GPT) | 오픈 웨이트 모델 (예: 빔) |
|---|---|---|
| 쓰는 방법 | 회사 앱이나 API로 질문을 보내고 답만 받음 | 모델 파일을 내려받아 내 서버나 클라우드에서 직접 실행 |
| 내 데이터 | 질문 내용이 회사 서버를 거침 | 내 서버 안에서만 돌릴 수 있어 민감한 자료에 유리 |
| 고쳐 쓰기 | 회사가 허락한 범위에서만 조정 | 우리 회사 자료로 추가 학습(파인튜닝) 가능 |
| 쉬운 정도 | 가입만 하면 바로 사용 | 고성능 GPU와 전문 인력이 필요 |
그래서 오픈 웨이트 모델은 주로 기업, 공공기관, 개발자에게 인기가 많아요. 그동안 이 분야에서는 딥시크(DeepSeek), 큐웬(Qwen), 지푸(Z.ai)의 GLM처럼 중국 회사 모델들이 강세였어요. 빔은 “미국에서도 그만한 모델을 내놓을 수 있다”는 걸 보여 주려는 도전이라 더 주목받고 있어요.
빔, 한눈에 보기
| 항목 | 내용 | 쉽게 말하면 |
|---|---|---|
| 만든 곳 | 리플렉션 AI (2024년, 구글 딥마인드 출신 연구자 두 명이 창업) | 엔비디아 등이 투자한 미국 스타트업 |
| 크기 | 전체 매개변수 5,010억 개 중 230억 개만 활성화 | 몸집은 크지만 한 번에 일하는 건 일부 |
| 잘하는 일 | 코딩, 추론, 에이전트 작업 (텍스트 전용) | 스스로 검색·코딩하며 일을 끝내는 AI |
| 기억력 | 최대 100만 토큰 문맥 | 두꺼운 책 여러 권을 한 번에 펼쳐 봄 |
| 공부량 | 23조 8천억 토큰으로 사전 학습 | 인터넷·라이선스 자료를 엄청나게 읽음 |
| 공개 일정 | 지금은 대기자 신청을 받아 일부에만 제공. 가중치와 기술 보고서는 10월 중 공개 예정 | 아직 누구나 내려받을 수 있는 건 아님 |
| 라이선스 | Apache 2.0 예정 | 상업적 이용까지 폭넓게 허용되는 방식 |
5,010억인데 230억만 일한다? ‘전문가 혼합’ 이야기
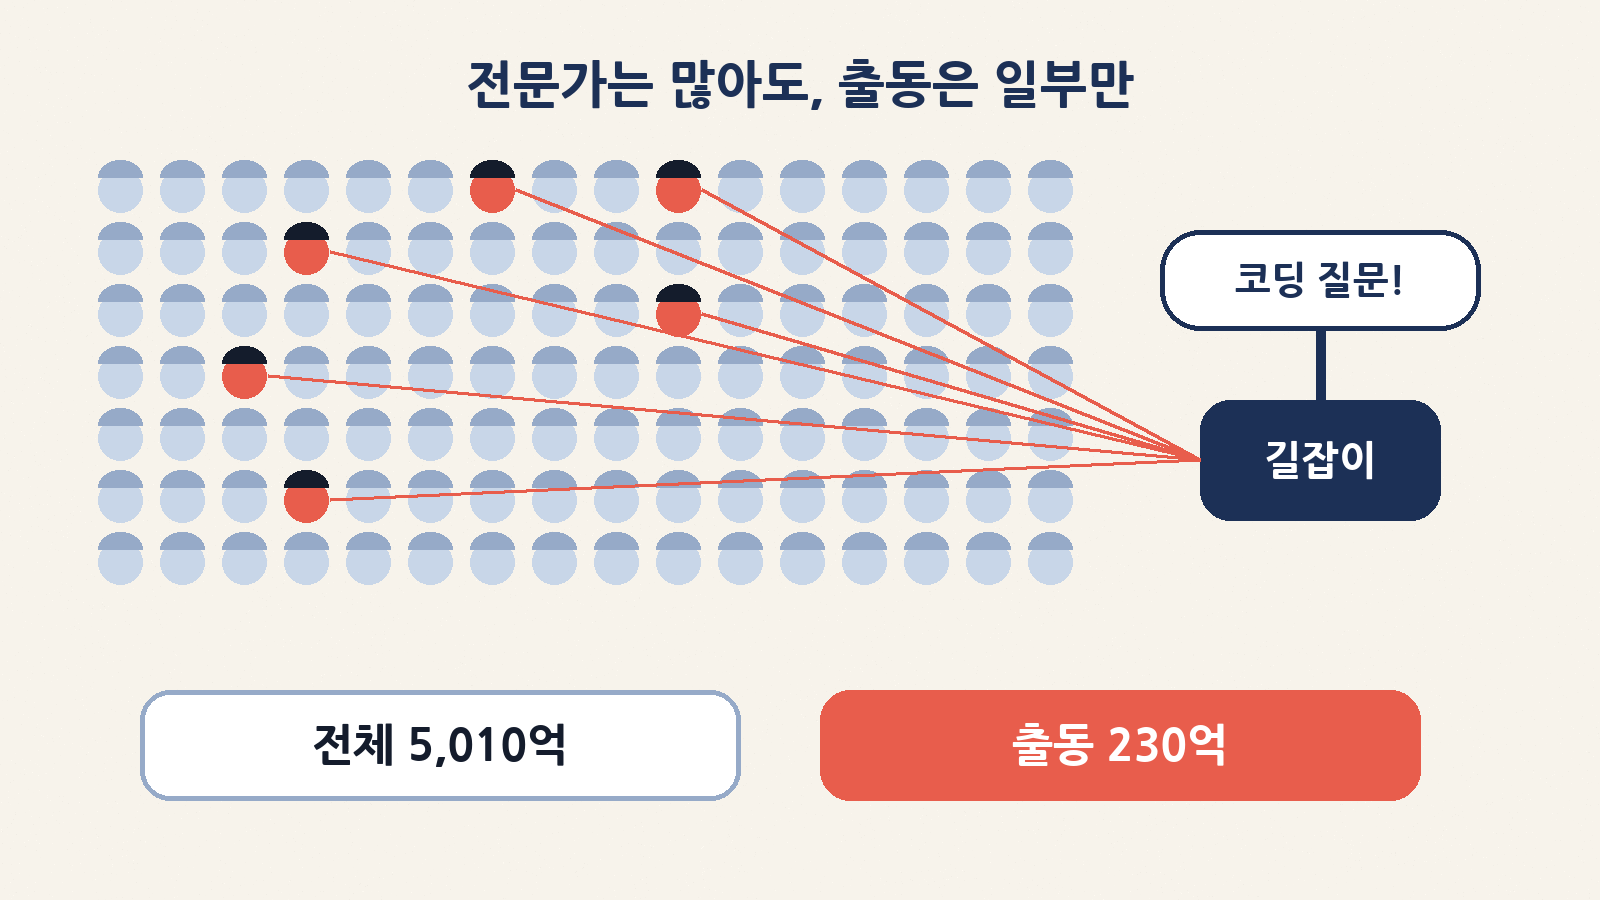
빔은 전문가 혼합(MoE, Mixture-of-Experts)이라는 구조를 써요. 큰 병원을 떠올려 보세요. 병원에는 수많은 전문의가 있지만, 환자가 오면 접수처가 증상에 맞는 의사 몇 명만 불러요. 모든 의사가 동시에 진료하면 시간도 돈도 많이 들겠죠.
빔도 똑같아요. 안에 5,010억 개의 매개변수가 여러 ‘전문가’ 묶음으로 나뉘어 있고, 질문이 들어오면 길잡이(라우터)가 알맞은 전문가만 골라 깨워요. 그래서 실제로 한 번에 계산하는 건 230억 개 정도예요. 덕분에 지식은 크게, 계산은 가볍게 가져갈 수 있어요.
리플렉션은 여기에 더해 ‘짧게 생각해도 맞히면 상’을 주는 방식으로 훈련했다고 설명해요. 쓸데없이 길게 고민하는 버릇을 줄여, 같은 문제를 더 적은 계산으로 풀게 한 거죠. 쓰는 사람이 ‘추론 강도’를 조절해서 쉬운 일엔 짧게, 어려운 일엔 길게 생각하도록 고를 수도 있다고 해요.
성적은 어느 정도일까?
리플렉션이 직접 공개한 점수 중 몇 가지를, 비교 대상으로 자주 언급된 중국 지푸(Z.ai)의 GLM 5.2와 나란히 놓아 봤어요.
| 시험 (무엇을 보나) | 빔 | GLM 5.2 |
|---|---|---|
| SWE-Bench Pro v1 (실제 코드 버그 고치기) | 65.5 | 62.1 |
| Terminal-Bench 2.1 (명령창에서 작업 처리) | 80.1 | 81.0 |
| MCP Atlas (도구 연결해 쓰기) | 78.7 | 77.8 |
| GPQA Diamond (대학원 수준 과학 문제) | 90.5 | 91.2 |
보시다시피 비슷하게 주고받는 수준이에요. 리플렉션이 강조하는 건 점수 자체보다 효율이에요. 어려운 추론 문제에서 GLM 5.2와 비슷한 점수를 내면서 계산량은 3~4배 적게 쓴다고 주장해요. 덧붙이면 GLM 5.2는 전체 약 7,440억 개 중 400억 개를 쓰는 모델이에요. 반면 회사 스스로도 키미 K3(Kimi K3) 같은 최상위 오픈 모델이 순수 실력에선 아직 앞선다고 인정했어요.
우리에게는 어떤 의미일까?
- 선택지가 늘어나요 — 보안이나 규제 때문에 중국산 모델을 쓰기 꺼리던 기업·기관에게 미국산 오픈 모델이라는 대안이 생겨요.
- ‘우리만의 AI’가 쉬워져요 — 리플렉션은 기관이 자기 데이터로 맞춤형 AI를 만들어 자체적으로 운영하는 ‘AI 팩토리’를 내세우고 있어요. 미국 테크크런치 보도에 따르면 한국의 신세계그룹과 이런 ‘소버린(자국형) AI 팩토리’ 협력을 시험하기 시작했다고 해요.
- 값싼 AI 경쟁이 붙어요 — 비슷한 실력을 더 적은 계산으로 낸다는 주장이 사실로 확인되면, AI 서비스 운영비가 내려가는 데 힘을 보탤 수 있어요.
아직은 조심해서 볼 점
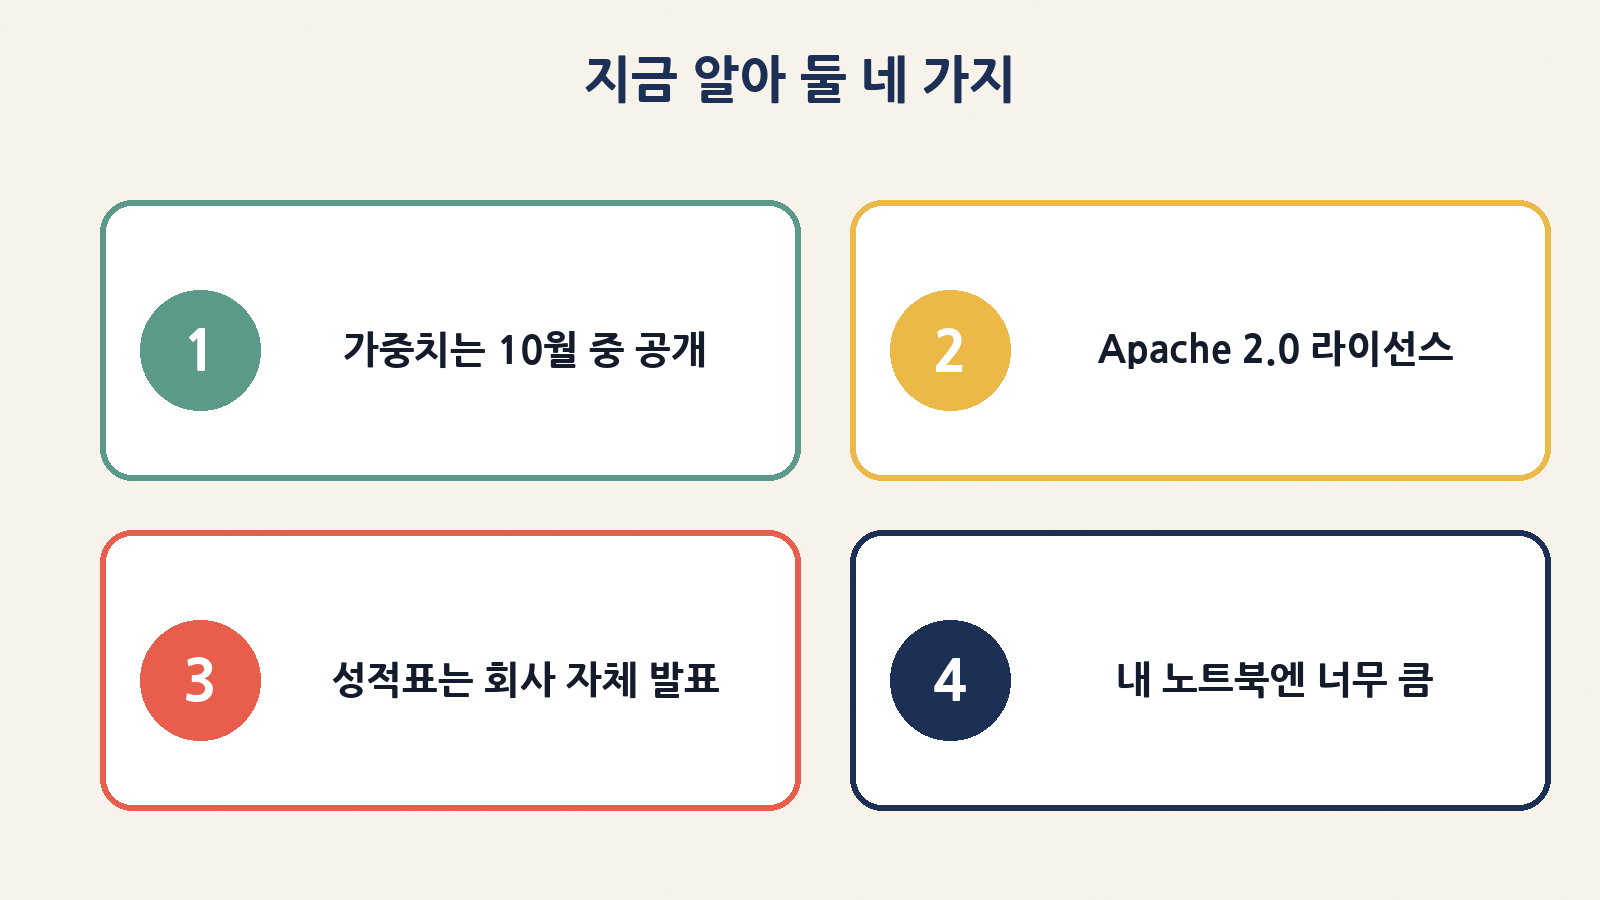
- 아직 ‘공개 예정’이에요 — 지금은 최종 안전 점검(레드팀)과 평가 중이고, 가중치는 이달 안에 공개한다고 했어요. 실제로 풀리기 전까진 대기자 명단으로만 써 볼 수 있어요.
- 성적표는 회사가 직접 매긴 거예요 — 외부에서 독립적으로 검증된 점수가 아니에요. 계산량 비교도 회사가 추정한 값이라, 가중치 공개 뒤 다른 개발자들의 실사용 평가를 지켜봐야 해요.
- 텍스트 전용이에요 — 사진이나 음성을 직접 이해하는 모델은 아니에요. 같은 미국 오픈 모델인 싱킹 머신즈 랩의 ‘잉클링(Inkling)’은 이미지도 다루는 멀티모달 모델이에요.
- 내 노트북으로는 무리예요 — 230억 개만 일한다 해도 5,010억 개 전체를 메모리에 올려 둬야 해서, 일반 PC가 아니라 데이터센터급 GPU 서버가 필요한 크기예요. 개인은 나중에 클라우드 서비스를 통해 써 보는 쪽이 현실적이에요.
마무리: AI 두뇌를 ‘빌려 쓰기’에서 ‘받아 쓰기’로
빔은 AI 업계가 닫힌 모델과 오픈 모델, 미국과 중국으로 나뉘어 치열하게 경쟁하고 있다는 걸 잘 보여 주는 소식이에요. 오늘 기억해 둘 건 세 가지예요. 오픈 웨이트는 AI의 ‘레시피 노트’를 공개하는 것, 전문가 혼합은 필요한 전문가만 불러 일하는 구조, 그리고 빔의 진짜 실력은 이달 가중치가 풀린 뒤에야 제대로 판가름 난다는 점이요. 모릭월드가 공개 소식이 나오면 또 쉽게 풀어 드릴게요.