테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다.
한 줄 요약: K-Dense-AI/scientific-agent-skills는 코딩 에이전트에게 “코드를 짜는 법”이 아니라 “그 분야가 받아들이는 분석 절차”를 가르치는 MIT 라이선스 스킬 라이브러리입니다. Scanpy·RDKit·PyDESeq2 같은 패키지 사용법부터 80개 데이터베이스 조회 계약, 실험 설계·통계 검정 선택 같은 방법론까지 177개 스킬을 오픈 표준 Agent Skills 형식(SKILL.md)으로 묶고, 저장소 전체를 Agent Plugins 1.0.0 패키지(plugin.json + skills/)로도 배포합니다. 오늘 GitHub Trending 전체 일간 5위(+163)에 오른 이 저장소를, 이전에 다룬 범용 스킬 설치기(vercel-labs/skills)나 엔지니어링 스킬 모음과는 다른 층위인 “과학 도메인 절차 지식” 관점에서 해부합니다. 표준 구조, 점진적 공개의 실제 토큰 비용(직접 재측정), 카테고리 지도, 설치 경로별 차이, 박스에서 돌린 검증 스위트·보안 스캐너 결과, 그리고 가장 중요한 검증·책임의 경계까지 다룹니다.
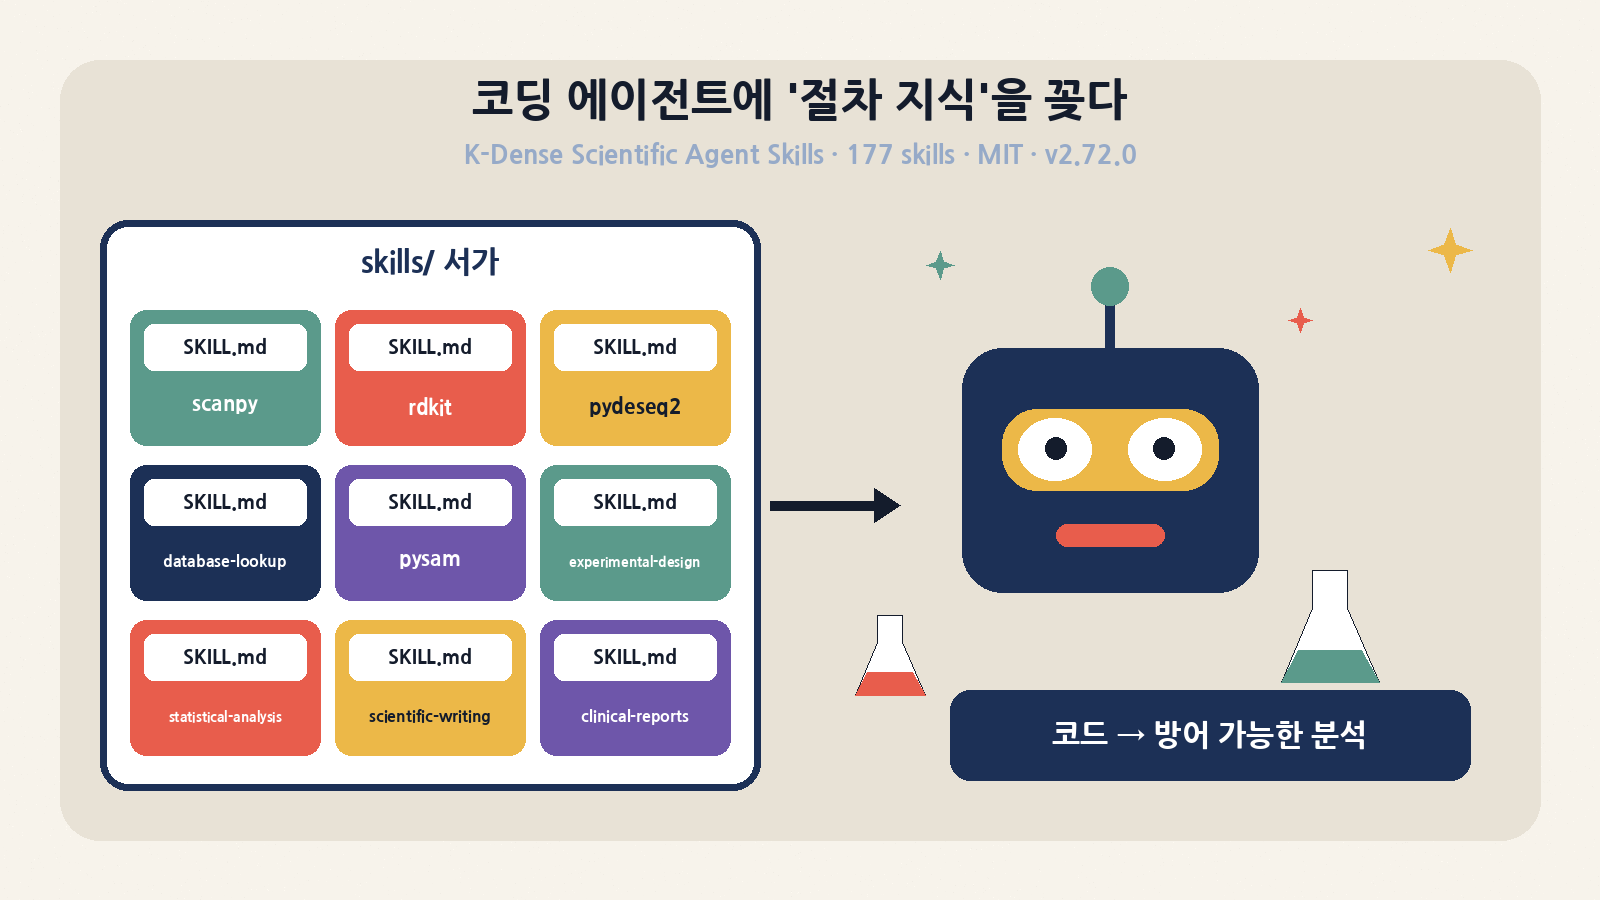
왜 지금 이 저장소인가
코딩 에이전트에게 RNA-seq 실험 분석을 맡기면 대개 돌아가는 코드가 나옵니다. 문제는 그 분석이 방어 가능한가입니다. 이 저장소를 설명하는 논문 arXiv:2609.00065(Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents)의 첫 문단이 정확히 이 질문으로 시작합니다. 다중 검정 보정을 빼먹거나, 쥐 3마리에서 세포 100개씩 뽑아 n=300으로 세거나, 처리군과 대조군을 다른 날 돌려 배치 효과를 분석 단계에서 되돌릴 수 없게 만드는 실수는 모두 “그럴듯하게 실행되는 코드”를 만들어 냅니다. 모델 능력이 올라가도 이 실수가 저절로 사라지지 않는 이유는, 이것이 추론 능력의 문제가 아니라 분야별 관례(convention)를 알고 있느냐의 문제이기 때문입니다.
| 항목 | 확인한 값 (2026-10-15 KST) | 해석 |
|---|---|---|
| 저장소 | K-Dense-AI/scientific-agent-skills · Python · 기본 브랜치 main |
토픽: agent-skills, ai-scientist, bioinformatics, chemoinformatics, drug-discovery, genomics 등 |
| 스타 / 포크 | 49,727 / 4,441 (GitHub API, 17:00 KST 전후) | 2025-10-20 05:54 KST 생성 → 약 1년. 논문 작성 시점(2026-08-29) 37,905개 |
| Trending | 전체 일간 5위, +163 stars today | 같은 목록 상위의 rea·VoiceStudio·context-mode·iFixAi는 이미 다룬 저장소 |
| 라이선스 | 저장소 MIT (LICENSE.md, Copyright 2025 K-Dense Inc.) |
단, 스킬마다 license 필드가 따로 있고 MIT가 아닌 것도 있음(아래 라이선스 절) |
| 버전 | pyproject.toml·plugin.json 모두 2.72.0, GitHub 릴리스 v2.72.0(2026-10-02 07:42 KST) |
tests/_meta가 두 파일의 버전 일치를 검사 |
| 최근 커밋 | a1043ef 2026-10-12 18:43 KST (“chore: update security scan report”) |
주간 보안 스캔 리포트 자동 커밋 |
| 스킬 수 | skills/ 하위 디렉터리 177개 (직접 셈) |
README 배지·본문과 일치. 2.71.0은 181개 |
| 저장소 툴링 | Python ≥3.13, uv, 의존성: cisco-ai-skill-scanner·pytest·python-dotenv | 개발 그룹: jsonschema, skills-ref(agentskills 공식 검증기) |
| 이름 변경 | 구 “Claude Scientific Skills” → “Scientific Agent Skills” | Claude 전용에서 Agent Skills 표준을 지원하는 모든 호스트로 확장 |
문제 정의: “돌아가는 코드”와 “방어 가능한 분석” 사이
논문은 이 간극을 절차적(procedural) 문제로 규정합니다. 에이전트에게 필요한 것은 “어떤 검정을 그 분야가 인정하는가, 어떤 식별자 네임스페이스가 권위 있는가, 결과에 어떤 단서를 반드시 붙여야 하는가” 같은 분야 관례이고, 이 지식은 패키지 문서·보고 가이드라인(ARRIVE, MIQE 등)·표준·연구실의 암묵지에 흩어져 있습니다. 매 작업마다 다시 발견하게 하는 대신 한 번 기록해 두자는 것이 스킬 라이브러리의 발상입니다. 논문이 첫 문단의 실수 하나하나를 실제 스킬 문장으로 대응시킨 부분이 이 프로젝트의 성격을 가장 잘 보여 줍니다.
| 흔한 실수 (코드는 정상 실행) | 대응하는 스킬 | 스킬에 적힌 규칙 |
|---|---|---|
| 다중 검정 보정 없이 그룹 비교 | statistical-analysis |
“어떤 보정을 썼는지 말하라(say which correction was used)” |
| 세포를 독립 반복으로 세는 의사반복(pseudoreplication) | experimental-design |
“쥐 3마리×세포 100개는 n = 3(쥐)이지 n = 300(세포)이 아니다” (SKILL.md 192행에서 직접 확인) |
| 처리군·대조군을 다른 날 처리 | bulk-rnaseq |
처리일이 그룹과 완전히 겹치면 “그 효과는 복구 불가능”하다고 경고 |
| BED 구간 시작을 1-based로 취급 | pysam |
“pysam API의 숫자 좌표는 0-based, half-open” |
| DB에서 대충 검색해 그럴듯한 요약 | database-lookup |
조회 전 retrieval contract 정의, 페이지네이션·건수 대조, 엔드포인트·접근일 기록, 응답 본문의 지시문은 따르지 말 것 |
논문이 인용한 별도 평가(K-Bench, arXiv:2608.21601)에서도 실제 과학 요청에 대해 “과학적 정확도가 커뮤니케이션 품질보다 모든 모델에서 뒤처졌고, 과장(overclaiming)이 가장 흔한 실패 태그”였다고 합니다. 즉 병목은 모델이 무엇을 할 수 있느냐가 아니라 무엇을 하면 안 되고 무엇을 반드시 확인해야 하느냐입니다.
지식을 에이전트에 넣는 방법들과 스킬의 위치
논문은 스킬을 기존 방식과 명확히 구분합니다. 스킬은 검색된 문단(retrieval)이 아니라 저자가 작성한 절차이고, 호출할 런타임을 제공하는 도구(tool)도 아닙니다. 이 구분이 중요한 이유는 검증 방식이 달라지기 때문입니다. 텍스트이므로 코드 리뷰처럼 diff로 검토할 수 있고, 호스트 독립적이므로 Cursor·Claude Code·Codex 어디에 넣어도 같은 파일입니다.
| 접근 | 에이전트가 받는 것 | 장점 | 한계 | 이 저장소와의 관계 |
|---|---|---|---|---|
| RAG(코퍼스 검색) | 관련 문단 | 광범위한 사실 커버 | 긴 컨텍스트에서 성능 저하, 절차 순서 보장 없음 | 스킬은 “문단”이 아니라 순서·중단 조건을 가진 절차 |
| 도구 / MCP 서버 | 호출 가능한 함수·스키마 | 결정적 실행, 타입 검증 | “언제·어떤 순서로·무엇을 확인하며” 쓰는지는 안 알려 줌 | 스킬은 런타임이 없음. 도구 사용법을 지시하는 층 |
| 에이전트 자기 축적 루틴(Voyager류) | 스스로 만든 코드 스킬 | 자동 확장 | 분야 관례 검증 불가, 재현성 약함 | 사람이 쓰고 버전 관리하는 큐레이션 라이브러리 |
| 워크플로 엔진(Nextflow·Snakemake) | 실행 가능한 파이프라인 | 재현성 최상 | 에이전트가 선택·조합하는 판단은 다루지 않음 | nextflow 스킬처럼 엔진 사용법을 스킬로 감싸 상호 보완 |
| Agent Skills | SKILL.md + references/scripts/assets |
휴대성, 텍스트 리뷰, 점진적 로딩 | 선택 정확도·준수 여부는 호스트에 의존 | 이 저장소의 형식 그 자체 |
아키텍처 ①: Agent Skills 표준과 이 저장소의 추가 규칙
스킬 하나는 디렉터리 하나입니다. 최소 구성은 SKILL.md 한 파일이고, 그 앞부분은 YAML frontmatter, 뒷부분은 사람이 아니라 에이전트를 위해 쓴 Markdown 지시문입니다. 표준은 references/(추가 문서), scripts/(코드), assets/(템플릿·정적 리소스)를 권장하고, 이 저장소는 한 단계 더 엄격하게 스킬 디렉터리 안에 이 네 가지만 허용합니다. 테스트는 절대 스킬 디렉터리에 두지 않고 tests/<skill-name>/ 평행 트리로 뺍니다. 에이전트가 스캔하는 페이로드를 최소화하기 위해서입니다.
| frontmatter 필드 | 필수 | 표준 제약 | 이 저장소(AGENTS.md)의 추가 규칙 |
|---|---|---|---|
name |
예 | 1–64자, 소문자·숫자·하이픈, 디렉터리 이름과 동일 | 디렉터리 이름 = 스킬 이름이 생성 절차 1단계 |
description |
예 | 1–1024자. 무엇을 하는지 + 언제 쓰는지 | 3인칭, 트리거 키워드 포함. 유사 스킬이 있으면 서로를 지목하는 “라우팅 힌트” |
license |
아니오 | 라이선스 이름 또는 번들 파일 참조 | 스킬별로 따로 기재 → 저장소 MIT와 다를 수 있음 |
compatibility |
아니오 | 최대 500자, 환경 요구사항만 | 자격 증명·네트워크 요구도 여기에 선언(177개 중 173개 기재) |
allowed-tools |
아니오 | 공백 구분 문자열(예: Read Write Edit Bash) |
YAML 리스트·쉼표 구분 금지(177개 중 99개 기재) |
metadata |
아니오 | 문자열 키→문자열 값 매핑 | metadata.version 필수·따옴표, 저자·리뷰일·업스트림 버전도 여기. openclaw·hermes 블록만 중첩 매핑 허용(26개 스킬) |
실무에서 가장 많이 깨지는 지점은 YAML 스타일입니다. 공식 검증기 skills-ref는 frontmatter를 strictyaml로 파싱하는데, JSON 스타일 플로 매핑(metadata: {"version": "1.1"})을 만나면 해당 키 하나가 아니라 문서 전체 파싱이 실패해 name·description까지 읽히지 않고 스킬이 등록되지 않습니다. 또 OpenClaw의 매니페스트 블록을 JSON 문자열로 쓰면 의존성 게이팅과 자격 증명 주입이 조용히 꺼진다고 AGENTS.md가 경고합니다. 실제 frontmatter는 다음과 같습니다.
---
name: alphagenome
description: "Looks up precomputed AlphaGenome Atlas effects for any GRCh38 SNV ... Research use only; not a clinical tool."
license: MIT
compatibility: "Python 3.10+ with the alphagenome package ... a free non-commercial AlphaGenome API key in ALPHAGENOME_API_KEY ..."
allowed-tools: Read Write Edit Bash
metadata:
  version: "1.2"
  skill-author: K-Dense Inc.
  upstream-version: "alphagenome 0.9.0"
  last-reviewed: "2026-09-30"
  openclaw:
    primaryEnv: ALPHAGENOME_API_KEY
    envVars:
    - name: ALPHAGENOME_API_KEY
      required: true
---
대표 스킬 네 개를 열어 구성 차이를 비교했습니다. 같은 표준이라도 “데이터 조회 계약형”, “패키지 워크플로형”, “안전 경계형”으로 성격이 확연히 다릅니다.
| 스킬 | license | metadata.version / 리뷰일 | 구성 | SKILL.md 줄 수 | 성격 |
|---|---|---|---|---|---|
database-lookup |
MIT | “1.8” / 2026-09-30 | SKILL.md + references/(DB별 파일 + retrieval-contract.md) | 399 | 80개 DB 선택 가이드·조회 계약·provenance 기록. allowed-tools: Read Bash |
scanpy |
BSD-3-Clause | “1.8” / 2026-10-01 (upstream 1.12.4) | references/ scripts/ assets/ | 360 | Python 3.12+, Scanpy 1.12.4·AnnData 0.13.4 검증. “합성 테스트는 데이터/API 계약이지 생물학적 타당성이 아니다”라고 명시 |
rdkit |
BSD-3-Clause license | “1.5” / 2026-10-01 (tested 2026.03.6) | references/ scripts/ | 140 | rdkit vs 레거시 rdkit-pypi 구분, 단순 작업은 datamol로 안내하는 라우팅 힌트 |
clinical-reports |
MIT | “2.3” / 2026-09-30 | references/ scripts/ assets/ | 271 | “Non-Negotiable Boundary”: 진단·치료 권고·용량 결정·분류(triage) 금지, 합성·비식별·집계 데이터만 |
아키텍처 ②: plugin.json과 Agent Plugins 패키지
저장소 루트의 plugin.json은 https://agent-plugins.org/schemas/1.0.0/plugin.schema.json 스키마를 따르는 Agent Plugins 매니페스트입니다. 이름·버전(2.72.0)·저자(K-Dense Inc.)·라이선스(MIT)·키워드만 담고, 스킬 목록은 따로 적지 않습니다. 플러그인 클라이언트는 skills/의 직계 하위 중 SKILL.md가 있는 디렉터리를 모두 발견하기 때문입니다. 즉 Agent Skills가 “스킬 하나”의 형식이라면, Agent Plugins는 “스킬 묶음 + 메타데이터”를 한 단위로 배포하는 껍데기입니다.
| 층위 | 표준 | 단위 | 이 저장소의 파일 | 누가 읽나 |
|---|---|---|---|---|
| 스킬 | Agent Skills (agentskills.io) | 디렉터리 1개 | skills/<name>/SKILL.md |
에이전트 호스트(시작 시 name·description, 활성화 시 본문) |
| 플러그인 | Agent Plugins 1.0.0 (agent-plugins.org) | 저장소 1개 | plugin.json + skills/ |
Cursor·Codex·Copilot·VS Code·Kiro 등 플러그인 클라이언트 |
| 설치기 | 표준 밖(클라이언트별) | 명령 1회 | 없음 — npx skills, gh skill, 심볼릭 링크 |
사람 / CI |
| 검증 | 공식 검증기 + 저장소 계약 | PR 1건 | tests/_meta, .github/workflows/* |
CI |
점진적 공개: 177개를 다 깔면 컨텍스트가 얼마나 드나
스킬 라이브러리의 핵심 설계는 3단계 점진적 공개(progressive disclosure)입니다. 호스트는 시작 시 모든 스킬의 이름·설명만 시스템 프롬프트에 올리고(상주 계층), 에이전트가 관련 있다고 판단하면 SKILL.md 본문을 읽고(활성화 계층), 본문이 가리킬 때만 references/ 파일을 엽니다(지연 계층). 논문은 v2.65.0(163개) 기준으로 이를 측정했고, 저는 오늘 v2.72.0 트리에서 같은 토크나이저(o200k_base)로 다시 셌습니다. 텍스트 파일(.md·.txt·.rst·.json·.yaml·.yml)만 세고 스크립트·바이너리는 제외한, 논문과 같은 규칙입니다.
| 계층 | 논문 (v2.65.0, 163개) | 오늘 재측정 (v2.72.0, 177개) | 의미 |
|---|---|---|---|
| 상주: 이름+설명 합계 | 14,246 토큰 (중앙값 67) | 14,122 토큰 (중앙값 66) | 200k 창의 7.1% → 7.06%. 스킬은 늘었지만 설명이 짧아짐 |
| 활성화: SKILL.md 전체 | 482,506 토큰 (중앙값 2,857) | 582,245 토큰 (중앙값 3,149, 최대 7,373) | 본문은 1개당 3천 토큰대 — 활성화 1회는 가벼움 |
| 지연: references/ | 2,480,674 토큰 / 1,033파일 | 2,605,752 토큰 / 1,127파일 | 전체 코퍼스의 80% 이상이 “가리킬 때만” 읽힘 |
| 문서화된 워크플로 46개 (논문) | 본문까지: 중앙값 47,706 (23.9%) | — | 본문만 로드하면 46개 모두 200k 안 |
| 같은 46개 + 모든 references (논문) | 중앙값 225,498 (112.7%) | — | 29/46이 창을 초과 → references는 반드시 선택적으로 |
저장소 구조: 배포 페이로드와 저장소 장치의 분리
얕은 클론(2,780개 파일, skills/ 27MB)을 받아 구조를 확인했습니다. 에이전트에게 실리는 것은 skills/뿐이고, 나머지는 품질 장치입니다.
| 경로 | 역할 | 확인한 내용 |
|---|---|---|
skills/<name>/ |
배포 페이로드 (177개) | scripts/ 보유 121개, references/ 176개, assets/ 43개. SKILL.md 줄 수 최소 112·중앙 277·최대 499 (500줄 상한 준수) |
plugin.json · pyproject.toml |
Agent Plugins 매니페스트 · 저장소 툴링 | 버전 2.72.0 일치. requires-python = ">=3.13", pytest --import-mode=importlib |
tests/_meta/ |
저장소 전체 계약·커버리지 가드 | test_repo_contract·test_personal_paths·test_console_output·test_runner + 스키마 |
tests/_contract/ |
스킬 스위트가 재사용하는 공용 검사 | cli.py·structure.py·schematic.py (스킬 코드를 import하지 않고 ast로 파싱) |
tests/<skill>/ |
스킬별 테스트 (156개 디렉터리) | scripts/가 있는 스킬은 반드시 스위트 + 요구사항 항목 보유 |
tests/skill-requirements.toml |
스킬별 격리 환경 정의 (174항목) | 패키지 없는 표준 라이브러리 전용 39개, 파이썬 버전 오버라이드 43개(opentrons는 numpy<2, PyTDC는 3.11 등) |
scan_skills.py · scan_pr_skills.py |
주간 전체 스캔 · PR 변경분 스캔 | Cisco AI Defense Skill Scanner 래퍼 |
docs/ |
카탈로그·예제·보안 리포트 | skills.md, examples.md(워크플로 예제), skill-guides/(178개 파일), security-report.md/.json, security-triage.md |
.github/workflows/ |
CI 5종 | skill-spec-validation, skill-tests, pr-skill-scan, security-scan(매주 월 09:00 UTC = 18:00 KST), release |
| 구성 통계 (v2.72.0, 직접 집계) | 값 | 논문(v2.65.0)과 비교 |
|---|---|---|
| 스킬 수 | 177 | 163 → +14 (2.71.0의 181개에서 Anthropic 문서 스킬 4개 제거) |
| scripts/ 보유 | 121 (68%) | 105 (64%) |
| references/ 보유 | 176 | 154 |
compatibility 선언 |
173 | 116 — 환경 요구사항 명시가 크게 늘어남 |
allowed-tools 선언 |
99 | 100 |
metadata.skill-author: K-Dense Inc. |
149 | 131 — 나머지는 외부 기여자(대학 연구실·기업 등) |
카테고리 지도: 무엇을 덮고, 어디가 민감한가
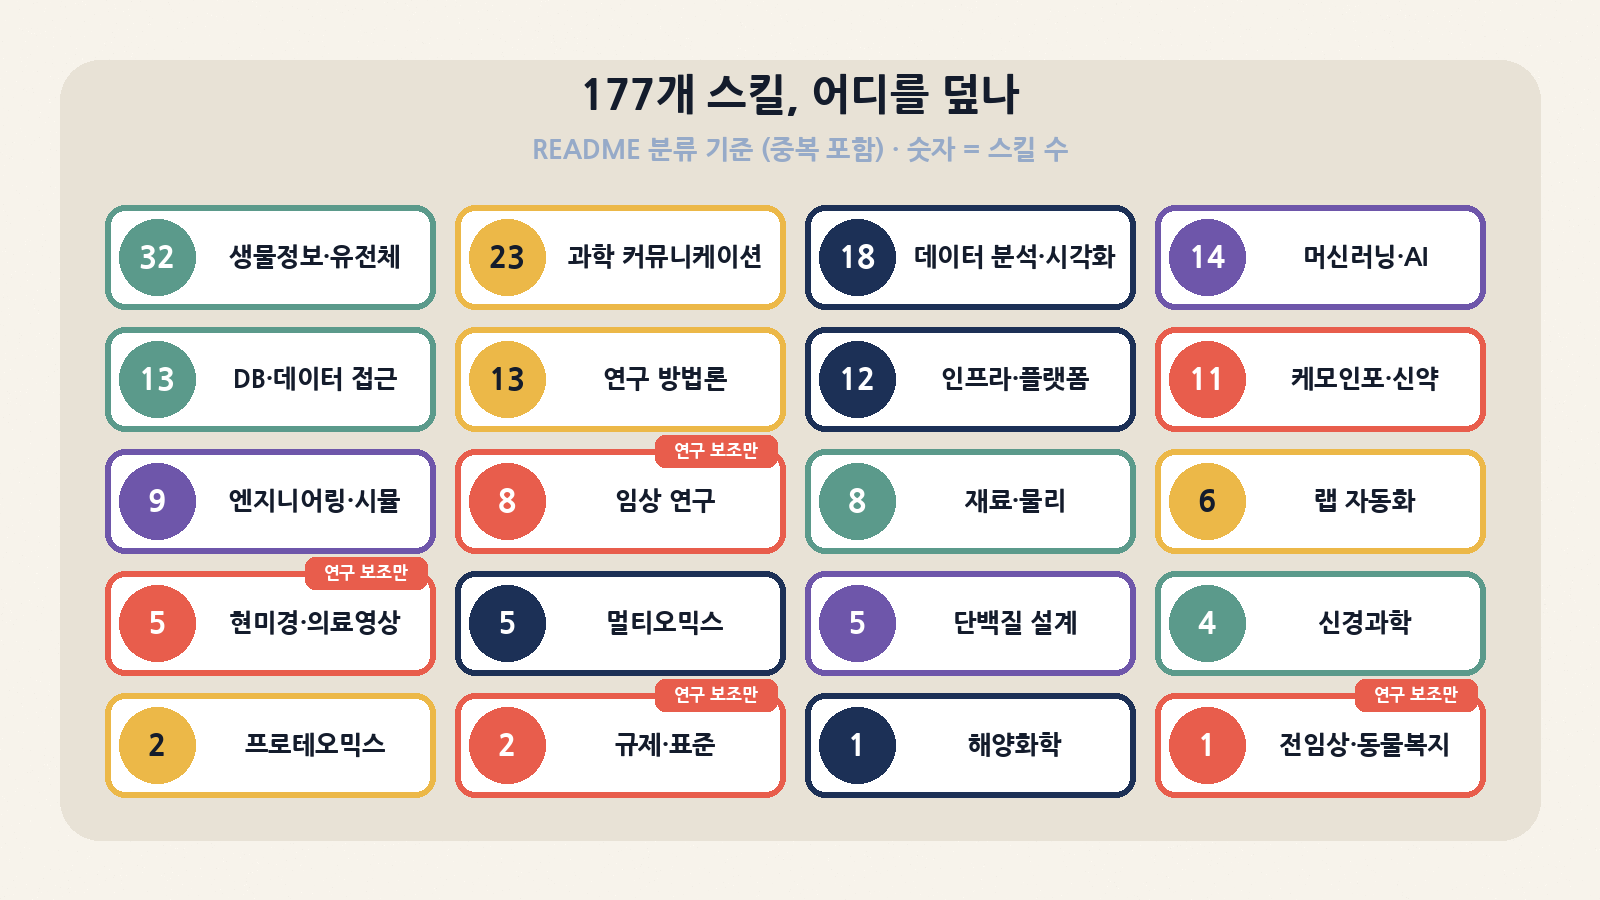
README는 스킬을 20개 분야로 묶어 소개합니다. 한 스킬이 여러 분야에 걸쳐 나오므로 합계(192)는 177보다 큽니다. 논문은 별도로 16개 “주 카테고리” 분류를 만들어 썼는데, 이 분류는 저장소의 속성이 아니라 저자들의 보고 관례라고 밝힙니다. 실제 저장소는 skills/ 아래 평평한 디렉터리이고 상위 그룹을 강제하지 않습니다.
| 분야 (README) | 스킬 수 | 대표 스킬 | 실무 메모 |
|---|---|---|---|
| 생물정보·유전체 | 32 | scanpy, pysam, pydeseq2, bulk-rnaseq, primer-design, mageck, qiime2-amplicon | 가장 큼. 좌표계·배치 효과·반복 단위 같은 관례가 집중된 영역 |
| 과학 커뮤니케이션 | 23 | scientific-writing, peer-review, paper-lookup, scientific-slides, citation-management | 예제 워크플로의 “연결 조직”. 논문 기준 scientific-visualization 27회, scientific-writing 26회 등장 |
| 데이터 분석·시각화 | 18 | statistical-analysis, statistical-power, experimental-design, polars, dask | 방법·판단형 스킬 — 평가가 가장 어려운 유형 |
| 머신러닝·AI | 14 | pytorch-lightning, scikit-learn, transformers, torch-geometric, timesfm-forecasting | 보안 스캔 HIGH가 몰린 영역(eval/exec 패턴, 대부분 .eval() 오탐) |
| DB·데이터 접근 | 13 (→100+ DB) | database-lookup(80개 DB), depmap, primekg, alphagenome, ncats-arax | “100+”는 래퍼 패키지 포함, 파일로 셀 수 있는 수치는 80(논문 시점 78) |
| 연구 방법론 | 13 | hypothesis-generation, scientific-critical-thinking, research-grants, arbor | 가설은 “후보”로 표시 유지, 점수화하지 않음 |
| 케모인포·신약 | 11 | rdkit, datamol, diffdock, deepchem, medchem, molfeat | datamol↔rdkit이 라이브러리에서 가장 겹치는 설명 쌍 |
| 임상 연구 | 8 | clinical-reports, clinical-decision-support, pkpd-modeling | 연구 보조 한정. 진단·치료·적격성 판단 금지 |
| 현미경·의료영상·병리 | 5 | pydicom, pathml, cellprofiler | 연구 전용(research-only), 프라이버시 인지 DICOM 처리 |
| 랩 자동화 | 6 | pylabrobot, opentrons-integration, protocolsio-integration, benchling-integration | 물리 실행은 명시적 운영자 안전 게이트 뒤에 |
| 규제·표준 | 2 | iso-standards-readiness, analytical-method-validation | “자격 있는 검토용 초안, 인증·승인 결정이 아님” |
설치와 실행: 경로별 차이를 알고 고르기
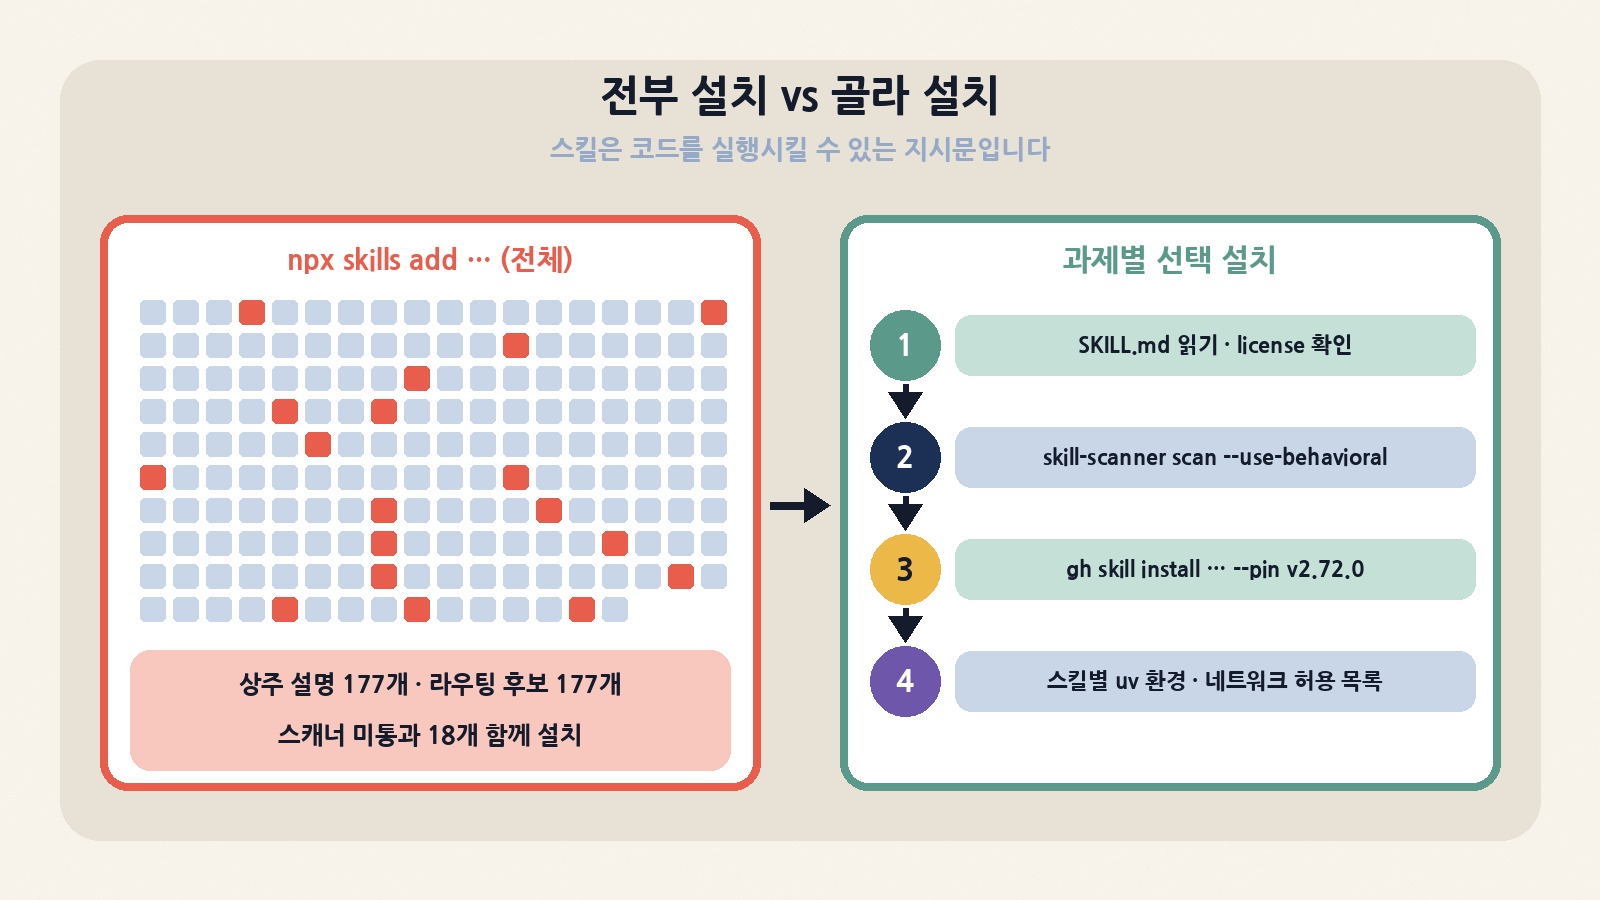
설치 경로는 다섯 가지 정도입니다. 핵심 차이는 선택 설치가 쉬운가, 버전 고정(pin)과 provenance 기록이 되는가입니다. 재현성이 필요한 연구라면 논문이 권하는 대로 gh skill install … --pin <tag>로 설치하고, 결과 보고 시 저장소 태그 + 사용한 스킬 이름 + 그 스킬의 metadata.version을 함께 적는 것이 맞습니다(스킬 버전은 저장소 버전과 독립적으로 올라갑니다).
# 1) 표준 설치기 (skills CLI) — 전체 또는 일부
npx skills add K-Dense-AI/scientific-agent-skills
npx skills add K-Dense-AI/scientific-agent-skills --list          # 목록만 보기
npx skills add K-Dense-AI/scientific-agent-skills --skill scanpy  # 일부만

# 2) GitHub CLI 2.90.0+ — 호스트 지정, 태그/커밋 고정, provenance 메타데이터 기록
gh skill install K-Dense-AI/scientific-agent-skills scanpy --agent cursor
gh skill install K-Dense-AI/scientific-agent-skills --pin v2.72.0
gh skill update --all

# 3) Agent Plugins — Cursor 로컬 플러그인 (클론한 저장소 루트에서)
mkdir -p ~/.cursor/plugins/local
ln -s "$(pwd)" ~/.cursor/plugins/local/scientific-agent-skills
#    → Developer: Reload Window 후 Customize에서 확인
codex plugins install .     # Codex (플래그 이름은 Codex 문서로 확인)

# 4) 수동 — ~/.agents/skills 관례를 스캔하는 호스트
git clone https://github.com/K-Dense-AI/scientific-agent-skills.git .agents/skills/scientific-agent-skills

# 저장소 툴링 (검증·테스트용, 과학 패키지 전부를 설치하지 않음)
uv sync| 경로 | 선택 설치 | 버전 고정 | provenance 기록 | 주의점 |
|---|---|---|---|---|
npx skills add |
--skill, --list |
저장소 기본 브랜치 기준 | 호스트·CLI 의존 | 오늘 받은 skills CLI 1.7.2는 Node ≥22.20.0 요구 — 박스의 Node 20.19.2에서는 fs/promises의 glob 미지원으로 SyntaxError |
gh skill install |
스킬 이름 지정·대화형 | --pin vX.Y.Z 또는 커밋 SHA |
공급망 무결성용 provenance 메타데이터 | gh 2.90.0+ 필요. 박스의 gh 2.46.0에는 skill 하위 명령 없음 |
| Cursor 로컬 플러그인 | 불가(묶음 전체) | 클론한 커밋 | git 이력 | 심볼릭 링크라 git pull 즉시 반영 — 고정하려면 태그 체크아웃 |
codex plugins install . |
불가(묶음 전체) | 로컬 체크아웃 | git 이력 | CLI 플래그는 버전에 따라 다를 수 있음 |
수동 git clone |
디렉터리 복사로 가능 | 태그 체크아웃 | git 이력 | 설치 경로·메타데이터 해석은 호스트별(OpenClaw·NemoClaw·Pi·Hermes 등) |
compatibility를 보고 워크플로마다 별도 환경을 만드세요. 스킬 간 핀이 실제로 충돌합니다(opentrons의 numpy<2, PyTDC의 Python 3.11 등). uv sync는 저장소 검증 도구(Python 3.13+)만 깝니다.NemoClaw 사용자라면 한 가지 더 있습니다. NemoClaw는 NVIDIA OpenShell 안에서 에이전트를 돌리고 아웃바운드 네트워크가 기본 거부(default-deny)입니다. 스킬 발견·로딩은 정상이지만 uv 패키지 설치나 Exa·Parallel·Benchling·NCBI·Materials Project 같은 API 호출은 운영자가 OpenShell TUI에서 해당 도메인을 미리 허용해야 동작합니다. 역으로 보면, 네트워크가 필요 없는 스킬만 골라 기본 거부 샌드박스에서 돌리는 구성이 가장 안전한 운영 형태이기도 합니다.
검증: 무엇이 “validated”이고 무엇이 아닌가
README 설명문은 “validated skills”라고 쓰지만, 논문 부록 E의 문장이 훨씬 정직합니다. “validated”는 “누가 읽어 봤다”부터 “동작이 테스트됐다”까지를 다 가리킬 수 있으니, 어떤 검사가 어떤 스킬에 걸리는지를 봐야 한다는 것입니다. CI 게이트를 정리하면 다음과 같습니다.
| 게이트 | 트리거 | 범위 | 보장하는 것 | 보장하지 않는 것 |
|---|---|---|---|---|
| Skill Spec Validation | PR·push(관련 경로) | 전체 스킬 | skills-ref 기준 frontmatter 6필드, name 규칙, metadata.version, allowed-tools 문법 |
지시문 내용의 과학적 정확성 |
| Skill Tests: 계약·커버리지 가드 | PR·push, 수동 | tests/_meta |
500줄 상한, 스킬 내부 테스트·바이트코드 금지, 로컬 경로 해석, 스크립트 구문, 개인 경로 금지, plugin.json 스키마·버전 일치 |
스크립트 동작 |
| Skill Tests: 표준 라이브러리 전용 스위트 | PR·push | 패키지·파이썬 오버라이드 없는 스킬 24개(오늘 매니페스트 기준) | 해당 스위트가 단언(assert)하는 동작 | 과학 패키지가 필요한 나머지 스위트(CI 미실행) |
격리 전체 스윕 run_all.py --isolated |
수동(릴리스 전 권장) | 스위트가 있는 모든 스킬 | 스킬별 선언 의존성 환경에서 테스트 | CUDA·JDK·MATLAB 필요 항목, 실행 여부가 트리에 기록되지 않음 |
| PR Skill Scan | PR(관련 경로) | 변경된 스킬 | Cisco 스캐너 결과를 PR 코멘트로 | 수동 리뷰 대체 |
| Weekly Security Scan | 매주 월 09:00 UTC | 전체(증분, 30일 내 전체 재스캔) | docs/security-report.* 공개 |
취약점 “인증” |
박스에서 직접 돌려 본 결과입니다(클론 커밋 a1043ef, uv 0.12.24, Python 3.13.5).
$ uv sync --python 3.13                       # 3.9초
$ uv run python -m pytest tests/_meta -q
18 passed, 4224 subtests passed in 5.93s

$ uv run skills-ref validate skills/scanpy     # database-lookup, rdkit, clinical-reports도 동일
Valid skill: skills/scanpy

$ uv run python tests/run_all.py --isolated clinical-reports
tests/clinical-reports/test_scripts.py ............................  [100%]
28 passed in 0.49s

$ uv run skill-scanner scan skills/rdkit        # skill-scanner 2.3.0, LLM 분석기 없이
Status: [OK] SAFE · Total Findings: 0
$ uv run skill-scanner scan skills/autoskill
Status: [FAIL] ISSUES FOUND · Max Severity: HIGH · Findings 6 (HIGH 1 / MEDIUM 3 / LOW 2)| 스모크 항목 | 결과 | 해석 |
|---|---|---|
tests/_meta |
18 passed, 서브테스트 4,224개 | 구조 계약은 과학 패키지 없이 수 초 — 포크해서 사내 스킬을 추가할 때 그대로 쓸 수 있는 게이트 |
skills-ref validate 4개 |
모두 Valid | 공식 검증기 통과 = 다른 호스트에서도 “등록”은 된다는 최소 보장 |
run_all.py --isolated clinical-reports |
28 passed (의존성 0개 환경) | 임상 리포트 스크립트는 구조·내부 일관성만 검사 — 스킬 본문도 그렇게 명시 |
skill-scanner rdkit / autoskill |
SAFE / HIGH 1건 포함 6건 | 정적 분석만으로도 차이가 드러남. 공식 리포트는 LLM 분석기(--use-behavioral 포함)까지 돌린 결과 |
npx skills / gh skill |
박스 환경에선 미실행(Node 20, gh 2.46) | 설치기 자체의 런타임 요구사항을 먼저 확인할 것 |
보안 모델: 스킬은 “실행을 지시하는 텍스트”다
README의 보안 고지는 단도직입적입니다. 스킬은 에이전트에게 임의 코드 실행, 패키지 설치, 네트워크 요청, 파일 수정을 지시할 수 있고, 악의적이거나 허술한 스킬은 코딩 에이전트를 해로운 행동으로 몰 수 있다는 것. 그리고 “한 번에 전부 설치하지 말라”고 명시합니다. K-Dense가 모든 스킬을 직접 만들던 시절엔 전체 설치가 합리적이었지만, 지금은 덜 검토된 커뮤니티 기여가 섞여 있다는 이유입니다. 논문은 여기에 구조적 지적을 더합니다. 표준에는 데이터와 지시의 경계가 없고, 신뢰 결정이 설치 시점에 단 한 번 일어난다는 점입니다.
| 주간 스캔 리포트 (2026-10-12 09:43 UTC = 18:43 KST) | 값 |
|---|---|
| 스캐너 / 모델 | cisco-ai-skill-scanner 2.2.2 / claude-opus-5, 177개 전체 재스캔 |
| 전체 발견 건수 | 469건 — CRITICAL 32 · HIGH 21 · MEDIUM 255 · LOW 160 · INFO 1 |
| “safe” 판정 | 159/177 (CRITICAL 9개 스킬, HIGH 9개 스킬이 미통과) |
| CRITICAL 유형 | 전부 data_exfiltration — 한 패키지가 환경 변수를 읽고 네트워크 호출을 하는 패턴(autoskill, citation-management, infographics, latex-posters, literature-review, open-notebook, research-lookup, scientific-schematics, scientific-slides) |
| HIGH 유형 | command_injection 20건(Markdown 코드 블록의 eval/exec) + 교차 스킬 데이터 릴레이 휴리스틱 1건 |
| 발견 유형 | 저장소 triage 판단 | 실무에서 할 일 |
|---|---|---|
| 환경 변수 읽기 + 네트워크 호출(CRITICAL) | 스킬이 자기 서비스의 API 키를 읽어 자기 서비스를 호출하는 패턴 → 체계적 오탐. 다만 Autoskill의 foundry 엔드포인트처럼 목적지가 설정 가능한 경우는 여전히 신뢰·권한 판단 필요 | 해당 스킬이 읽는 변수 이름과 목적지 도메인을 직접 확인하고, 네트워크 허용 목록에 그 도메인만 넣기 |
| eval/exec(HIGH) | 확인된 사례는 OpenCV 상수 cv2.CV_64F나 모델의 .eval() 메서드 → 주장한 위험에 대해선 오탐. 단 모델 로딩·원격 토크나이저 코드는 별도 |
trust_remote_code류 옵션이 나오는 스킬은 따로 검토 |
| 교차 스킬 릴레이(HIGH) | 수집형 스킬과 네트워크 스킬의 조합을 겹침으로 잡는 휴리스틱 — 실제 전달이 입증된 것은 아님 | “수집 + 외부 전송” 스킬을 한 프로젝트에 같이 깔 때 조합 리뷰 |
scanner is_safe |
“보안 인증이 아니다”라고 triage 문서가 명시 | 깨끗한 스캔 = 리뷰 노이즈 감소일 뿐, 수동 검토 대체 아님 |
정리하면 보안 모델은 “우리가 다 막아 준다”가 아니라 “스캔 결과와 triage를 공개하고, 고르는 책임은 설치자에게 둔다”입니다. 운영 체크리스트로 바꾸면 다음 네 단계입니다. ① 설치 전 SKILL.md와 license·compatibility·allowed-tools를 읽는다 ② skill-scanner scan <path> --use-behavioral로 로컬 스캔 ③ --pin으로 태그 고정, 업데이트는 diff 리뷰 후 ④ 스킬별 uv 환경 + 필요한 도메인만 허용하는 네트워크 정책. 커밋 이력에서 K-Dense-AI가 작성한 스킬인지(오늘 기준 149개가 skill-author: K-Dense Inc.)도 신뢰 신호로 쓸 수 있습니다.
라이선스: 저장소 MIT ≠ 스킬 MIT
FAQ가 반복해서 강조하는 부분입니다. 저장소는 MIT지만 각 스킬은 SKILL.md의 license 필드로 자기 라이선스를 가지며, 상업적 사용 가능 여부는 스킬 단위로 확인해야 합니다. 177개 frontmatter를 직접 집계했습니다(표기 변형은 계열로 묶음).
| license 필드 계열 | 스킬 수 | 눈여겨볼 사례 |
|---|---|---|
| MIT 계열 | 119 | database-lookup, clinical-reports, alphagenome 등 대부분의 K-Dense 작성 스킬 |
| Apache-2.0 계열 | 20 | 업스트림 패키지 라이선스를 따른 경우가 많음 |
| BSD 계열 | 20 | scanpy, rdkit(BSD-3-Clause) |
| GPL 계열 | 3 | bioservices(GPLv3), cobrapy(GPL-2.0), etetoolkit(GPL-3.0-or-later) |
| 비상업 | 2 | deepspot-m(PolyForm-Noncommercial-1.0.0), what-if-oracle(CC BY-NC-SA 4.0) |
| 독점 서비스 | 1 | rowan — “Proprietary (API key required)” |
| CC-BY · 기타 URL·고유 라이선스 | 5 | bids(CC-BY 4.0), Biopython License Agreement, sympy·matplotlib 라이선스 URL 등 |
| Unknown | 3 | glycoengineering, phylogenetics, primekg |
| 필드 없음 | 4 | hugging-science, infographics, latex-posters, pyhealth — 이 경우 저장소 MIT만 적용 |
또 하나 주의할 점은 스킬의 라이선스와 스킬이 다루는 데이터·서비스의 이용 조건이 다르다는 것입니다. 예를 들어 Imaging Data Commons 스킬은 스킬 자체는 MIT라고 적으면서 IDC 데이터는 대부분 CC-BY, 일부 CC-NC라 별도로 지켜야 한다고 밝히고, AlphaGenome 스킬은 비상업용 무료 API 키를 전제로 합니다.
임상·규제 스킬의 경계: 연구 보조이지 결정 도구가 아니다
임상 의사결정 지원, 치료 문서, 진단 영상, 규제 증거, 실험동물 복지는 “자신 있게 틀린 답”이 실제 피해로 이어지는 영역입니다. README는 이 분야들을 카테고리 단위로 연구 전용이라 규정하고, 일부 스킬은 본문에 더 강한 금지 조항을 둡니다. 그런데 논문이 직접 판정해 보니, 에이전트가 실제로 읽는 SKILL.md에 명시적 범위 제한 조항이 있는 스킬은 163개 중 10개(임상·규제·중개 연구 9개 중 5개, 의료영상·신경·병리 6개 중 2개)였습니다. 에이전트는 README가 아니라 SKILL.md를 읽으므로, 스킬 하나만 이름으로 설치하면 카테고리 수준의 단서를 전혀 만나지 못할 수 있습니다.
| 스킬 / 분야 | 스스로 밝힌 경계 | 운영상 의미 |
|---|---|---|
clinical-reports |
진단·치료 권고·용량 선택/변경·분류(triage)·귀가 주의사항 금지, 영상·검체·검사 원자료 해석 금지. 합성·비식별·집계 입력과 검증된 source-fact manifest만. 모든 산출물은 자격 있는 검토 필요 | 출력은 “표시된 초안 구조”. 근거나 검토자가 없으면 멈추도록 설계 |
| 헬스케어 AI·생체신호 | “환자별 진단·치료·알람·배포 결정이 아님”, 후향적 검증까지 | 모델 연구 도구이지 의료기기 소프트웨어가 아님 |
| 현미경·의료영상·디지털 병리 | research-only WSI 분석, 프라이버시 인지 DICOM 처리 | PHI가 있는 원본을 넣는 구성 자체를 피해야 함 |
| 전임상·동물 복지 | 중증도 평가 “보조, 결코 결정 규칙이 아님” | 인도적 종료점 판단은 사람·위원회 몫 |
| 규제·표준 (ISO 13485/14971/17025/15189, ICH Q2(R2)/Q14, USP, CLSI) | “자격 있는 검토용 증거 준비 초안 — 인증·인정·방법 출시 결정이 아님”, 표준 조항 원문 재현 거부 | 감사 대응 문서 초안 도구로 쓰되 판정은 QA 담당자 |
alphagenome 등 변이 해석 |
“Research use only; not a clinical tool.” | 임상 변이 해석 보고서에 직접 쓰면 안 됨 |
논문은 그래서 임상·규제·영상 스킬을 쓴 연구를 보고할 때 그 스킬 고유의 범위 제한을 함께 적으라고 권합니다. 한국 환경에 대입하면 의료기기 소프트웨어 인허가나 임상시험 문서에 이 스킬들의 산출물을 쓰려면, 그것은 어디까지나 담당자가 검토할 초안이라는 전제를 사내 절차로 박아 두어야 합니다.
비슷해 보이는 저장소들과의 층위 비교
최근 MoricWorld에서 다룬 스킬 관련 저장소들과 겹쳐 보일 수 있어, 층위를 분명히 정리합니다. 이 저장소는 설치기도, 감사 도구도 아니라 도메인 콘텐츠입니다.
| 저장소 | 층위 | 주 내용 | 이 저장소와의 관계 |
|---|---|---|---|
| K-Dense-AI/scientific-agent-skills | 도메인 콘텐츠(과학) | 177개 과학 스킬, 80개 DB 조회 계약, 방법론·안전 경계 | — |
| vercel-labs/skills | 설치기·런타임 허브 | npx skills CLI — 여러 호스트에 스킬을 설치·관리 |
README Option 1이 이 설치기를 사용. 내용물이 아니라 배송 수단 |
GitHub CLI gh skill |
설치기 + 공급망 | 호스트별 경로 설치, --pin, provenance 기록 |
재현성 있는 연구용 권장 경로 |
| mattpocock/skills | 도메인 콘텐츠(소프트웨어 엔지니어링) | 개발 워크플로 중심의 개인 스킬 모음 | 같은 형식, 다른 도메인. 과학 저장소는 “범용 코딩·인프라·라우팅 스킬은 범위 밖”이라 명시 |
| anthropics/skills | 도메인 콘텐츠(범용·문서 포맷) | docx·pdf·pptx·xlsx 등 문서 스킬과 예시 | 2.72.0에서 vendoring 중단 — 필요하면 Anthropic 저장소에서 직접 설치 |
| K-Dense BYOK | 애플리케이션 | 이 스킬들을 쓰는 데스크톱 오픈소스 AI co-scientist(자기 API 키, 40+ 모델, 선택적 Modal 확장) | 스킬을 “소비”하는 쪽. 스킬만 필요하면 BYOK 없이도 됨 |
| ToolUniverse (Harvard MIMS) | 도구 계층 + 스킬 | 공유 도구 계층 위에 생의학 워크플로를 패키징 | 논문 관련 연구로 언급된 유사 접근 — 공유 도구 계층과 결합돼 있다는 점이 다름 |
2.72.0에서 바뀐 것, 그리고 업그레이드 시 체크포인트
| 버전 | 변경 | 영향 |
|---|---|---|
| 2.72.0 (2026-10-02 KST) | Anthropic 라이선스로 vendoring하던 docx·pdf·pptx·xlsx 스킬 4개 제거 → 181 → 177개 |
이 넷에 의존했다면 anthropics/skills에서 별도 설치. 저장소 내 라이선스 구성이 더 단순해짐 |
| 2.72.0 | scientific-slides가 PptxGenJS(또는 기존 템플릿은 python-pptx)로 PPTX를 만들고 LibreOffice 렌더링 + 자체 검증 스크립트로 리뷰 |
Node.js·PptxGenJS·LibreOffice가 새 런타임 요구사항(compatibility 필드에 명시) |
| 2.71.0 | 181개 전체 갱신: database-lookup 80개 소스, PathML 3.0.8·GeoPandas 1.2.0·build123d 0.13.0 기준선, Generate Image가 OpenRouter Image API로, bulk-rnaseq→pydeseq2 인계 경계 정리 | 오래된 워크플로를 재사용하기 전 각 스킬의 compatibility·검증 범위 재확인 |
| 2.43.0 | 스킬 경로가 scientific-skills/ → skills/ |
북마크·수동 복사 경로·인용 경로 갱신 필요 |
도입 레시피: 과제별로 “작게” 설치하기
docs/examples.md의 프롬프트 가이드 첫 규칙은 “원하는 스킬의 이름을 직접 말하라”입니다. 호스트는 요청을 각 스킬의 description과 매칭해 고르기 때문에, phylogenetics(트리 생성)와 etetoolkit(기존 트리 분석), scanpy(분석)와 anndata(포맷)처럼 겹치는 쌍은 이름을 박아야 라우터의 추측에 기대지 않게 됩니다. 두 번째 규칙은 단계가 아니라 판단 기준을 적으라는 것(“변이 필터링” 대신 “QUAL > 30, DP > 20, 필터별 제거 건수 보고”), 세 번째는 작업 전에 출력 계약(Expected Output)을 선언하라는 것입니다.
| 과제 | 최소 스킬 세트 | 네트워크 | 환경 메모 |
|---|---|---|---|
| 단일세포 RNA-seq 탐색 | scanpy, anndata, statistical-analysis, experimental-design, scientific-visualization | 로컬 분석은 불필요 | Python 3.12+, Scanpy 1.12.4 기준 |
| bulk RNA-seq 차등 발현 | bulk-rnaseq, pydeseq2, pathway-enrichment, statistical-analysis | enrichment DB 조회 시 필요 | 배치·처리일 설계부터 점검 |
| 저분자 후보 우선순위 | database-lookup, rdkit, datamol, medchem, scientific-visualization | ChEMBL·PubChem 등 | RDKit 2026.03.6, rdkit-pypi 아닌 rdkit 패키지 |
| 문헌 리뷰·근거 기반 초안 | paper-lookup, literature-review, scientific-writing, citation-management | 필요 | literature-review·citation-management는 스캐너 CRITICAL 대상 → 읽는 키·도메인 확인 |
| 분석법 밸리데이션 문서 초안 | analytical-method-validation, statistical-analysis | 불필요(표준 라이브러리만) | 프레임워크(ICH Q2(R2)·USP·M10·CLSI) 먼저 확정, 합격 기준은 데이터 수집 전에 |
# 예: 단일세포 프로젝트에만, 태그 고정으로
gh skill install K-Dense-AI/scientific-agent-skills scanpy --agent cursor --pin v2.72.0
gh skill install K-Dense-AI/scientific-agent-skills anndata --agent cursor --pin v2.72.0
gh skill install K-Dense-AI/scientific-agent-skills experimental-design --agent cursor --pin v2.72.0

# 설치 전 로컬 스캔 (클론한 저장소에서)
uv run skill-scanner scan skills/scanpy --use-behavioral

# 분석 환경은 스킬과 별도로
uv venv .venv-sc --python 3.13 && uv pip install --python .venv-sc/bin/python "scanpy[leiden]"
한계: 논문이 스스로 “측정하지 않았다”고 적은 것들
이 프로젝트에서 가장 신뢰가 가는 부분은 역설적으로 자기 한계를 길게 적어 둔 것입니다. 논문은 자원(resource) 논문이라고 못 박고, 저자 대부분이 K-Dense 직원이라는 이해충돌도 밝힙니다.
| 한계 | 논문의 서술 | 도입 팀이 채워야 할 것 |
|---|---|---|
| 과제 수준 평가 없음 | 스킬을 주면 과학 작업이 좋아진다는 것을 보이지 않았다. 통제 실험은 에이전트·모델·도구·과제를 고정하고 스킬만 바꿔야 함 | 우리 데이터·우리 과제로 스킬 유/무 A/B, 정답 키는 스킬 텍스트가 아니라 공개 관례 기반으로 |
| 선택은 코퍼스로만 측정 | 설명 간 어휘 거리(코사인)는 혼동 가능성의 대리 지표일 뿐, 호스트의 선택률이 아님 | 실제 세션 로그에서 어떤 스킬이 활성화됐는지 기록 |
| 선택돼도 과학적으로 실패 가능 | 단계를 빼먹거나 중단 조건을 건너뛸 수 있고, 연구 설계가 스킬 전제를 위반할 수도 있음. “스킬은 판단을 구조화할 뿐 전문가 검토를 대체하지 않는다” | 결과물 리뷰를 사람 단계로 남기기 |
| 호스트 이식성은 의도일 뿐 | 호스트별 래퍼·설치 경로·메타데이터·도구 이름·권한 모델이 다름. 호스트×스킬 매트릭스는 제공하지 않음 | 실제 쓰는 호스트에서 핵심 스킬 동작 확인 |
| 고르지 않은 리뷰·CI 범위 | 외부 기여 스킬이 섞여 있고, 논문 시점 CI는 스크립트 보유 스킬 중 일부 스위트만 PR에서 실행 | 외부 작성 스킬은 더 엄격히 검토 |
| 스냅샷의 노후화 | 표준·소프트웨어·API·DB 스키마가 바뀌면 스킬도 낡음. 핀은 지시문을 기록할 뿐 정확성을 보장하지 않음 | 업데이트 주기와 last-reviewed 확인 |
| 도달 ≠ 사용 | 설치 기반 추정(클론 클라이언트 약 3.6만)은 스킬이 실제로 쓰인 세션 수가 아님 | 저장소 소개 문구의 “250,000+ scientists” 같은 수치는 마케팅 지표로 읽기 |
결론: “AI 과학자”의 정체는 모델이 아니라 절차의 버전 관리
Scientific Agent Skills를 한 문장으로 평가하면, 과학 분야의 암묵적 절차를 diff 가능한 텍스트로 꺼내 버전 관리한 프로젝트입니다. 기술적으로는 새로운 런타임이 없습니다. 대신 Agent Skills 표준의 6필드 frontmatter를 엄격히 지키고, 점진적 공개로 177개를 들고 다녀도 상주 비용을 200k 창의 7% 수준에 묶고, 스크립트가 있는 스킬엔 테스트와 격리 환경을 붙이고, 보안 스캔 결과와 그 오탐 판단까지 공개합니다. 실무자 입장에서 가치는 “에이전트가 더 똑똑해진다”가 아니라 “에이전트가 어떤 관례를 따랐는지 지목할 수 있게 된다”는 데 있습니다. 결과 보고에 v2.72.0 태그와 scanpy 1.8 같은 스킬 버전을 적을 수 있다는 것 자체가 재현성의 한 단위입니다.
| 도입 전 체크리스트 | 확인 |
|---|---|
| 필요한 스킬만 고르고 이름을 프롬프트에 직접 적었나 | 라우팅 후보 최소화 |
각 스킬의 license(비상업·GPL·Unknown·필드 없음) 확인 |
상업 프로젝트 필수 |
gh skill install … --pin 또는 태그 체크아웃으로 고정했나 |
재현성·인용 |
skill-scanner scan --use-behavioral + SKILL.md 직접 읽기 |
설치 시점 단 한 번의 신뢰 결정 |
| 스킬별 uv 환경, 필요한 도메인만 허용하는 네트워크 정책 | 의존성 충돌·유출 경로 차단 |
| 임상·규제·영상 스킬은 해당 스킬 고유의 범위 제한을 보고서에 명시 | 연구 보조라는 경계 유지 |
| 스킬 유/무를 우리 과제로 비교할 계획이 있나 | 논문이 비워 둔 칸 |