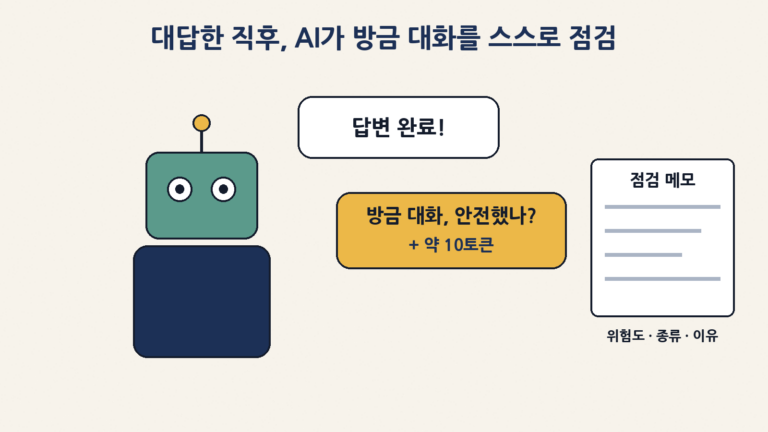
AI가 대답을 마치고 ‘방금 대화 괜찮았나’ 스스로 점검한다? 앤트로픽 클로드 ‘자기 평가’로 본 AI 악용 감시의 원리와 78%·94%·1% 숫자 읽는 법, 잡아낸 사례와 한계, 내 대화와의 관계를 초보도 쉽게
앤트로픽이 클로드가 대답 직후 방금 대화의 위험성을 스스로 짧게 점검하는 ‘자기 평가’ 기술을 공개했어요. 평균 10토큰·비용 2% 미만으로 작동하는 원리, 78%·94%·1% 숫자를 바르게 읽는 법, 실제로 잡아낸 사기·악용 사례와 공격 차단 실험에서 드러난 한계,…