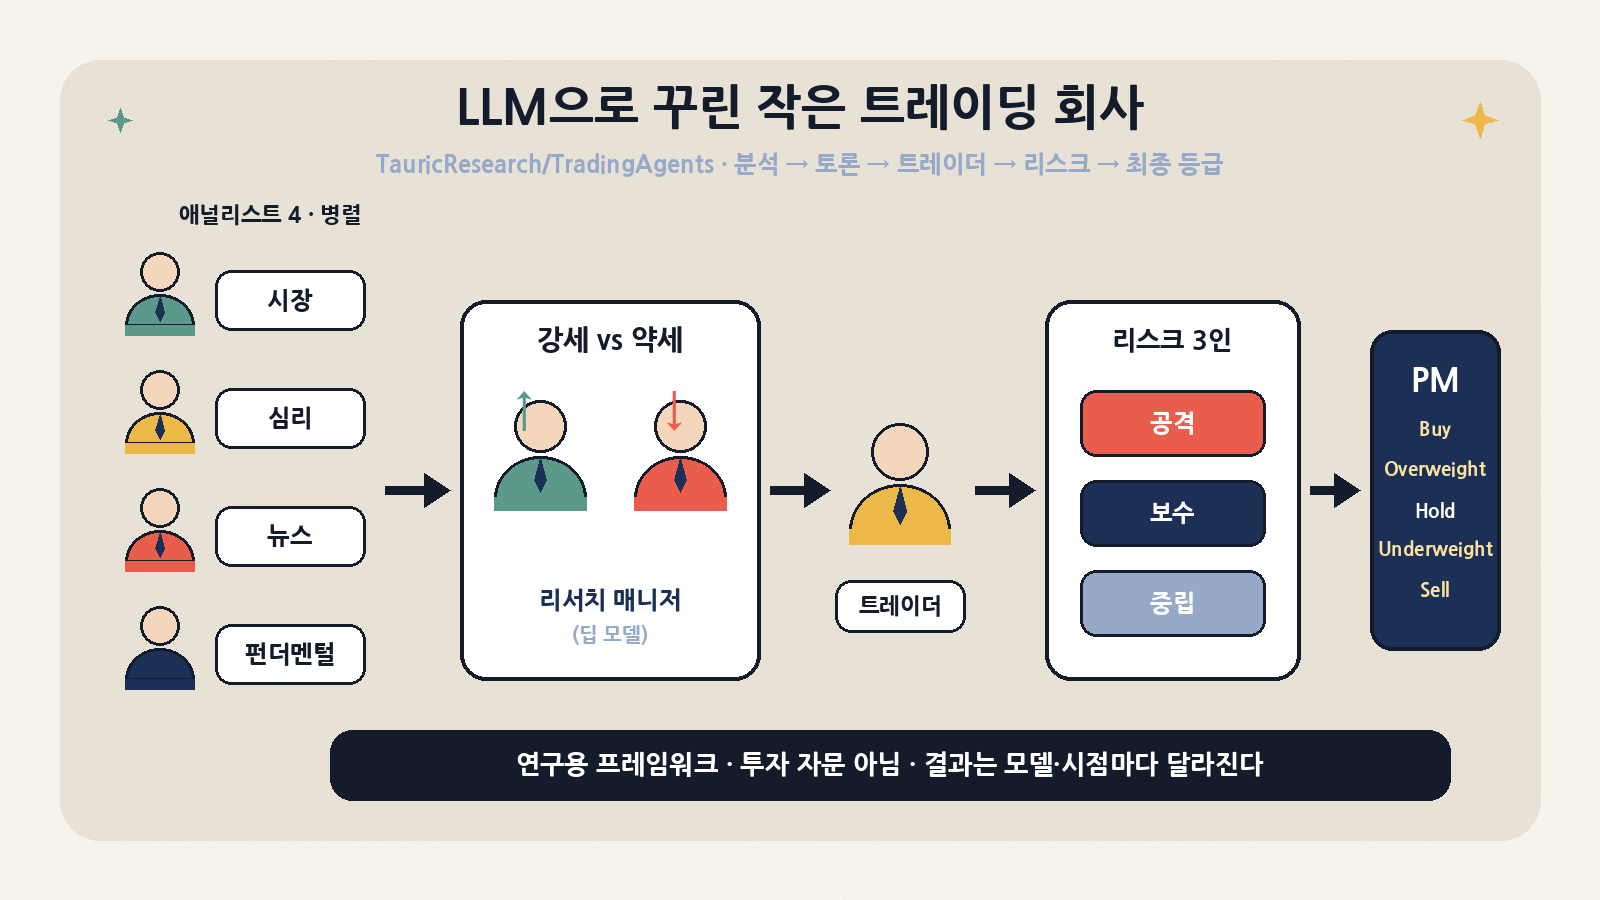
LLM 에이전트로 “트레이딩 회사”를 흉내 내는 프로젝트는 많다. 그중 TauricResearch/TradingAgents는 2024년 12월 arXiv 논문(2412.20138)과 함께 공개된 뒤 스타 11만 개를 넘긴, 이 분야에서 가장 많이 참조되는 오픈소스다. 구조는 단순하다. 애널리스트 4명이 병렬로 보고서를 쓰고, 강세·약세 리서처가 토론하고, 리서치 매니저가 투자 계획을 정하고, 트레이더가 거래 제안을 만들고, 공격·보수·중립 리스크 담당 3명이 다시 토론한 뒤, 포트폴리오 매니저(PM)가 5단계 등급(Buy / Overweight / Hold / Underweight / Sell)을 낸다. 이 흐름 전체가 LangGraph 상태 그래프 하나다.
흥미로운 건 최근 반년의 변화다. 0.2.x 시절 “멀티 에이전트 데모”에 가깝던 코드가 0.4~0.7을 거치며 시점 무결성(point-in-time), 즉 “분석 날짜에 실제로 공개돼 있던 데이터만 보여 준다”는 원칙을 거의 모든 데이터 경로에 박아 넣었다. SEC EDGAR 공시를 공시일 기준으로 서빙하고, 과거 날짜 실행에서는 공시일을 알 수 없는 Yahoo 재무제표·내부자 거래를 아예 막고, v0.7.0(2026-10-16)에서는 결정의 진입 시점을 “분석일 종가”가 아니라 “분석일 다음 첫 종가”로 옮겼다. 백테스트 숫자를 부풀리는 미래 정보 누수(look-ahead)를 구조적으로 막겠다는 방향이다.
오늘(2026-10-24) 기준 GitHub Trending Python 일간 5위(오늘 +485, 16:56 KST 스냅숏)다. 이 글은 README·CHANGELOG·소스(약 1만 줄)·논문 PDF를 직접 읽고 구조와 설계 타협점을 해부한다. 그리고 GPU가 없는 박스(x86_64, 8코어, RAM 15GB)에서 테스트 스위트, SEC EDGAR 시점 조회, 그리고 llama.cpp로 띄운 로컬 3B 모델로 전체 파이프라인 한 바퀴를 실제로 돌린 결과를 그대로 적는다.
한눈에 보기: 오늘 기준 스냅숏
| 항목 | 값 |
|---|---|
| 저장소 | github.com/TauricResearch/TradingAgents · 생성 2024-12-28 · 주제 태그 agent, finance, llm, multiagent, trading |
| 라이선스 | Apache License 2.0 |
| 최신 버전 | v0.7.0 (GitHub 릴리스 2026-10-17 06:38 KST) · 릴리스마다 wheel(tradingagents-0.7.0-py3-none-any.whl)과 sdist 첨부 |
| 스타 / 포크 | 113,482 / 21,963 (2026-10-24 17시 KST GitHub API) |
| 트렌딩 | Python 일간 5위, 오늘 +485 스타 (전체 언어 일간 목록에는 없음) |
| 언어 / 요구 사항 | Python ≥ 3.11 (3.14 지원, Docker 이미지는 3.13) |
| 핵심 의존성 | LangGraph ≥ 1.2.12, langchain-core ≥ 1.6.5, langchain-openai/anthropic/google-genai, yfinance ≥ 1.7.0, pandas ≥ 3.0.6, stockstats, typer·rich·questionary(CLI) |
| 코드 규모 | tradingagents/ 패키지 파이썬 약 10,600줄 + cli/ + 테스트 파일 수십 개(단위 테스트 1,361개 수집) |
| 논문 | “TradingAgents: Multi-Agents LLM Financial Trading Framework”, Yijia Xiao·Edward Sun·Di Luo·Wei Wang, arXiv 2412.20138 (q-fin.TR) |
| 면책 | README: 연구 목적이며 금융·투자·트레이딩 자문이 아님 |
릴리스로 보는 진화: 데모에서 “시점 무결성” 프레임워크로
CHANGELOG는 Keep a Changelog 형식이고, 깨지는 변경은 릴리스마다 “Upgrading from” 절에 따로 적는다. 최근 릴리스의 굵은 줄기만 추리면 다음과 같다.
| 버전 (GitHub 릴리스, KST) | 핵심 변화 |
|---|---|
| v0.3.0 (2026-06-22) | 검증된 데이터 접근 계약, 프로바이더 레지스트리 확장(NVIDIA·Kimi·Groq·Mistral·Bedrock·OpenAI 호환 엔드포인트), FRED·Polymarket 벤더, CI 게이트 |
| v0.4.0 (2026-08-31) | FRED 매크로·소셜 심리·결정 로그 메모리의 look-ahead 수정, 체크포인트 재개, 트레이더 가격 그라운딩 |
| v0.5.0 (2026-09-18) | 모든 날짜 경로에 시점 무결성, SEC EDGAR “공시된 그대로” 재무제표, 티커×날짜 그리드 백테스트, 포트폴리오 인지 실행 |
| v0.5.1 (2026-09-24) | 모듈 경로 재배치(구 import 경로 제거), TypeSafe Jev로 소셜 글 선별(선택) |
| v0.5.2 (2026-09-29) | 애널리스트 병렬 실행, 프롬프트 없는 CLI(--ticker, --date), 리포트에 실행 설정 기록, 분석일 이후 공개 데이터 차단 |
| v0.6.0 (2026-10-04) | HTML 단일 페이지 리포트, 모델 계층(퀵/딥)별 프로바이더 분리, 애널리스트와 동시에 과거 결정 정산 |
| v0.7.0 (2026-10-17) | ChatGPT Plus/Pro 구독으로 실행(tradingagents login chatgpt), 결정을 “분석일 다음 첫 종가”로 채점, 시작 시 새 버전 알림, 릴리스 wheel |
아키텍처 ①: 역할 12개, 모델 계층 2개
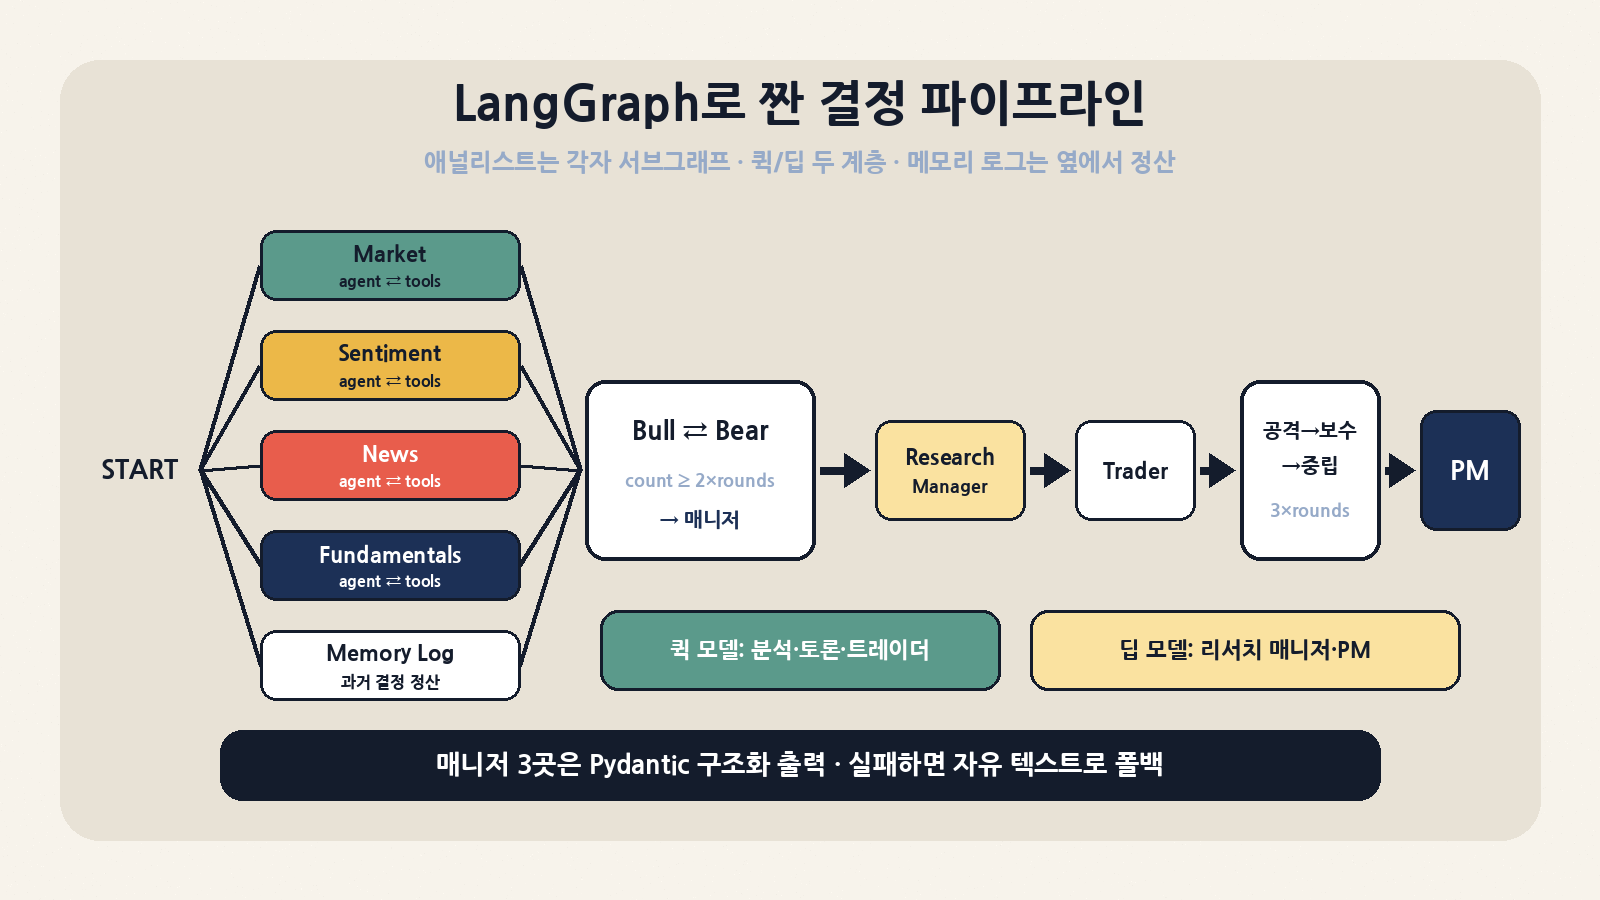
소스의 graph/setup.py를 보면 노드는 애널리스트(선택한 만큼) + 리서처 2 + 리서치 매니저 + 트레이더 + 리스크 토론자 3 + PM, 그리고 메모리 로그 노드다. 모델은 두 계층으로 나뉜다. 퀵 모델은 애널리스트·리서처·토론자·트레이더를, 딥 모델은 리서치 매니저와 PM을 맡는다. 기본값은 quick_think_llm="gpt-6-luna", deep_think_llm="gpt-6-sol"이고, v0.6.0부터는 계층마다 프로바이더를 따로 줄 수 있다(예: 매니저만 Claude).
| 역할 | 모델 계층 | 입력 | 출력 / 형식 |
|---|---|---|---|
| Market Analyst | 퀵 | OHLCV, stockstats 지표, 검증된 시장 스냅숏 | market_report (자유 텍스트) |
| Sentiment Analyst | 퀵 | Yahoo 뉴스 헤드라인 + StockTwits + Reddit (노드가 미리 수집해 프롬프트에 주입) | sentiment_report (SentimentReport 구조화 출력, 미지원 시 자유 텍스트) |
| News Analyst | 퀵 | 종목 뉴스, 글로벌 뉴스, FRED 매크로, Polymarket | news_report |
| Fundamentals Analyst | 퀵 | 개요, 대차대조표·현금흐름표·손익계산서, 내부자 거래 | fundamentals_report |
| Bull / Bear Researcher | 퀵 | 애널리스트 보고서 4종 + 상대 발언 | 토론 이력 (investment_debate_state) |
| Research Manager | 딥 | 토론 전체 | 투자 계획 (Pydantic 구조화, 5단계 등급) |
| Trader | 퀵 | 투자 계획 + 보고서 | 거래 제안 (구조화, Buy/Hold/Sell 3단계 액션 + 선택적 진입가·손절가) |
| Aggressive / Conservative / Neutral | 퀵 | 거래 제안 + 보고서 | 리스크 토론 이력 (risk_debate_state) |
| Portfolio Manager | 딥 | 리스크 토론 + 메모리 로그의 과거 교훈 + (선택) 보유 포지션 | 최종 결정 + final_rating (구조화) |
아키텍처 ②: 그래프 배선의 세부
세 가지 배선이 설계의 핵심이다.
(1) 애널리스트마다 독립 서브그래프. _analyst_graph()는 애널리스트 하나를 agent ⇄ tools 루프를 가진 별도 StateGraph로 컴파일하고, output_schema로 자기 보고서 키 하나만 내보내게 한다. 그래서 병렬로 도는 애널리스트들이 같은 키를 덮어쓰지 않고, 서로의 도구 호출 메시지도 섞이지 않는다. 도구 호출이 max_tool_rounds(기본 20)에 닿으면 wrap_up 노드가 “이제 보고서를 쓰라”는 메시지를 넣고 끝낸다. 도구만 계속 부르는 모델이 LangGraph 재귀 한도에 걸려 죽는 것을 막는 장치다(#1420).
(2) 팬아웃 후 조인. START에서 선택된 애널리스트들과 “Memory Log” 노드로 동시에 간선을 내고, workflow.add_edge(first_steps, "Bull Researcher")로 전부 끝나야 토론이 시작된다. 그래서 애널리스트 단계의 소요 시간은 가장 느린 한 명의 시간에 수렴한다(v0.5.2).
(3) 카운터 기반 토론 라우터. ConditionalLogic은 단순하다. 투자 토론은 count ≥ 2 × max_debate_rounds이면 리서치 매니저로, 아니면 직전 발언자가 Bull이면 Bear로 보낸다. 리스크 토론은 3 × max_risk_discuss_rounds에서 PM으로 가고 공격→보수→중립 순서로 돈다. 모든 조건 간선이 가능한 목적지 전체를 담은 path map을 공유하는데, 발언자 라벨이 번역·리팩터로 어긋나도 LangGraph가 “없는 경로”로 크래시하지 않게 하려는 방어다(#1088).
| 애널리스트 키 | 그래프 노드 | 도구 (agents/tools.py) | 비고 |
|---|---|---|---|
market |
Market Analyst | get_stock_data, get_indicators, get_verified_market_snapshot |
정확한 가격·지표 수치는 검증 스냅숏에 근거 |
social |
Sentiment Analyst | 없음 (노드가 사전 수집) | CLI에서는 sentiment로도 지정 · 피드가 아카이브되지 않아 과거 실행은 시점 무결성 아님 |
news |
News Analyst | get_news, get_global_news, get_macro_indicators, get_prediction_markets |
FRED는 FRED_API_KEY 필요, Polymarket은 키 불필요 |
fundamentals |
Fundamentals Analyst | get_fundamentals, get_balance_sheet, get_cashflow, get_income_statement, get_insider_transactions |
재무제표 기본 체인: sec_edgar,yfinance |
저장소 구조
| 경로 | 역할 |
|---|---|
tradingagents/graph/ |
trading_graph.py(TradingAgentsGraph, propagate·save_reports), setup.py(그래프 배선), conditional_logic.py, analyst_execution.py, checkpointer.py(SQLite 체크포인트) |
tradingagents/agents/ |
analysts/·researchers/·managers/·trader/·risk 토론자, schemas.py(Pydantic 출력 스키마), structured.py(구조화 출력 + 폴백), rating.py(5단계 등급 파서), tools.py |
tradingagents/dataflows/ |
router.py(벤더 체인 라우팅), vendors/(yahoo, alpha_vantage, sec_edgar, fred, polymarket, stocktwits, reddit), date_window.py, symbols.py |
tradingagents/llm_clients/ |
프로바이더 팩토리, capabilities.py(모델별 구조화 출력 방식), model_catalog.py, ChatGPT 로그인(chatgpt_auth.py) |
tradingagents/memory/ |
결정 로그(log.py)와 정산·회고(settlement.py) |
tradingagents/backtest.py |
iter_grid, run_backtest, summarize |
cli/ |
typer 기반 대화형/무인 CLI, 백테스트 서브커맨드, 업데이트 알림 |
tests/ |
네트워크·사용자 파일을 건드리지 않는 단위 테스트, 통합 테스트는 -m integration |
핵심 설계 결정과 트레이드오프
| 결정 | 얻는 것 | 치르는 것 |
|---|---|---|
| 역할 분할 + 두 번의 토론 | 관점 다양성, 단계별 리포트로 추적 가능 | 호출 수 증가. 논문 각주 기준 예측 1회에 LLM 호출 11회·도구 호출 20회 이상 |
| 퀵/딥 2계층 모델 | 비싼 추론 모델은 매니저 2곳에만 | 계층 간 품질 격차가 크면 매니저가 부실한 보고서를 요약하게 됨 |
| 산문이 1차 산출물, 매니저 3곳만 구조화 | 사람이 읽는 리포트 유지 + 등급·액션은 기계 판독 | 약한 모델은 구조화 실패 → 자유 텍스트 재시도(아래 실측에서 실제로 발생) |
등급은 Rating: 라벨에서만 파싱, 실패 시 REVIEW |
읽을 수 없는 결정을 Hold로 둔갑시키지 않음(#1170) | 프롬프트 형식에 민감, 다국어 출력에서도 라벨은 영어 유지 |
| 시점 무결성 우선 | 백테스트 누수 차단, 재현 가능한 입력 | 과거 날짜 실행에서 Yahoo 재무·내부자 거래 등 정보가 “보류”로 빠짐 |
| 벤더 체인은 명시한 것만 | 설정하지 않은 벤더로 조용히 우회하지 않음 | 폴백이 필요하면 "yfinance,alpha_vantage"처럼 직접 나열해야 함 |
| 메모리 로그 상시 기록 | 지난 결정의 실현 수익·알파 회고를 PM이 읽음 | 학습이 아니라 프롬프트 주입. 로그가 커지면 컨텍스트 비용 증가(memory_log_max_entries로 회전) |
데이터 계층: 벤더 라우팅과 “그날 알 수 있던 것만”
default_config.py의 data_vendors는 범주별 벤더 체인을 정한다. 주석이 강조하듯 “설정한 값이 곧 정확한 체인”이고, 요청이 선택하지 않은 벤더로 몰래 넘어가지 않는다. 한 벤더의 “데이터 없음”이 체인의 다른 벤더 실패를 대변하지 않게 오류 종류도 구분한다(VendorUnavailableError vs 데이터 없음).
| 범주 | 기본 벤더 체인 | 대안 / 키 |
|---|---|---|
| core_stock_apis (가격) | yfinance |
alpha_vantage (ALPHA_VANTAGE_API_KEY) |
| technical_indicators | yfinance (stockstats 계산) |
alpha_vantage |
| fundamental_data | sec_edgar,yfinance |
alpha_vantage · EDGAR는 키 불필요, SEC_EDGAR_USER_AGENT 권장 |
| news_data | yfinance |
alpha_vantage · Yahoo 뉴스 피드 장애 시 Yahoo 검색으로 대체(v0.6.0) |
| macro_data | fred |
FRED_API_KEY (무료) · v0.6.0에서 유로존 시리즈 추가 |
| prediction_markets | polymarket |
키 불필요 |
시점 규칙은 데이터 종류마다 다르게 처리된다. README와 CHANGELOG에서 확인한 규칙을 표로 묶으면 다음과 같다.
| 데이터 | 과거 날짜 실행에서의 처리 | 근거 |
|---|---|---|
| 미국 상장사 재무제표 | SEC EDGAR 공시일 기준. 분석일 이후 공시·정정은 보이지 않음. 4분기는 연간에서 역산하지 않고 “없음” 처리 | README “Fundamentals as filed” |
| 비미국 재무제표 (Yahoo) | 기간 기준 날짜라 공시 시점을 알 수 없음 → 과거 실행에서는 보류 | README |
| 내부자 거래 | 거래일 기준이라 공시 시점 불명 → 과거 실행에서는 보류 | README |
| 가격·지표 | 분석일 이후 행은 검증 전에 제거 | 검증 스냅숏 출력 문구 |
| 뉴스·StockTwits·Reddit | 피드가 “현재”를 반영 → 과거 날짜라도 오늘의 글이 섞일 수 있음 | README “Reproducibility”, sentiment_analyst.py 주석 |
| 결정 진입 시점 | 분석일 d의 종가가 아니라 d 다음 첫 종가(장 마감 후 뉴스까지 읽기 때문) | v0.7.0, #1518 |
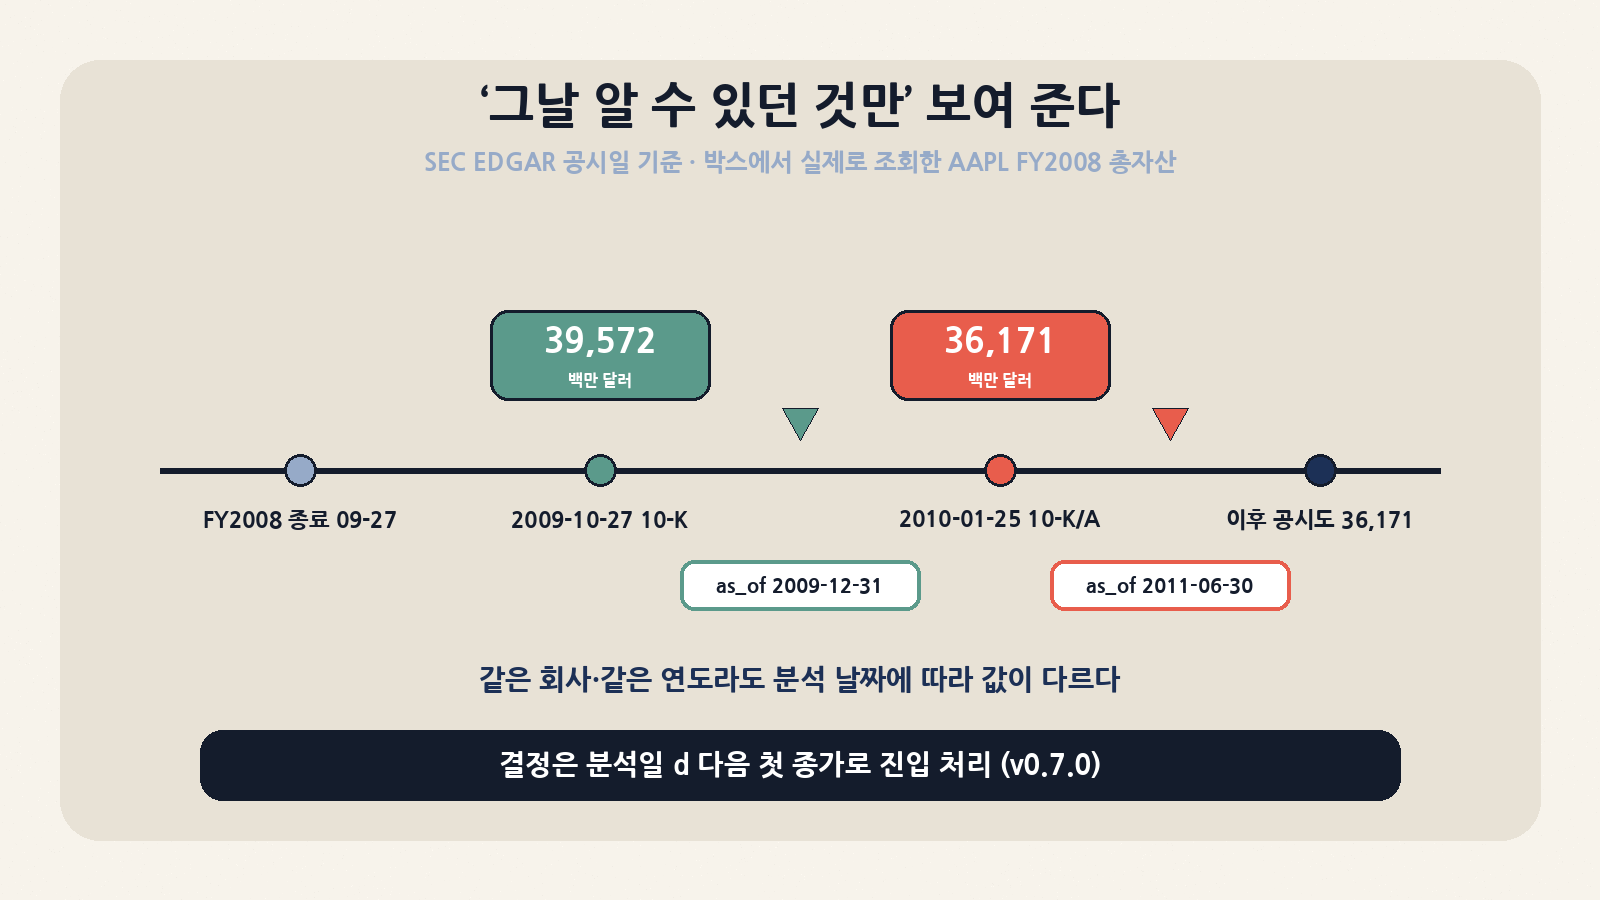
이 규칙이 실제로 작동하는지 박스에서 확인했다. 애플(CIK 0000320193)의 FY2008(2008-09-27 종료) 총자산은 2009-10-27 10-K에 39,572백만 달러로 실렸고, 2010-01-25 10-K/A에서 36,171백만 달러로 재작성됐다(EDGAR companyfacts 원본에서 공시일 확인). sec_edgar.get_balance_sheet("AAPL", "annual", as_of)를 날짜만 바꿔 호출한 결과는 다음과 같다.
| as_of_date | 반환된 FY2008 총자산 | 비고 |
|---|---|---|
| 2009-06-30 | 오류: no annual balance sheet filed by 2009-06-30 |
연간 보고서(10-K) 공시 전이라 연간 표 자체가 없음 |
| 2009-12-31 | 39,572 (백만 달러) · FY2009 53,851 | 최초 공시값. README의 “$39.6B” 사례와 일치 |
| 2011-06-30 | 36,171 · FY2009 47,501 · FY2010 75,183 | 재작성값. FY2009 총자산도 53,851 → 47,501로 바뀜 |
“재작성 이후의 숫자로 과거를 판단하는” 전형적인 누수를 데이터 계층에서 차단한다는 뜻이다. 다만 이 장치는 EDGAR가 다루는 미국 공시 기업에만 해당하고, 한국·홍콩 종목은 다음 벤더로 넘어간다는 점을 기억해야 한다.
설치와 실행
README의 명령을 그대로 옮긴다. Python 3.11 이상이 필요하다.
git clone https://github.com/TauricResearch/TradingAgents.git
cd TradingAgents
uv venv --python 3.13 && source .venv/bin/activate   # 또는 conda create -n tradingagents python=3.13
pip install .            # uv라면 uv pip install .
cp .env.example .env     # 쓸 프로바이더의 API 키 입력

tradingagents            # 대화형 CLI
python -m cli.main       # 소스에서 직접
무인 실행(스케줄러·CI)은 실행별 질문을 플래그로, 나머지를 TRADINGAGENTS_* 환경 변수로 답한다. 터미널 없이 돌다가 빠진 답이 있으면 시작 전에 멈추고 필요한 플래그 이름을 알려 준다.
export TRADINGAGENTS_LLM_PROVIDER=openai TRADINGAGENTS_QUICK_THINK_LLM=gpt-6-luna TRADINGAGENTS_DEEP_THINK_LLM=gpt-6-sol
export TRADINGAGENTS_OUTPUT_LANGUAGE=English TRADINGAGENTS_MAX_DEBATE_ROUNDS=1 TRADINGAGENTS_MAX_RISK_ROUNDS=1
tradingagents --ticker NVDA --date 2026-09-23 --analysts market,news,fundamentals --save --no-show

# 백테스트 (티커×날짜 그리드)
tradingagents backtest NVDA,AAPL --start 2026-06-01 --end 2026-08-01 --every 7

# Docker
docker compose run --rm tradingagents
docker compose --profile ollama run --rm tradingagents-ollama
파이썬 API는 TradingAgentsGraph(...).propagate(ticker, date)가 (state, rating)을 돌려주는 형태다. 보유 포지션을 넘기면 트레이더·리스크 담당·PM이 실제 북을 기준으로 판단한다.
from tradingagents.graph.trading_graph import TradingAgentsGraph
from tradingagents.default_config import DEFAULT_CONFIG
from tradingagents.portfolio import PortfolioContext

config = DEFAULT_CONFIG.copy()
config["llm_provider"] = "openai_compatible"          # vLLM, LM Studio, llama.cpp 등
config["backend_url"] = "http://localhost:8000/v1"
config["deep_think_provider"] = "anthropic"           # 계층별 프로바이더 분리 (v0.6.0+)
config["deep_think_llm"] = "claude-opus-5-5"

ta = TradingAgentsGraph(selected_analysts=["market", "news"], config=config)
pf = PortfolioContext.model_validate({"cash": 25000.0, "currency": "USD",
        "positions": [{"ticker": "NVDA", "quantity": 120, "average_price": 150.0}]})
state, rating = ta.propagate("NVDA", "2026-09-01", portfolio=pf)
ta.save_reports(state, "NVDA") # reports/ 트리 + complete_report.html| 설정 키 / 환경 변수 | 기본값 | 의미 |
|---|---|---|
llm_provider / TRADINGAGENTS_LLM_PROVIDER |
openai | openai, anthropic, google, azure, bedrock, xai, deepseek, qwen, glm, minimax, openrouter, mistral, kimi, groq, nvidia, ollama, chatgpt, openai_compatible (qwen·glm·minimax는 중국 리전 엔드포인트 별도) |
quick_think_llm / deep_think_llm |
gpt-6-luna / gpt-6-sol | 계층별 모델 ID (카탈로그 밖 ID도 허용) |
max_debate_rounds / max_risk_discuss_rounds |
1 / 1 | 토론 라운드 (각각 2×, 3× 발언) |
max_tool_rounds |
20 | 애널리스트 도구 호출 라운드 상한 |
temperature |
None | 추론 모델은 대부분 무시 |
holding_period_days |
5 | 결정 채점 기간(다음 첫 종가부터 거래일 수) |
benchmark_map |
.KS→^KS11, .KQ→^KQ11, 미국→SPY 등 |
지역별 알파 벤치마크 |
checkpoint_enabled |
False | 노드마다 SQLite 체크포인트, 성공 시 자동 삭제 |
TRADINGAGENTS_NO_UPDATE_CHECK |
미설정 | 1이면 시작 시 업데이트 확인 끔(무인 실행은 원래 확인 안 함) |
논문이 주장하는 성능과 읽는 법
논문(v5 PDF)의 실험은 2024-01-01~2024-03-29, 약 3개월 백테스트다. 비교 대상은 Buy & Hold, MACD, KDJ+RSI, ZMR, SMA 다섯 가지 규칙 기반 전략이고, 지표는 누적수익률(CR), 연환산수익률(ARR), 샤프 비율(SR), 최대낙폭(MDD)이다. Table 1 중 TradingAgents와 각 종목 최강 기준선만 옮긴다.
| 종목 | TradingAgents CR / ARR / SR / MDD | 기준선 참고 (B&H CR / SR / MDD) | 논문 표기 개선폭 (CR) |
|---|---|---|---|
| AAPL | 26.62% / 30.5% / 8.21 / 0.91% | -5.23% / -1.29 / 11.90% | +24.57%p |
| GOOGL | 24.36% / 27.58% / 6.39 / 1.69% | 7.78% / 1.35 / 13.04% | +16.58%p |
| AMZN | 23.21% / 24.90% / 5.60 / 2.11% | 17.1% / 3.53 / 3.80% | +6.10%p |
수치만 보면 압도적이지만, 논문 스스로 단서를 붙였다. 각주에서 “LLM·도구 사용 비용 때문에 3개월만 백테스트했고, 최고 샤프 비율은 경험적 기대 범위를 넘으며, 해당 기간 되돌림이 적었던 현상 때문으로 본다”고 적는다. 모델 구성도 지금과 다르다(논문은 quick-thinking에 gpt-4o-mini/gpt-4o, deep-thinking에 o1-preview를 언급). 그리고 저장소 README의 Reproducibility 절은 “백테스트 결과는 어떤 공표 수치와도 일치를 보장하지 않는다”고 못 박는다.
| 읽을 때 확인할 점 | 왜 중요한가 |
|---|---|
| 기간 3개월 · 종목 3개 | 강세장 한 구간의 결과일 수 있음. 레짐 변화 검증 없음 |
| 당시 코드는 시점 무결성 이전 | 0.4~0.7에서 고친 look-ahead 경로들이 논문 실험 이후의 수정 |
| 샤프 5~8 | 저자도 “기대 범위 초과”라고 인정. 거래 비용·슬리피지 가정 확인 필요 |
| LLM 비결정성 | 같은 티커·날짜도 실행마다 다를 수 있음(README). 단일 런은 표본 1개 |
박스 스모크 테스트: 실제로 돌려 본 결과
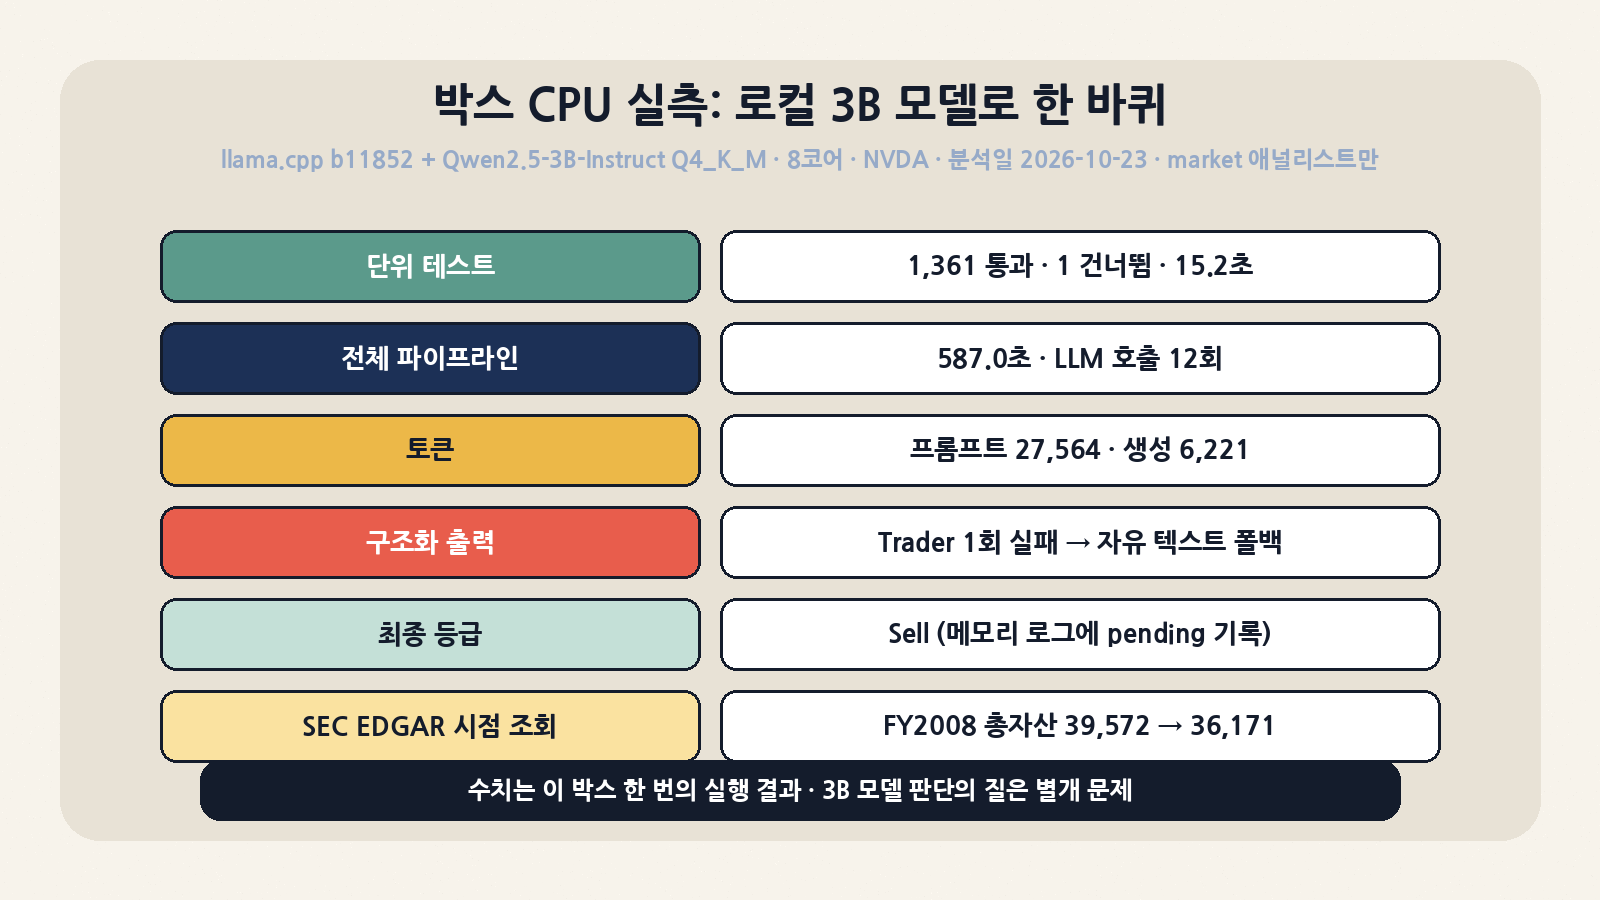
환경은 GPU 없는 x86_64 VM(8코어, RAM 15GB), Python 3.13.5, uv pip install .로 설치한 v0.7.0(langgraph 1.2.17, langchain-core 1.7.0, pandas 3.1.0, yfinance 1.7.0)이다. API 키는 쓰지 않았다. LLM은 llama.cpp 릴리스 b11852의 CPU 빌드 llama-server(--jinja, 컨텍스트 16K, 8스레드)로 Qwen2.5-3B-Instruct Q4_K_M GGUF를 띄우고 llm_provider="openai_compatible"로 연결했다. 퀵·딥 계층 모두 같은 3B 모델이고, 애널리스트는 market 하나, 토론·리스크 라운드 1, max_tool_rounds=4, max_tokens=900, temperature=0.2로 잡았다.
uv pip install . pytest && python -m pytest -q          # 단위 테스트
./llama-server -m qwen2.5-3b-instruct-q4_k_m.gguf --port 8080 -c 16384 -t 8 --jinja --metrics
# run_local.py: openai_compatible + backend_url=http://127.0.0.1:8080/v1
ta = TradingAgentsGraph(selected_analysts=["market"], config=c)
state, decision = ta.propagate("NVDA", "2026-10-23")| 항목 | 결과 |
|---|---|
| 단위 테스트 | 1,361 통과 · 1 건너뜀(langchain_aws 미설치로 Bedrock 테스트) · 1 deselected(integration) · 15.19초 |
| 검증 시장 스냅숏 (NVDA, 2026-10-23) | 0.2초. “분석일 이후 행 제외” 문구와 함께 최신 OHLCV 행, 지표 11종(close_10_ema, 50/200 SMA, RSI, 볼린저, MACD 3종, ATR), 최근 30개 종가 표 반환 |
| 같은 스냅숏 (005930.KS 삼성전자) | 0.4초. 한국 종목도 거래소 접미사 티커로 정상 조회 |
| SEC EDGAR 시점 조회 | 위 표대로 as_of에 따라 39,572 → 36,171 전환 확인 |
| 전체 파이프라인 소요 | 587.0초 (약 9분 47초), 그래프 생성부터 결정 반환까지 |
| LLM 요청 수 | 12회 (llama-server 슬롯 처리 기준) |
| 토큰 (llama.cpp 메트릭) | 프롬프트 27,564(캐시 제외) · 생성 6,221 · 생성 속도 대략 11~14 tok/s(동시 슬롯 2개일 때 낮아짐) |
| max_tokens 900 도달 | 12회 중 6회. 토론·리포트가 상한에서 잘림 |
| 구조화 출력 | Trader에서 1회 실패 → 경고 로그 후 자유 텍스트로 1회 재시도, 파이프라인은 계속 진행 |
| 최종 결과 | final_rating = Sell, 메모리 로그에 [2026-10-23 | NVDA | Sell | pending] 기록 |
| 저장 산출물 | 1_analysts/market.md, 2_research/bull·bear·manager.md, 3_trading/trader.md, 4_risk/ 3개, 5_portfolio/decision.md, complete_report.md/.html, 전체 상태 JSON 로그 |
관찰 포인트가 두 가지 있다. 첫째, 그라운딩은 작동했다. Market Analyst 보고서의 지표 수치(close_10_ema 218.44, close_50_sma 222.39, RSI 38.11 등)는 같은 날짜로 따로 뽑은 검증 스냅숏 값과 일치했다. 숫자를 지어내는 문제는 데이터 계층이 상당 부분 막아 준다. 둘째, 추론의 질은 모델이 결정한다. 3B 모델의 강세 리서처는 “A100이 시장에서 가장 빠른 GPU”라는 낡은 지식을 근거로 들었고, 약세 리서처는 종가가 50일선 아래인 상황을 “강한 상승 추세”라고 해석하는 등 논리 오류가 보였다. 즉 이 프레임워크가 보장하는 건 입력의 정직함과 절차이지 판단의 정확성이 아니다. 이 등급은 3B 모델로 파이프라인을 검증하려고 한 번 돌린 결과일 뿐 어떤 투자 의미도 없다.
돌리지 않은 것: 상용 API 모델(GPT·Claude·Gemini) 실행, 애널리스트 4명 전체 구성, 백테스트 그리드, FRED·Alpha Vantage·TypeSafe 키가 필요한 경로, 체크포인트 재개, Docker 이미지. 위 소요 시간은 이 박스·이 모델·이 설정에서 측정한 단일 런 값이다.
비슷한 도구와 비교
| 프로젝트 | 접근 | 에이전트 스택 | 데이터 / 키 | 라이선스 · 스타(오늘) |
|---|---|---|---|---|
| TradingAgents | 트레이딩 회사 역할 분할 + 두 단계 토론 + PM 5단계 등급, 그리드 백테스트 | LangGraph · OpenAI·Anthropic·Google·Bedrock·Ollama 등 십수 개 프로바이더 + OpenAI 호환 엔드포인트 + ChatGPT 구독 | yfinance·SEC EDGAR 키 없이 시작 가능, FRED·Alpha Vantage 선택 | Apache-2.0 · 113,482 |
| virattt/ai-hedge-fund | 투자자(investor) 에이전트 팀이 판단, 페이퍼 트레이딩·백테스트 터미널 앱 (실제 주문 없음) | 자체 CLI 앱(aihf) |
Financial Datasets API 키 + 모델 키 필요 | MIT · 64,200 |
| AI4Finance/FinRobot | “모델은 추론, 소프트웨어는 계산” 원칙의 금융 에이전트 플랫폼(리서치 보고서·밸류에이션 중심) | V0 AutoGen → V1 OpenAI Agents SDK → V2 PydanticAI 데스크톱 | 도구별 상이 | Apache-2.0 · 8,286 |
| AI4Finance/FinGPT | 금융 특화 LLM 미세조정·모델 공개(에이전트 오케스트레이션보다는 모델 쪽) | 학습 파이프라인 + HF 모델 | 데이터셋·모델 가중치 | MIT · 21,450 |
정리하면 TradingAgents의 차별점은 “토론 구조”보다 오히려 데이터 계층의 시점 무결성, 지역별 벤치마크 알파, 별도 메모리 로그를 쓰는 재개 가능한 그리드 백테스트라는 연구 인프라 쪽에 있다. 반대로 실제 계좌 연동이나 주문 실행은 범위 밖이다(README의 PM 설명은 “시뮬레이션 거래소”를 전제한다).
한계와 주의점
| 영역 | 주의점 |
|---|---|
| 비용 | 결정 1건에 LLM 10여 회 + 도구 수십 회(논문 각주: LLM 11회·도구 20회 이상). 그리드 백테스트는 티커×날짜만큼 곱해짐. 구독(ChatGPT) 실행은 플랜 사용량 한도에 포함되고 temperature·max_tokens를 받지 않음 |
| 재현성 | 추론 모델은 temperature를 대부분 무시. README도 같은 날짜 두 런의 차이를 “결함이 아니라 예상된 것”이라 명시 |
| 심리·뉴스 입력 | StockTwits·Reddit·뉴스는 아카이브가 아니어서 과거 날짜 실행에서도 “현재”가 섞임 → 심리 신호가 들어간 백테스트는 누수 가능성 |
| 비미국 종목 | EDGAR 밖이라 과거 실행 시 재무제표가 보류되는 경우가 많음. 한국 종목은 KOSPI(^KS11)/KOSDAQ(^KQ11) 벤치마크만 자동 지원 |
| 약한 모델 | 구조화 출력 실패·잘림·사실 오류(박스 실측). 폴백이 파이프라인을 살리지만 결론의 질은 보장 못 함 |
| 업그레이드 | 마이너 버전마다 import 경로·상태 키·체크포인트 호환이 깨진 이력(0.5.1, 0.5.2, 0.6.0). “Upgrading from” 절 필독 |
| 네트워크 | 대화형 CLI는 하루 한 번 업데이트·공지 확인(무인 실행은 안 함). SEC EDGAR엔 연락처 User-Agent를 직접 설정 권장 |
| 법적 성격 | 연구 목적, 투자 자문 아님(README·Tauric 면책 고지) |
도입 체크리스트
| 단계 | 할 일 |
|---|---|
| 1. 범위 | “의사결정 보조 리포트”인지 “백테스트 연구”인지 먼저 정함. 후자라면 social 애널리스트를 빼고 누수 경로를 줄이는 구성을 검토 |
| 2. 모델 | 딥 계층에만 강한 모델, 퀵 계층은 비용 효율 모델. 재현성이 중요하면 비추론 모델 + 낮은 temperature |
| 3. 데이터 | SEC_EDGAR_USER_AGENT 설정, 필요 시 FRED_API_KEY. 벤더 폴백은 체인으로 명시 |
| 4. 비용 상한 | max_tool_rounds, max_tokens, llm_max_retries로 한 런의 상한을 묶음 |
| 5. 평가 | 단일 런 대신 run_backtest 그리드 + summarize. 중단되면 같은 run_id로 이어서 |
| 6. 운영 | --checkpoint로 긴 런 보호, TRADINGAGENTS_DATA_DIR로 Docker 산출물 호스트 보존, 메모리 로그 회전 설정 |
TradingAgents를 “AI가 주식을 골라 준다”는 도구로 보면 실망하기 쉽다. 반대로 LLM 멀티 에이전트의 판단을 시점이 정직한 데이터 위에서 반복 측정하는 실험대로 보면 지금 공개된 것 중 손이 가장 많이 간 축에 든다. 박스에서 본 것도 같은 결론이다. 숫자 입력은 정직했고, 절차는 무너지지 않았고, 판단의 질은 고스란히 모델 몫으로 남았다.