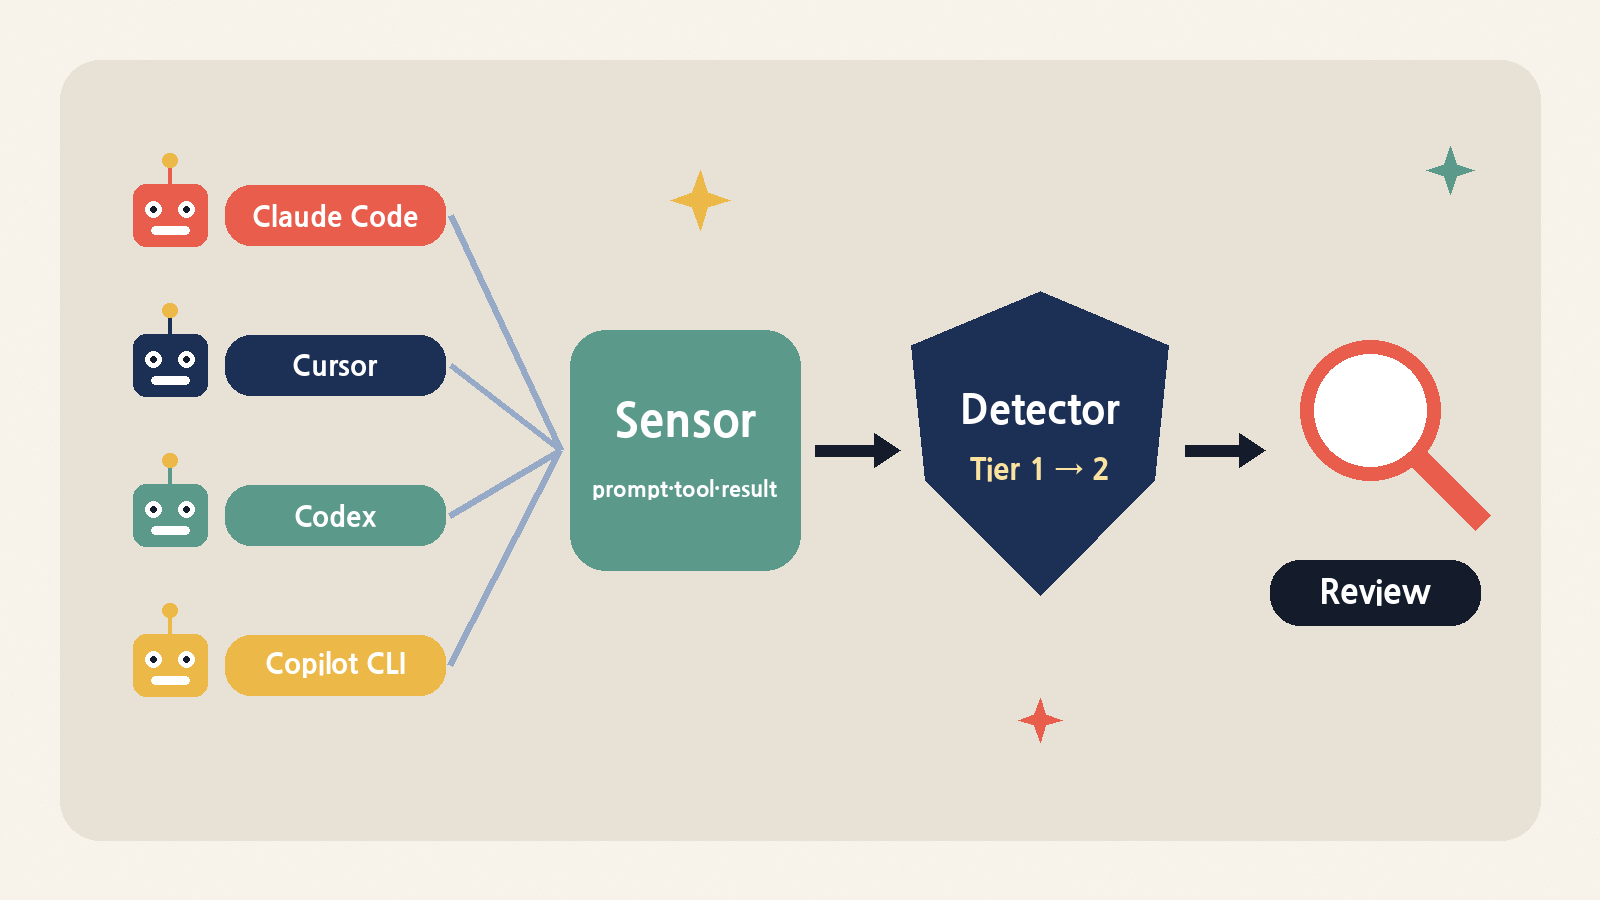
회사 노트북마다 Claude Code, Cursor, Codex, Copilot CLI가 깔리면서 보안팀의 질문이 바뀌었다. “어떤 파일이 바뀌었나”가 아니라 “에이전트가 무엇을 지시받았고, 어떤 MCP 도구를 불렀으며, 그 결과로 무엇을 했나”를 알아야 한다. 오늘 GitHub Trending Python 일간 목록에 오른 uber/ADR(Agentic AI Detection and Response)은 우버가 사내에서 운영해 온 AI 에이전트 보안 체계를 공개한 저장소다. 엔드포인트 인벤토리, 세션 텔레메트리 정규화, 2단계 LLM 탐지기, 그리고 300개가 넘는 과제로 된 벤치마크까지 들어 있다. 이 글은 구조와 설계 결정, 직접 돌려 본 결과, 도입 시 주의점을 실무자 관점에서 정리한다.
한눈에 보는 프로젝트 현황
| 항목 | 확인한 값 (10/8 KST 기준) | 해석 |
|---|---|---|
| 저장소 | uber/ADR (Python, Apache-2.0) |
Discovery·Sensor·Detection 세 하위 프로젝트가 각자 pyproject.toml과 uv.lock을 가진 모노레포 |
| 별 / 포크 | 1,930 / 199 (16:52 KST, Trending 페이지) | 같은 시각 Python 일간 Trending 11위, ‘오늘 +25’. 규모보다 내용이 눈에 띄는 저장소 |
| main 상태 | HEAD 8ba1173 (10/7 23:23 KST), Sensor에 OTel GenAI 속성 옵션 추가 |
최근 2주 동안 Antigravity 지원, 런타임 로그, 구조화 트리아지 계약 등이 연달아 들어왔다 |
| 릴리스 | sensor-v1.0.0 태그 (8/1 03:42 KST), PyPI adr-sensor 1.0.0 |
정식 배포 패키지는 Sensor뿐. Discovery(0.2.0)와 Detection은 소스에서 실행 |
| 논문 | MLSys 2026 Industry Track 채택, arXiv 2605.17380 | PDF와 발표 슬라이드가 docs/에 함께 들어 있다 |
| 운영 이력 (논문 기준) | 우버에서 10개월 이상 운영, 7,200대 이상 호스트, 하루 1만 세션 이상 | 회사 자체 수치이며 이 저장소로 재현할 수 있는 값은 아니다 |
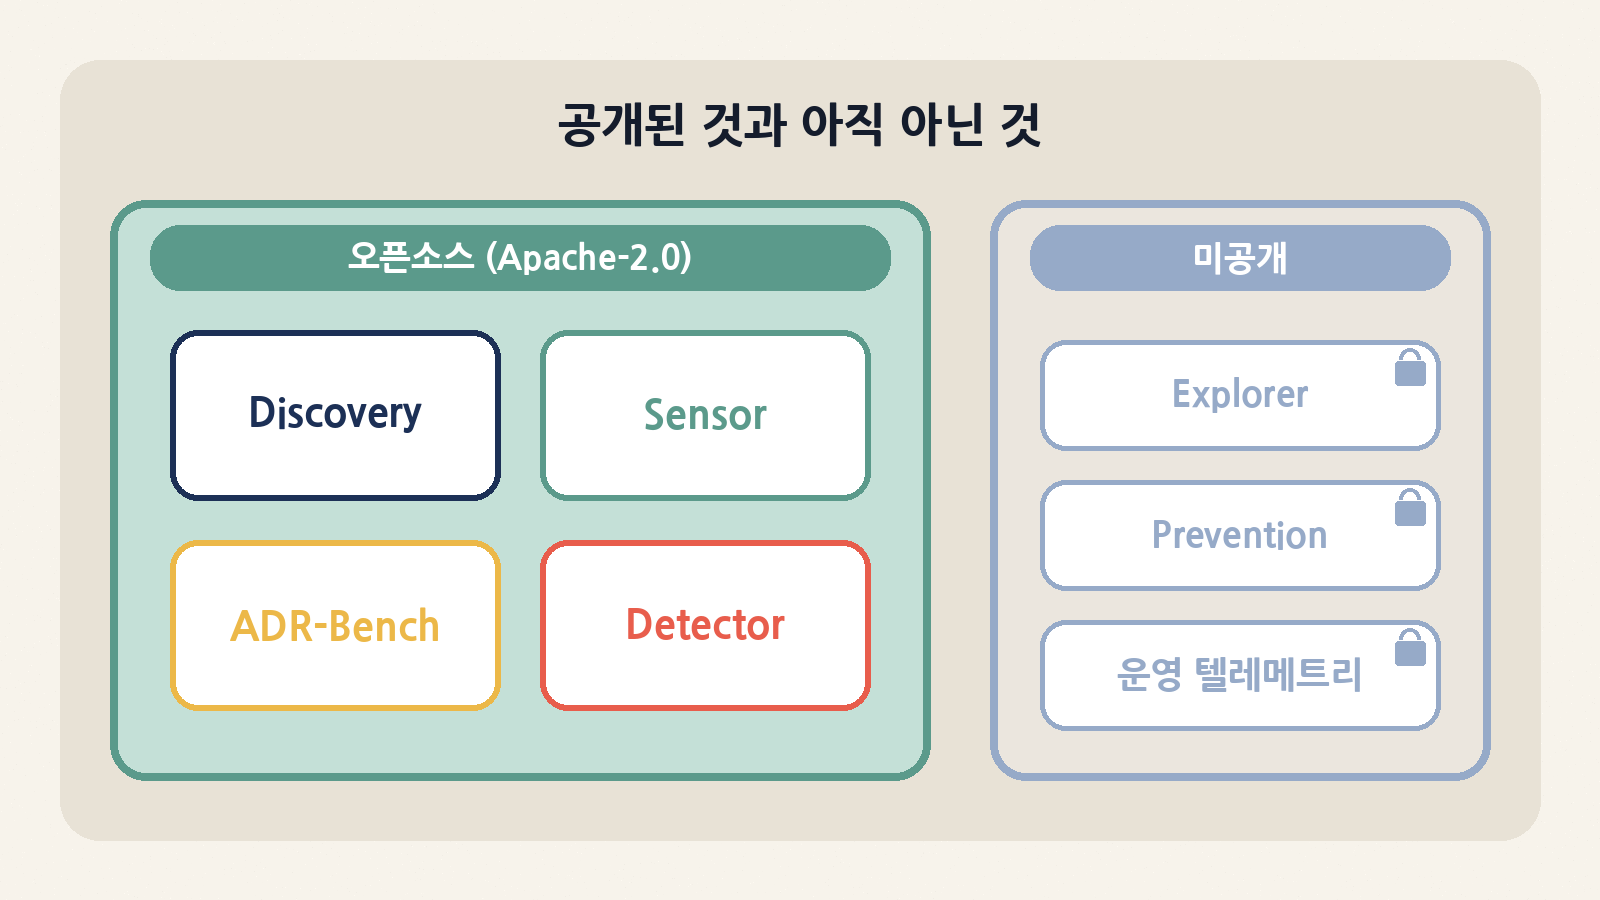
README는 ADR의 역할을 다섯 가지로 나눈다. 승인되지 않은 AI 도구 찾기(Discovery), 에이전트 활동 관찰(Observability), 방어 성능 평가(Benchmark), 위협 탐지(Detection), 위험 동작 차단(Prevention)이다. 이 중 앞의 넷이 공개됐고 Prevention과 오프라인 레드팀 엔진 Explorer는 빠졌다. 처음부터 이 경계를 알고 보면 기대치를 맞추기 쉽다. 지금 공개된 ADR은 ‘막는 시스템’보다 ‘보고 판정하는 시스템’이다.
저장소 구조: 세 개의 독립 패키지
| 경로 / 구성 요소 | 역할 | 구현·의존성 | 공개 여부 |
|---|---|---|---|
Discovery/ — ADR Discovery |
엔드포인트에 깔린 AI 앱·CLI 에이전트·IDE 확장·로컬 모델 런타임·MCP 서버·스킬을 찾아 목록화 | Python 3.11+, 런타임 의존성 없음(표준 라이브러리만) | 공개 |
Sensor/ — ADR Observability |
각 에이전트의 로컬 세션 로그를 읽어 하나의 AgentEvent 스키마로 정규화 |
Python 3.9~3.13, tabulate·zstandard, OTel은 선택 extra |
공개, PyPI 1.0.0 |
Detection/ — ADR Detector |
Tier 1 트리아지 + Tier 2 추론 에이전트로 세션을 판정 | Python 3.10~3.12, OpenAI·Anthropic SDK, Claude Code CLI, MCP | 공개 |
Detection/ — ADR-Bench |
업무형 과제 304개, MCP 서버 134개, 공격 기법 17종 | AgentDojo 벤더링, 고정 버전 의존성(일부 CVE 포함) | 공개, 연구용 |
| ADR Explorer | 배포 전 레드팀으로 어려운 공격 변형을 생성 | — | 미공개 |
| ADR Prevention | 위험한 동작을 실행 전에 차단 | — | 미공개 (README: ‘Stay tuned’) |
세 하위 프로젝트 사이에는 코드 의존이 없다. 논문 속 운영 구성에서는 Sensor가 만든 세션 기록을 탐지기가 판정하지만, 공개 저장소에서 Detection은 벤치마크 대화 파일을 입력으로 받는다. 연결 고리는 import가 아니라 데이터 형식이다. 그래서 Sensor만 떼어 기존 SIEM에 붙이거나 Discovery만 자산 관리 파이프라인에 넣는 부분 도입이 자연스럽다. 반대로 Python 요구 버전이 패키지마다 다르다(Sensor 3.9+, Discovery 3.11+, Detection 3.10~3.12). 하나의 가상환경에 몰아넣지 말고 하위 디렉터리마다 uv sync하는 게 맞다.
Sensor: 열한 가지 에이전트 로그를 하나의 스키마로
Sensor는 각 에이전트가 로컬에 남기는 세션 기록을 읽는다. Claude Code는 ~/.claude/projects/의 JSONL(서브에이전트 대화 포함), Cursor는 SQLite state.vscdb, Codex CLI는 JSONL 롤아웃과 state_*.sqlite 카탈로그, Copilot CLI는 ~/.copilot/session-state/, opencode는 SQLite 또는 옛 JSON 트리, DeepSeek Harness는 Zstandard 압축 JSONL을 읽는다. 여기에 Cline, Claude Desktop 에이전트 모드, Warp, Gemini CLI, Google Antigravity까지 소스 키가 모두 11개다. 파서는 모두 BaseParser를 구현하고, 결과는 session_id·chat_history·tools(이름, 인자, 결과, 상태)·model·project_path를 갖는 AgentEvent로 통일된다.
설계에서 눈여겨볼 점은 세 가지다. 첫째, 에이전트를 건드리지 않는다. 훅이나 프록시를 심지 않고 이미 디스크에 있는 기록을 읽기 전용으로 연다(opencode·Codex SQLite도 read-only로 연다). 대신 실시간성이 없고, 에이전트가 저장 형식을 바꾸면 파서가 깨진다. 그래서 소스마다 adr.sensor.health 진단 레코드를 남기고 suspected_schema_drift 플래그로 형식 변화를 의심하게 했다. 둘째, 증분 수집이다. 기본 조회 기간은 14일이고, --save-sessions는 도구가 끝나거나 대화가 재개될 때 스냅숏을 갱신한다. 셋째, OpenTelemetry 내보내기는 기본 꺼짐이고, 켜면 세션 하나가 adr.agent.session LogRecord가 된다. 최신 커밋은 OTel GenAI 시맨틱 컨벤션 속성(gen_ai.conversation.id 등)을 선택 옵션으로 붙여, 에이전트가 스스로 보내는 텔레메트리와 조인할 수 있게 했다.
pip install "adr-sensor[otel]"
adr-sensor --source claude --save-sessions          # 증분 스냅숏
adr-sensor --output-format jsonl --output-dir ./out
adr-sensor --no-save --otel-config ./opentelemetry-config.json   # 파일 없이 OTLP로만
운영상 가장 중요한 경고는 README에 있다. 도구 인자와 결과는 (Claude Code 소스 기준) 1,000자에서 잘릴 뿐 마스킹되지 않는다. OTel 내보내기도 필드를 거르지 않으므로 프롬프트, 소스 코드, 자격 증명이 수집 서버로 그대로 갈 수 있다. 논문은 우버 운영에서 가능한 범위의 자동 비밀값 제거, 13개월 보관, 최소 권한 접근, 전송 구간 TLS를 적용했다고 밝히지만 이 정책들은 저장소 밖의 일이다. 도입하는 쪽이 수집 파이프라인에 마스킹 단계를 직접 넣어야 한다.
Detector: 싸게 거르고, 의심만 깊게
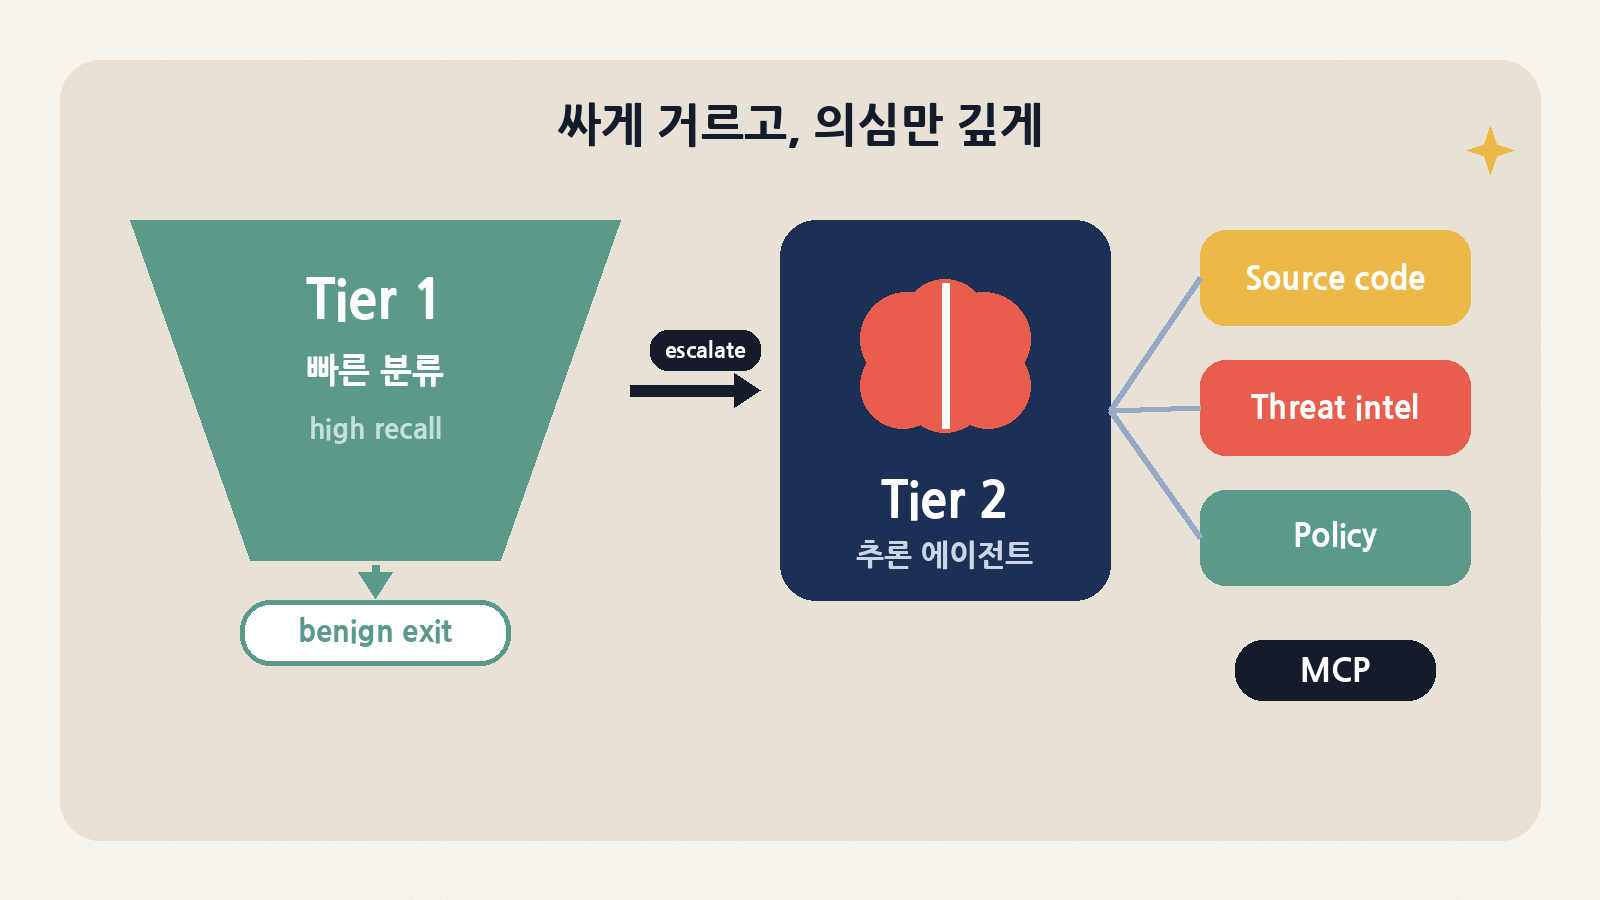
기업의 에이전트 트래픽은 대부분 정상이고 공격은 드물다. 모든 세션을 비싼 추론 모델에 넣으면 비용이 감당되지 않고, 규칙만 쓰면 교묘한 공격을 놓친다. ADR은 보안관제(SOC)의 1차·2차 분석 구조를 그대로 옮겼다.
| 단계 | 무엇을 보나 | 구현 | 논문 기준 비용·지연 |
|---|---|---|---|
| 0. 결정적 사전 검사 | Unicode Tag Block(U+E0020~E007E) ‘ASCII 밀수’, bidi 제어 문자, 그 이스케이프 문자열 형태 | 정규식·코드포인트 검사. 걸리면 LLM 트리아지를 건너뛰고 바로 Tier 2로 | LLM 호출 없음 |
| 1. 트리아지 | 인젝션 문구, 자격 증명·권한 접근, 역할 변경, ‘하나씩은 무해한’ 위험 조합 | gpt-4o, temperature 0. 애매하면 무조건 상향(escalate) |
과제의 40.7%를 여기서 종료, 과제당 $0.017·2.3초 |
| 2. 추론 에이전트 | MCP 도구의 실제 소스, 위협 인텔리전스, 사내 정책을 대조해 최종 판정 | Claude Code CLI(claude-sonnet-4-6)를 MCP 설정과 함께 서브프로세스로 실행 |
과제당 $0.029·29.7초 |
| 전체 평균 | — | — | ADR-Bench 과제당 $0.024, 평균 18.5초, P95 37.9초 |
Tier 2의 핵심은 ‘문맥을 스스로 고르는’ 추론이다. 추론 에이전트에는 MCP 서버 세 개가 붙는다. get_source_code는 대화에 나온 MCP 도구의 실제 구현을 보여 주고, get_threat_framework는 알려진 전술·기법을, get_policies·assess_policy_violations는 사내 보안 규칙을 돌려준다. 파일 쓰기라면 셋을 다 부르고 단순 읽기라면 정책만 확인하는 식으로 에이전트가 고른다. 위협 저장소 항목에는 Explorer가 찾은 것은 [EAS], 분석가가 넣은 것은 [CURATED] 태그가 붙는다.
최근 추가된 두 기능도 실무적이다. decision_contract: "structured_risk_route_v1"을 켜면 Tier 1이 자유 텍스트 대신 BENIGN_EXIT/ESCALATE와 위험·인젝션·권한·증거 필드를 스키마로 낸다. 출력이 깨지거나 앞뒤가 안 맞으면 무조건 상향으로 처리하고, Tier 1의 자유 텍스트는 Tier 2의 신뢰 프롬프트 칸에 복사하지 않는다. 탐지기 자신이 인젝션 경로가 되지 않게 막은 것이다. 또 결과 파일마다 run_manifest가 붙어 소스 리비전, 선택된 과제, 입력 대화·라벨·설정의 SHA-256을 남긴다. 경로·호스트·프롬프트는 저장하지 않는다. 모델이나 프롬프트를 바꿀 때 회귀 비교의 근거가 된다.
구현 쪽 주의점도 있다. Tier 2는 claude CLI를 --mcp-config, --disallowedTools file_edit,create_file,str_replace_editor, --dangerously-skip-permissions로 호출한다. 편집 계열 도구는 막았지만 권한 확인은 끈 상태이므로, 탐지기는 공격 페이로드가 담긴 대화를 읽는 격리된 분석 호스트에서 돌려야 한다.
ADR-Bench: 무엇으로 평가했나
| 구성 | 값 (저장소에서 직접 집계) | 메모 |
|---|---|---|
과제 (tasks.json) |
304개 = 정상 261 + 악성 43 | 논문은 302개(260+42). 버그 수정으로 정상 1개, Tag Block 인젝션 과제 task_304 1개가 추가됨 |
| 녹화된 대화 (패킹된 JSONL) | 303개 과제 디렉터리로 풀림 | task_304는 아직 녹화가 없어 탐지 실행 시 ‘dropped’로 집계된다 |
| 공격 기법 | 17종 | 최다는 Agentic Control-Flow Hijacking 13건, 이어 Semantic Data Poisoning 4건 |
| MCP 서버 레지스트리 | 134개 (local 103, local_environment 12, community 15, official 4) | 정상 도구 78, 취약점을 심은 도구 26, 환경 에뮬레이션 12 |
| 컨텍스트 제공 MCP | 3개 | 소스 코드 분석기, 위협 인텔리전스, 정책 저장소 — Tier 2 전용 |
ADR-Bench의 과제는 “분석 에이전트와 보고 에이전트 사이의 데이터 공유를 조정해 달라”처럼 평범한 업무 요청이다. 그런데 연결된 MCP 서버 중 일부가 범위를 넘어선 데이터 수집, 응답 속 하드코딩된 자격 증명, 커뮤니티 서버로 위장한 위치 수집기 같은 함정을 품고 있다. 에이전트는 기본 도구 80여 개를 막고 MCP만 쓰도록 강제된다. 녹화된 대화가 약 10MB JSONL로 패킹돼 있어서, 에이전트를 다시 돌리지 않고 inflate한 뒤 바로 탐지기만 평가할 수 있다.
논문이 보고한 성능
아래 수치는 모두 논문 Table 2와 본문 절제 실험에서 옮긴 것이다(302개 과제 기준). 직접 측정한 값이 아니다.
| 벤치마크 / 탐지기 | 정밀도 | 재현율 | F1 | TP / FP | 과제당 비용 |
|---|---|---|---|---|---|
| ADR-Bench · ADR | 1.000 | 0.667 | 0.800 | 28 / 0 | $0.024 |
| ADR-Bench · ALRPHFS | 0.333 | 0.405 | 0.366 | 17 / 34 | $0.001 |
| ADR-Bench · GuardAgent | 0.231 | 0.214 | 0.222 | 9 / 30 | $0.012 |
| ADR-Bench · LlamaFirewall | 0.167 | 0.190 | 0.178 | 8 / 40 | $0.459 |
| AgentDojo · ADR | 0.927 | 1.000 | 0.962 | 38 / 3 | $0.012 |
| AgentDojo · LlamaFirewall | 0.638 | 0.974 | 0.771 | 37 / 21 | $0.012 |
| ADR-Bench 절제 · 트리아지 제거 | 0.943 | 0.805 | 0.868 | FP 2건 발생 | $0.031 (+29%) |
| ADR-Bench 절제 · 소스 코드 검사 제거 | — | 0.571 | 0.676 | — | — |
읽는 법이 중요하다. ADR은 ADR-Bench에서 오탐 0건을 얻은 대신 공격 42건 중 14건을 놓쳤다. 오탐 하나가 사고 대응 비용으로 이어지는 운영 환경을 위해 정밀도를 택한 결과다. 트리아지를 빼면 재현율이 0.805로 오르지만 오탐 2건이 생기고 비용이 29%, 지연이 52% 늘어난다. 즉 Tier 1의 상향 기준이 정밀도-재현율-비용을 함께 조절하는 손잡이다. 소스 코드 검사를 빼면 재현율이 0.571로 가장 크게 떨어진다. MCP 도구가 “설명과 다르게 동작하는” 공격이 많기 때문이다. 전술별로는 권한 남용(Permission Abuse) 탐지율이 20%(5건 중 1건)로 가장 낮았다.
운영 수치는 더 냉정하다. 논문에 따르면 사람 검토 큐로 올라간 알림 가운데 실제 위협은 34%, 사내 레드팀 활동 같은 ‘악성 아닌 진짜 탐지’가 17%, 오탐이 49%였다. 오탐 대부분은 큰 다중 파일 코드베이스를 분석하는 복잡한 세션에서 나왔다. 가장 자주 잡힌 위협은 자격 증명 노출이고, 정규식과 엔트로피 기반의 프롬프트 전송 전 훅으로 이 부분을 차단하는 층(정밀도 97.2%, 206건 탐지)을 따로 운영했다고 한다. 정적 패턴은 비싸지 않은 규칙으로, 의미 판단은 LLM으로 나눈 셈이다.
Discovery: ‘깨끗하다’와 ‘못 봤다’를 구분하는 인벤토리
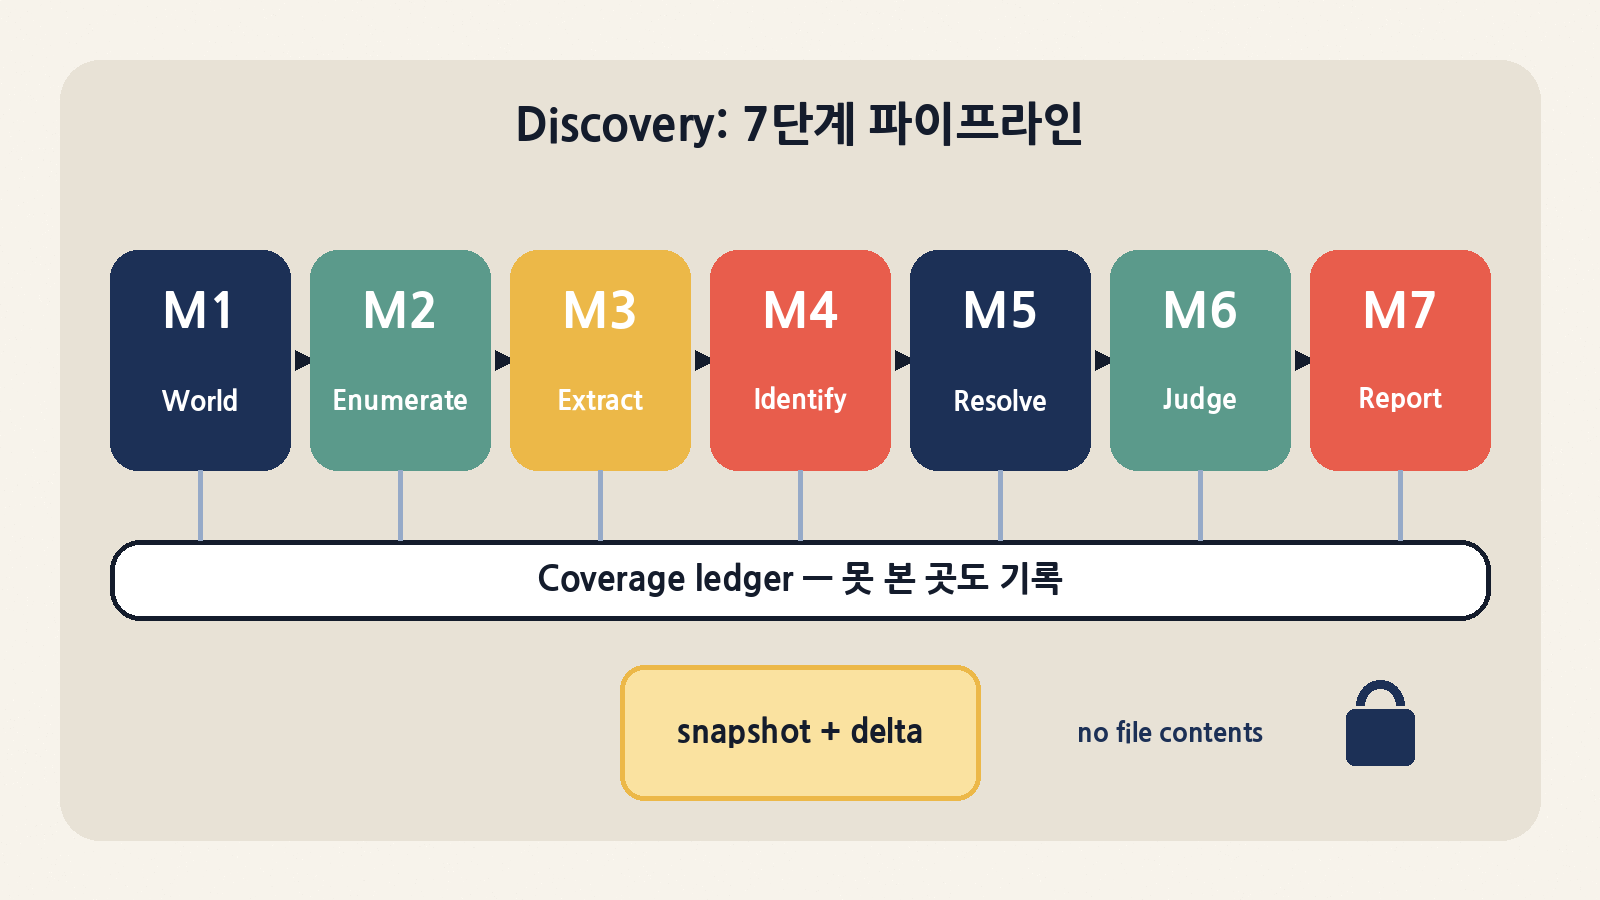
Discovery는 M1(머신 접근)부터 M7(보고)까지 7단계 파이프라인이다. 패키지 DB(dpkg, brew, npm, pipx, uv, cargo 등), 앱 레지스트리, /proc·리스닝 소켓, 브라우저·IDE 확장 상태, 외부 연결을 먼저 조회한다. 어디에도 인덱스되지 않는 저장소·에이전트 디렉터리·스킬 폴더는 .git, .claude/, .mcp.json, skills/ 같은 표식으로 너비 우선 탐색한다. 모든 머신 읽기는 M1 한 곳을 거치며 예산과 거부 목록을 적용받는다. 단계 경계는 import 그래프 테스트로 강제된다.
가장 좋은 설계는 커버리지 원장이다. 각 단계는 읽지 못한 곳, 잘린 곳, 사용할 수 없는 소스를 원장에 적는다. 하나라도 있으면 스냅숏은 내되 종료 코드 2를 돌려준다. ‘부분 스캔’이 ‘깨끗한 장비’로 읽히는 사고를 막는 장치다. 프라이버시 원칙도 분명하다. 파일 내용은 수집하지 않고 경로·메타데이터·해시·허용된 설정 키만 남긴다. 환경 변수는 이름만 남기고 값은 버리며, URL의 쿼리·userinfo도 지운다. 마스킹은 마지막에 한 번 거르는 대신 위험한 텍스트를 만지는 단계 안에서 한다. 알려진 도구 카탈로그는 코드가 아니라 데이터(catalog.json, 현재 2026.08.22판, 37개 항목)라서 릴리스 없이 갱신할 수 있다.
cd ADR/Discovery
uv run adr-discovery --dry-run --explain     # 무엇을 어떻게 수집·마스킹하는지 출력
uv run adr-discovery --dry-run --json        # 스냅숏을 디스크에 쓰지 않고 출력
uv run adr-discovery --diff prev.json --dry-run --json   # 이전 스냅숏과 비교
README가 밝힌 한계도 적어 둔다. 실행 저널(ESF·eBPF·ETW) 수집기는 모델만 있고 동봉되지 않았다. Linux·macOS의 DNS 캐시 조회도 안 된다. WSL·컨테이너·원격 에이전트·코드 서명 수집은 아직 없다. 인벤토리하고 있는데도 coverage.out_of_scope에 instruction 파일과 훅이 남아 있는 어휘 불일치도 문서가 스스로 인정한다. 실제로 박스 스캔에서도 이 필드에 세 항목이 그대로 찍혔다.
직접 돌려 본 결과
Linux 박스(x86_64)에서 세 패키지의 테스트와 키 없이 가능한 경로만 실행했다. Sensor 실행에는 실제 사용자 기록 대신 합성 Claude Code 대화를 담은 임시 HOME을 썼다.
| 점검 항목 (박스: Linux x86_64, Python 3.12, 10/8 KST) | 결과 | 메모 |
|---|---|---|
Sensor 단위 테스트 uv run pytest -q |
608 passed (3.7초) | uv sync --all-extras 후 실행, 실패 없음 |
Discovery 단위 테스트 uv run pytest -q |
277 passed (2.0초) | 표준 라이브러리 구현이라 설치가 가볍다 |
| Detection 단위 테스트 | 251 passed (6.8초) | 전체 uv sync는 nemoguardrails가 끌어오는 annoy의 C++ 빌드가 실패(박스에 c++ 없음). 그래서 torch·llamafirewall 없이 락 파일 버전(mcp 1.11.0, pytest 8.4.1 등)만 맞춘 가벼운 venv에서 돌렸다 |
benchmark_pack.py inflate |
303개 과제 대화가 0.4초 만에 풀림 | README 설명과 일치 |
adr-discovery --dry-run --json |
약 14.7초, 종료 코드 2(부분 커버리지), 자산 13개·발견 사항 1건 | 자산은 박스에 있던 MCP 설정 파일·CLAUDE.md·AGENTS.md. 발견 사항은 버전이 고정되지 않은 MCP 서버(unpinned_mcp_server, medium). 접근 거부 102곳, DNS 캐시·실행 저널은 ‘unavailable’로 기록 |
adr-sensor --source claude (합성 대화) |
대화 1·메시지 3·도구 2로 정규화 | 가짜 .env 읽기 결과(합성 토큰)가 result 필드에 그대로 담겼다. 문서 경고대로 Sensor는 마스킹하지 않는다 |
| 실행하지 않은 것 | — | ADR 이중 에이전트 탐지(OpenAI·Anthropic 키와 Claude CLI 필요), LlamaFirewall 기준선(torch 필요), 실제 벤치 실행, macOS·Windows |
정리하면 Sensor와 Discovery는 설치와 실행이 가볍고 테스트도 촘촘하다. 반면 Detection은 연구용 재현 환경이다. 의존성에 torch·transformers·nemoguardrails·langchain·google-cloud-aiplatform이 고정 버전으로 들어 있고, README도 일부에 알려진 CVE가 있어 격리 환경에서만 쓰라고 경고한다. 빌드 도구가 없는 최소 이미지에서는 annoy 빌드부터 막힌다.
# 논문 Table 2 재현 흐름 (API 키 + Claude CLI 필요)
cd ADR/Detection && uv sync
export ANTHROPIC_API_KEY=... OPENAI_API_KEY=...
uv run python benchmark/benchmark_pack.py inflate \
  benchmark/adr_bench_20251017_151604.jsonl \
  --output-dir benchmark/adr_bench_20251017_151604
uv run python main_detector.py --results-dir benchmark/adr_bench_20251017_151604
uv run python plot_paper_figures.py --benchmark-dir benchmark/adr_bench_20251017_151604 --output-dir figs
대안과 비교
| 접근 | 대표 예 | 강점 | ADR과의 차이 |
|---|---|---|---|
| 전통 EDR | 상용 엔드포인트 보안 제품 | 프로세스·파일·네트워크 가시성, 기존 SOC 연동 | 파일 쓰기는 보지만 ‘왜’ 썼는지(프롬프트·추론·도구 호출 사슬)는 못 본다. ADR은 이 의미 계층을 채운다 |
| 인라인 가드레일 | LlamaFirewall, NeMo Guardrails | 요청 경로에서 즉시 차단, 규칙·분류기 기반 | 실시간 차단이 장점이지만 기업 문맥(도구 소스·정책)을 대조하지 않는다. ADR은 사후·근실시간 탐지가 중심이고 차단 모듈은 아직 미공개 |
| LLM 판정형 가드 연구 | GuardAgent, ALRPHFS | 정책을 LLM이 해석 | 논문 비교에서 오탐 30~34건. ADR은 2단계 분리와 MCP 문맥으로 오탐 0건을 보고 |
| MCP 설정 정적 스캐너 | MCP 서버 설정·도구 설명 점검 도구들 | 설치 전에 빠르게 위험 신호 확인 | ADR Discovery가 비슷한 인벤토리 역할을 하되, 실제 세션 행동은 Sensor·Detector가 따로 본다 |
ADR은 이 도구들을 대체하기보다 그 사이의 빈칸을 메운다. EDR이 못 보는 의미 계층(프롬프트→추론→도구 호출)을 Sensor가 채우고, 인라인 가드레일이 못 하는 기업 문맥 대조를 Tier 2가 맡는다. 실시간 차단이 필요하면 지금은 별도 훅이나 가드레일을 앞에 두고 ADR을 근실시간 탐지·포렌식 계층으로 쓰는 구성이 현실적이다.
라이선스·보안·운영 주의점
- 라이선스: 저장소 전체가 Apache-2.0이다. 다만
Detection/benchmark/agentdojo/는 MIT인 서드파티 코드이고, YAML 로더 일부는 CC BY-SA 3.0 코드 조각을 포함한다(NOTICE.md). ALRPHFS·GuardAgent 기준선 코드는 라이선스 문제로 제거돼, 표의 해당 수치는 논문 값일 뿐 저장소로 재현할 수 없다. - 합성 공격 자료: 벤치 픽스처에는 가짜 AWS 키, 토큰, 인젝션 페이로드, 취약한 MCP 서버가 들어 있다. 비밀 스캐너가 경보를 낼 수 있고, 프로덕션 네트워크에 노출하면 안 된다.
- 모델 종속성: 기본 구성은
gpt-4o와claude-sonnet-4-6이다. 논문은 프롬프트·버전 고정과 ADR-Bench·AgentDojo 회귀 테스트로 모델 드리프트에 대응한다고 밝힌다. 다른 모델로 바꾸면 수치는 다시 재야 한다. 사내 데이터를 외부 API로 보내는 문제도 별도로 검토해야 한다. - 텔레메트리 민감도: Sensor 출력은 그 자체로 민감 데이터다. 수집 서버 접근 통제, 보관 기간, 마스킹을 먼저 설계하고 배포해야 한다. 사용자 고지와 노동·개인정보 관련 법적 검토도 국내에서는 필수다.
- 성숙도: Detection의 분류는 ‘Alpha’이고, Discovery는 3개 OS 골든 엔드포인트 코퍼스가 미완성이라고 스스로 적었다. Sensor만 1.0이다.
누가 도입하면 좋은가
- 코딩 에이전트를 전사 배포했거나 앞둔 보안팀: Discovery로 ‘누가 무엇을 깔았나’부터 파악하고, Sensor를 OTLP로 기존 로그 파이프라인에 붙이는 것만으로도 가시성이 크게 달라진다.
- 에이전트 가드레일·탐지기를 연구하거나 비교하는 팀: 녹화된 303개 대화와 정답 라벨, 실행 매니페스트가 있어 같은 조건에서 자기 탐지기를 재 볼 수 있다.
- 신중해야 할 경우: 즉시 차단이 핵심 요구인 조직(Prevention 미공개), 외부 LLM API로 세션 내용을 보낼 수 없는 환경(탐지기 모델을 직접 교체·재검증해야 함), Windows 중심 플릿(Discovery의 검증 범위 확인 필요).
정리하면 ADR의 가치는 탐지 정확도 숫자보다 운영 가능한 설계 원칙에 있다. 에이전트는 그대로 두고 기록을 정규화한다. 싼 1차 판정으로 거르고 비싼 문맥 추론은 의심 세션에만 쓴다. 못 본 곳은 못 봤다고 기록한다. 도입한다면 Discovery dry-run과 Sensor JSONL 수집부터 시작해 데이터 민감도를 확인하고, 탐지기는 격리 환경에서 ADR-Bench로 사내 모델 조합을 먼저 재 보는 순서를 권한다.