GitHub Trending에 오른 antirez/ds4(프로젝트명 DwarfStar)는 “아무 GGUF나 돌리는 범용 러너”가 아니다. DeepSeek V4/V4.1 Flash·PRO, GLM 5.2/5.3(Flash 포함), Qwen3.8 Flash Next처럼 고용량 소비자·워크스테이션에서 실제로 쓸 만한 소수의 오픈 웨이트에 맞춰, 로딩·프롬프트 렌더·툴콜·KV·HTTP 서버·네이티브 코딩 에이전트를 한 스택으로 통합 검증하는 네이티브 C 추론 엔진이다. llama.cpp/GGML의 경로에 빚을 지되 GGML을 링크하지 않는 설계, Metal·CUDA·ROCm 백엔드, SSD 스트리밍과 머신 간 TP/파이프라인 병렬까지 — 로컬 프론티어 MoE를 운영하려는 엔지니어에게 필요한 트레이드오프가 README·docs에 명시적으로 적혀 있다.
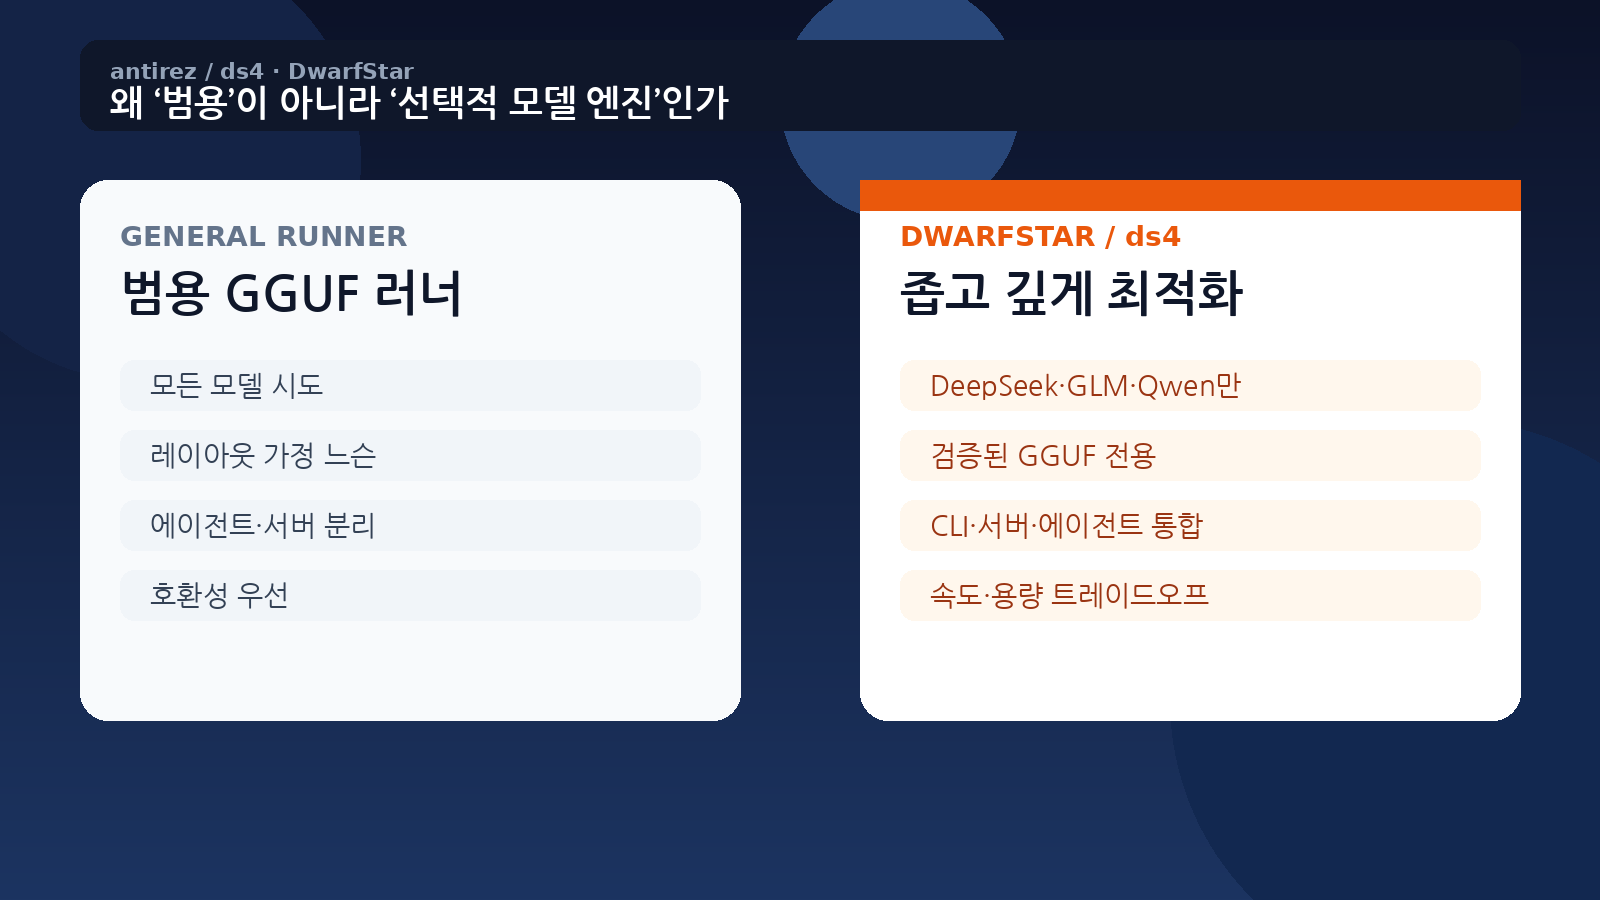
핵심 포지션: 좁힘(narrowing)이 성능 전략이다
DwarfStar의 공식 입장은 분명하다. opportunistic model support — 유용한 로컬 머신 사이즈(특히 128GB 노트북, 256/512GB 워크스테이션)에 맞는 최상위 오픈 웨이트를 따라가고, 더 나은 대체재가 오면 모델을 빼기도 한다. 임의 GGUF는 텐서 레이아웃·양자화 믹스·메타데이터·MTP 상태가 엔진 가정과 다르면 동작하지 않는다. 다운로드는 ./download_model.sh 타깃이 생성·검증한 아티팩트를 쓰는 전제다.
- 장점: 라우티드 MoE 전문가 양자화(IQ2_XXS gate/up + Q2_K down 등), Engram 디스크 상주, 비전 인코더 결합, 세션 KV를 한 경로로 QA할 수 있다.
- 비용: “내 Hugging Face GGUF 하나 던져 돌리기” 워크플로는 의도적으로 배제된다. 운영팀은 모델 카탈로그를 엔진 릴리스와 함께 버전 고정해야 한다.
- 라이선스·계보: MIT. GGUF 양자 레이아웃·일부 커널은 llama.cpp/GGML 계열을 참고·적응했고, LICENSE에 GGML 저작권 고지를 유지한다. 프로젝트는 AI 코딩 에이전트 보조로 개발됐음을 명시한다(베타·빠른 변경).
아키텍처: 코어 하나, 인터페이스 셋, 백엔드 셋
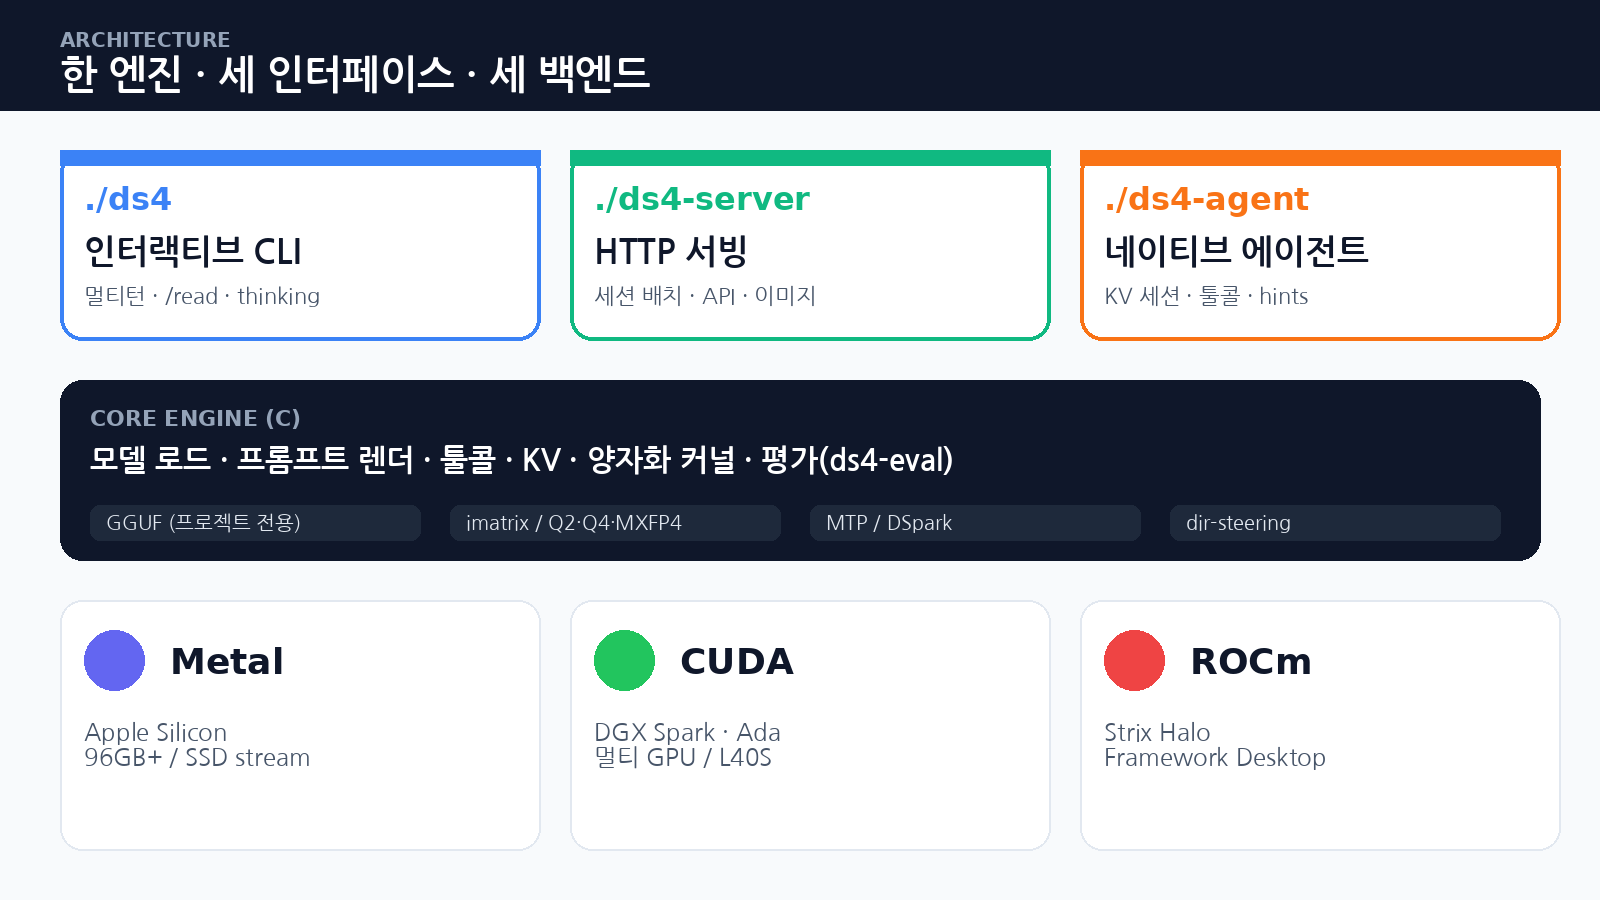
| 계층 | 구성 | 실무 함의 |
|---|---|---|
| 인터페이스 | ds4 CLI · ds4-server · ds4-agent |
같은 모델 상태·캐시를 공유. Pi/OpenCode/Codex/Claude Code는 서버+CLIENTS 가이드. |
| 코어 | 로드·렌더·툴콜·KV·양자 커널·분산/TP | 통합 테스트가 제품 경계. “추론만 빠른 바이너리”가 목표가 아님. |
| 백엔드 | Metal(주력) · CUDA(DGX Spark·Ada 멀티GPU) · ROCm(Strix Halo) | make / make cuda-spark / make cuda-generic / make strix-halo |
| 용량 확장 | SSD streaming · 2-Mac/2-Spark TP(RDMA) · pipeline layers | 네트워크 TP는 인증/암호 없음 — 신뢰 네트워크 전제. |
ds4-agent는 별도 HTTP 없이 추론을 직접 돌리며 토큰 히스토리와 라이브 모델 상태를 같이 유지한다. 세션은 ~/.ds4/kvcache에 저장되고 /save·/switch·/strip으로 관리한다. 이미지 포함 세션은 아직 저장 불가. DeepSeek/GLM 네이티브 툴 템플릿을 쓰고, /hints로 구현 선택에 대한 짧은 설명을 켤 수 있다(세션 경계에서 반영, 캐시 전체 재구축 없이).
메모리 트레이드오프: Resident vs SSD Streaming
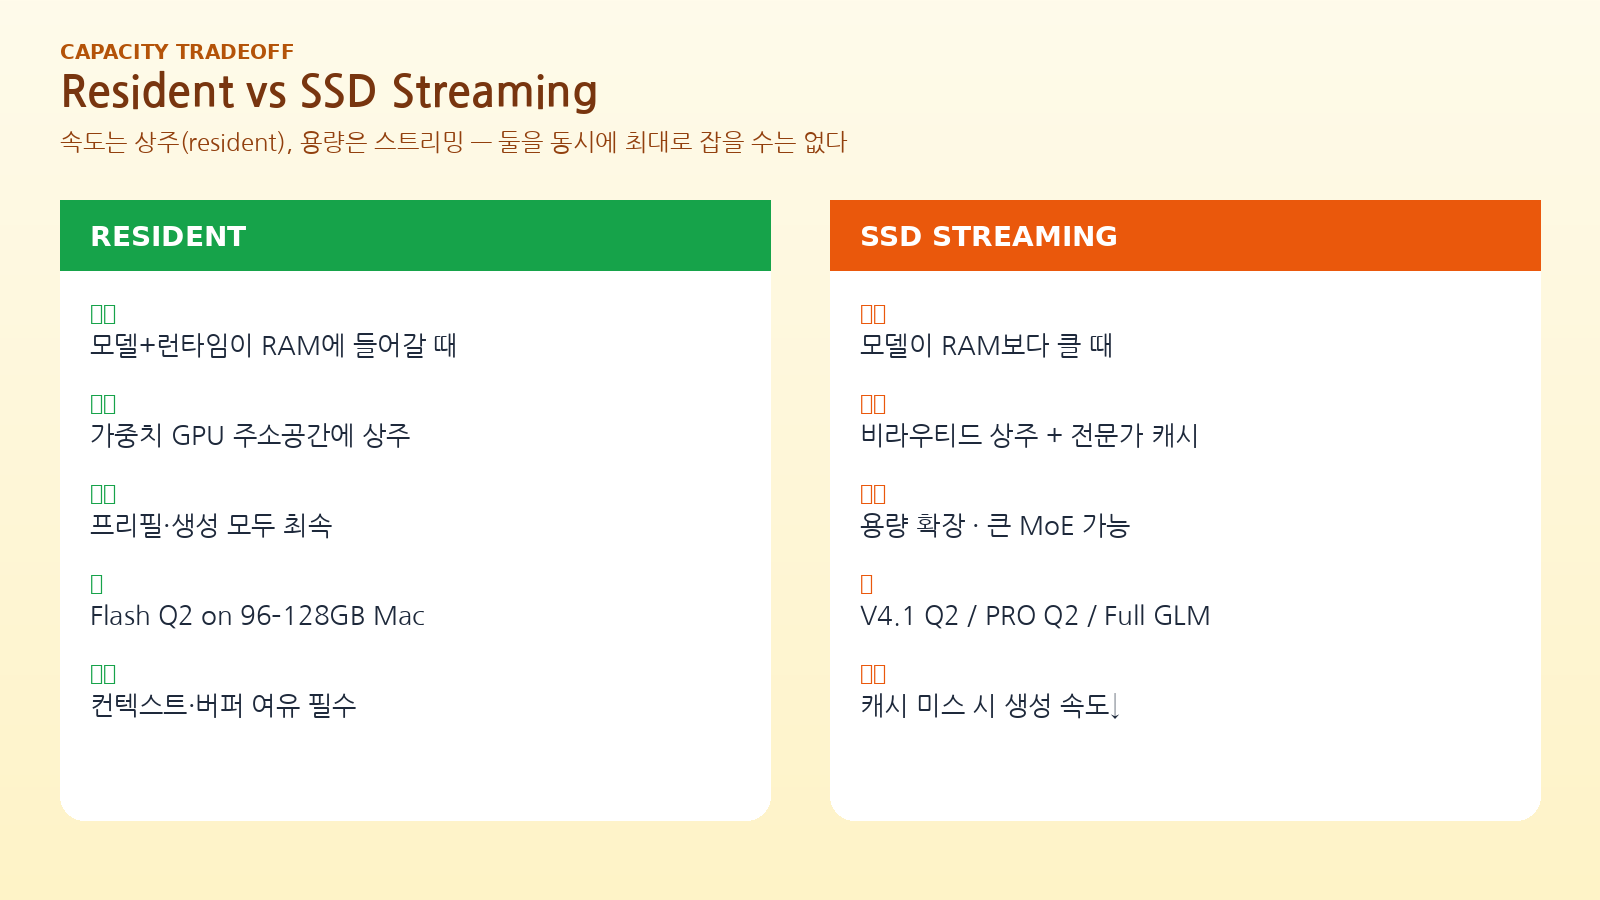
기본 경로는 resident — 모델이 GPU 주소 가능 메모리에 상주하는 것이 가장 빠르다. RAM을 넘기면 --ssd-streaming으로 비라우티드 가중치는 상주시키고, 라우티드 MoE 전문가는 바운디드 캐시 + GGUF 미스 시 디스크 로드로 간다. 이 모드는 활성·스크래치·컨텍스트 메모리까지 없애 주지 않는다. 생성은 캐시 미스에 프리필보다 민감하므로, “떴다”와 “인터랙티브하다”는 별개다.
- 첫 실행은 자동 캐시 예산 권장. 수동은
--ssd-streaming-cache-experts 32GB(바이트 예산) 또는 슬롯 수. - 전문가 캐시를 과도하게 키우면 Metal에서 비라우티드 상주를 밀어내 디코드가 오히려 느려질 수 있다.
- V4.1 Flash의 Engram 테이블(~189GiB)은 모든 모드에서 디스크에서 직접 읽힌다 — 빠른 로컬 SSD가 사실상 필수.
- 문서화된 M5 Max 128GB 스트리밍 예: GLM 5.3 Flash Q4(~178GiB) 생성 약 12–15 t/s대, DeepSeek Vision Exp MXFP4도 캐시·워크로드 의존(2026-09 측정, 보증치 아님).
모델 카탈로그(운영 관점 요약)
| 타깃 | 대략 규모 | 현실적 진입점 |
|---|---|---|
ds4f-q2 |
~81GiB급 Flash 0731 | 96–128GB 머신의 기본 시작점 |
ds4f-q4 / mxfp4 |
더 큰 상주·분산 | 고정밀·멀티머신; MXFP4는 네이티브 전문가 보존 |
ds41f-q2 |
파일 ~341GiB / 주가중치 ~152GiB + Engram | 단일 128GB는 SSD stream; 2×128GB TP 상주 가능 |
glm53-q2 |
~90GiB | 128GB Mac/Spark/ROCm; --mtp로 내장 드래프트 |
qwen38-q2 |
파일 ~137GiB / 주·MTP ~42GiB + BF16 n-gram 디스크 | 64GB Mac은 ctx 8K·prefill-chunk 1024부터 |
pro-q2-imatrix |
512GB 상주 또는 스트리밍 | 검사용 스트리밍은 가능하나 느릴 수 있음 |
스펙큘레이션은 옵트인이다. GLM/Qwen은 --mtp, V4 Flash는 체크포인트 매칭 DSpark 서포트 GGUF. 모든 워크로드에서 decode보다 빠르다는 보장은 없다 — 문서도 plain decode와 비교하라고 못 박는다. V4.1은 Metal에서 텍스트+비전, CUDA는 텍스트(스트리밍/TP) 중심이며 DSpark·일부 ROCm 경로는 모델별로 미구현인 경우가 있다.
저장소 레이아웃과 실행·평가 루프
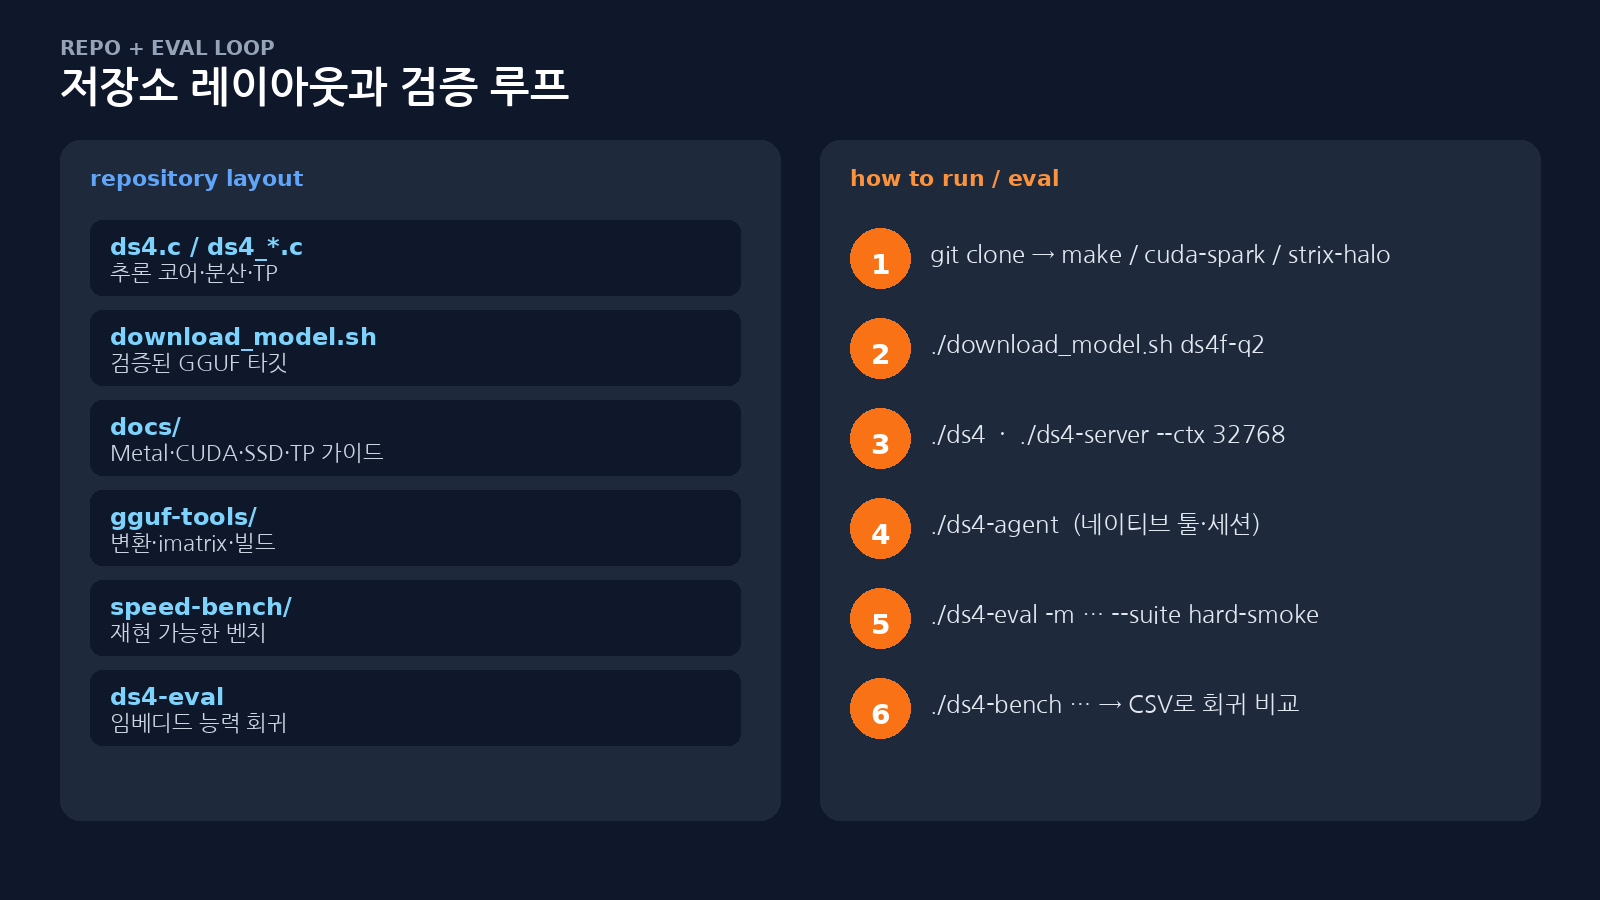
실무적으로 자주 보는 축은 다음과 같다.
- 코어 소스:
ds4.c,ds4_distributed.c,ds4_tp.c등 — 추론·분산·TP 프로토콜. - 문서:
docs/METAL.md,CUDA_MULTI_GPU.md,DGX_SPARK.md,SSD_STREAMING.md,DISTRIBUTED.md,SERVER.md,CLIENTS.md,PERFORMANCE.md,TESTING.md. - 가중치·도구:
download_model.sh,gguf/,gguf-tools/(변환·imatrix). - 품질:
ds4-eval(임베디드 capability 회귀, 리더보드 점수 아님),speed-bench/+ds4-bench(컨텍스트 스윕 CSV),QA_BEFORE_RELEASES.md.
git clone https://github.com/antirez/ds4.git && cd ds4
make                          # Metal
# make cuda-spark | make cuda-generic | make strix-halo

./download_model.sh ds4f-q2
./ds4
./ds4 -p "Explain Redis streams in one paragraph."
./ds4-server --ctx 32768
./ds4-agent

./ds4-eval -m ds4flash.gguf --suite hard-smoke --trace /tmp/ds4-eval.txt
./ds4-bench -m ds4flash.gguf \
  --prompt-file speed-bench/promessi_sposi.txt \
  --ctx-start 2048 --ctx-max 65536 --step-incr 2048 --gen-tokens 128
문서에 기록된 Flash Q2 베이스라인(동일 조건·커밋 고정 전제, 이후 커밋의 보장이 아님):
| 머신 | ctx | prefill t/s | gen t/s |
|---|---|---|---|
| M5 Max 128GB | 2K | 790 | 39.4 |
| M5 Max 128GB | 32K | 557 | 34.4 |
| DGX Spark 128GB | 2K | 826 | 18.1 |
| DGX Spark 128GB | 32K | 856 | 14.4 |
여덟 L40S Ada 멀티세션 Flash 구성에서는 aggregate generation 약 126 t/s(16 세션) 사례가 README에 언급된다. CUDA 멀티GPU·배치 세션은 docs/CUDA_MULTI_GPU.md·SERVER 문서를 기준으로 슬롯당 KV를 먼저 잡아야 한다.
분산: TP와 Pipeline을 섞지 말 것
- Tensor parallel (2 Mac / 2 Spark): 라우티드 전문가 50/50, 같은 토큰을 양 GPU가 처리. Thunderbolt RDMA(또는 TCP 폴백). 워커를 먼저 띄우고, curl/nc로 listen 포트를 “헬스체크”하면 핸드셰이크로 오인될 수 있다.
- Pipeline parallel: 레이어 구간 분할(
--layers 0:19등). 용량·긴 프리필 오버랩에 유리하고, 단일 스트림 decode 가속을 보장하지 않는다. - 피어는 동일 커밋·동일 아티팩트. 프로토콜에 인증/암호화 없음.
- 활성화 전송 비트(
--dist-activation-bits 16|8)는 가중치/KV 정밀도가 아니라 와이어 정밀도 — 바꾸면 출력 검증 필수.
Caveats (프로덕션 도입 전 체크리스트)
- 베타: 릴리스 전 QA는 돌리지만 불안정·회귀 가능. 커밋 핀 +
ds4-eval/ds4-bench를 CI에 넣을 것. - 범용 GGUF 금지: 외부 양자화를 “될 수도”로 넣지 말고 프로젝트 타깃만.
- 수치 경로 차이: scalar / batched / TP는 비트 동일을 보장하지 않는다. V4.1 Q4 batched prefill은 짧은 공식 continuation에서 소폭 score loss 사례가 QA에 기록됨.
- 보안: 로컬 서버·분산 링크는 신뢰 구역. 에이전트 세션·트레이스에 사적 데이터가 남을 수 있다(
/strip으로 KV 제거 가능). - 하드웨어 하한: “SSD면 된다”가 아니라 OS·컨텍스트·세션 수·전문가 캐시를 합산한 가드레일. Metal 메모리 가드 해제는 해결책이 아니다.
- DGX Spark 각도: 하드웨어 소개가 아니라, ds4의 CUDA 타깃·멀티GPU·네트워크 TP 중 하나다. Spark 전용 튜닝은
docs/DGX_SPARK.md를 따른다.
누구에게 맞는가
96GB+ 통합 메모리 Mac, DGX Spark/Ada 멀티GPU, Strix Halo에서 DeepSeek·GLM급 라우티드 MoE를 로컬 API·에이전트와 한 경로로 돌리려는 팀. 반대로 Arbitrary GGUF 호환·저용량 노트북 단일 경로가 우선이면 llama.cpp 계열 일반 러너가 맞다. DwarfStar는 “템플릿으로서의 엔진”을 강조한다 — 에이전트로 하드웨어 특화 패치를 얹는 전제를 README가 공개적으로 권한다.
오늘 Trending에 오른 이유는 단순 스타 수만이 아니라, 프론티어 오픈 웨이트를 ‘소유 가능한 머신’에 올리는 문제를 범용 추상화가 아니라 통합 제품으로 푼다는 점에 가깝다. 아키텍처를 이해한 뒤라면 ds4f-q2 한 방이면 포지션이 몸으로 느껴진다.