몇 년 된 거실 TV를 켜면 이런 일이 생기죠. 리모컨 버튼을 눌러도 한 박자 늦게 반응하고, 넷플릭스 하나 열려고 해도 ‘추천 콘텐츠’와 광고 줄이 먼저 화면을 꽉 채워요. 돈 주고 산 TV인데 왜 광고를 봐야 하나 싶기도 하고요.
요즘 해외에서는 이 문제를 AI에게 맡겨 해결하는 사람들이 늘고 있어요. 개발자 안섭 칸(Ansub Khan)은 AI 코딩 도구 ‘클로드 코드(Claude Code)’로 느려진 안드로이드 TV를 정리하고, 누구나 따라 할 수 있게 ‘TV 디톡스(TV Detox)’ 프로젝트를 공개했어요. 비슷한 시기에 또 다른 개발자 가틴(Gathin)은 부모님의 샤오미 TV에서 넷플릭스보다 광고가 먼저 뜨자 클로드 코드에 정리를 맡겼고, 이걸 ‘클린유어TV(CleanYourTV)’로 공개했죠. 더버지·안드로이드 어소리티에 이어 국내에서도 AI타임스가 10월 22일 소개했어요.
AI 음성 비서와 이야기해 본 적 있으시죠? “오늘 날씨 알려 줘”라고 말하면 잠깐 조용하다가 또박또박 대답해요. 그런데 내가 말하는 도중에 “아, 잠깐만” 하고 끼어들면 AI가 멈칫하거나 내 말을 끝까지 다 들은 뒤에야 엉뚱한 답을 하죠. 아무리 똑똑해도 ‘사람과 수다 떠는 느낌’과는 거리가 있었어요.
이번 주 미국 핀테크 회사 블록(Block)이 이 벽을 크게 넘었다는 AI를 공개했어요. 이름은 ‘데사(Dessa)’예요. 트위터 창업자로 유명한 잭 도시(Jack Dorsey)가 이끄는 회사로, 카드 단말기 ‘스퀘어’와 송금 앱 ‘캐시앱’을 만드는 곳이에요. 데사가 특별한 이유는 딱 두 가지예요. 글자(텍스트)를 한 줄도 보지 않고 사람의 대화 소리만 듣고 말을 배웠다는 것, 그리고 듣는 동시에 말할 수 있다는 것이에요. 공개된 녹음에서 데사는 말하다가 웃음을 터뜨리고, “응응”, “아하” 하고 맞장구를 치고, 상대가 영화 제목을 까먹자 대신 문장을 끝내 주기도 해요.
반응은 두 갈래로 갈렸어요. “공상과학 같다”는 감탄과 함께 “이제 보이스피싱이 감당 안 될 수준이 되겠다”는 걱정도 쏟아졌죠. 오늘은 데사가 뭔지, 기존 음성 AI와 무엇이 다른지, 그리고 진짜 사람 같은 AI 목소리가 흔해지는 시대에 우리 가족이 준비할 것까지 초보 눈높이로 차근차근 풀어 볼게요.
한눈에 보는 요약
| 질문 | 짧은 답 |
|---|---|
| 무슨 소식이에요? | 블록이 미국 시간 10월 23일 음성 대화 AI ‘데사(Dessa)’를 연구용 미리보기로 공개했어요 |
| 뭐가 새롭나요? | 글자 데이터·기존 AI 모델 없이 사람 대화 녹음만으로 처음부터 학습했어요. 블록은 이런 방식으로 실시간 대화가 되는 AI는 세계 처음이라고 설명해요 |
| 어떻게 대화하나요? | 소리를 듣고 바로 소리로 답하는 방식이에요. 듣는 동시에 말하는 ‘전이중(full-duplex)’이라 끼어들기·맞장구·웃음이 자연스러워요 |
| 어디서 돌아가요? | 블록 설명으로는 맥북 프로 M4 맥스급 이상 노트북에서 직접(로컬) 돌아가요. 학습에는 엔비디아 GB200 NVL72 랙 한 대만 썼대요 |
| 지금 써 볼 수 있나요? | 아니요. 일반 공개·앱·API가 없어요. 먼저 소수의 AI 안전 연구자에게만 시험용으로 열어 줘요 |
| 아직 모르는 건? | 모델 크기, 성능 점수(벤치마크), 출시일, 한국어 지원 여부는 공개되지 않았어요. 공개된 녹음은 모두 영어예요 |
| 왜 걱정이 나오나요? | 너무 사람 같아서 가족·지인을 사칭하는 음성 사기에 악용될 수 있다는 우려가 커요 |
데사는 누가, 왜 만들었을까?
데사를 만든 곳은 블록 안의 아주 작은 AI 연구실이에요. 이 연구실은 캐나다 토론토의 딥러닝 스타트업 ‘데사(Dessa)’ 출신들이 세웠어요. 스퀘어(지금의 블록)가 2020년에 인수한 회사죠. 2012년부터 딥러닝 모델을, 8년 넘게 음성 생성 모델을 만들어 온 팀이라고 소개해요. 옛 데사는 2019년 유명 팟캐스트 진행자 조 로건의 목소리를 흉내 낸 AI로 화제가 된 적도 있어요. 즉, 이번 모델 이름은 팀의 뿌리에서 따온 거예요. 연구 책임자 라가반 투라이라트남(Ragavan Thurairatnam)은 데사를 두고 “음성 분야의 GPT-3 순간”이라고 표현했어요. 챗GPT의 전신인 GPT-3가 글 AI의 가능성을 처음 크게 보여 줬듯, 음성 AI도 그런 전환점에 왔다는 뜻이에요.
블록이 밝힌 개발 이유는 세 가지예요.
| 블록이 말한 이유 | 쉬운 풀이 | 생활 속 예 |
|---|---|---|
| 호기심 (재미) | 아기는 글을 보기 전에 듣기만으로 말을 배운다. AI도 그럴 수 있을까? | 돌 지난 아이가 ‘맘마’부터 말하는 과정 |
| 사람과 AI의 더 나은 소통 | 지금 음성 AI는 목소리를 글자로 바꾸면서 감정·말투 정보를 버린다 | “괜찮아…”라고 힘없이 말해도 AI는 ‘괜찮다’로만 알아들음 |
| 안전 | AI가 점점 강력해지는데 사람 목소리 속 고통·불안을 거의 못 알아듣는다 | 아픈 목소리로 도움을 청해도 AI가 아무렇지 않게 계속 안내만 하는 상황 |
기존 음성 AI와 뭐가 다를까? ‘통역 세 번’ vs ‘바로 대화’
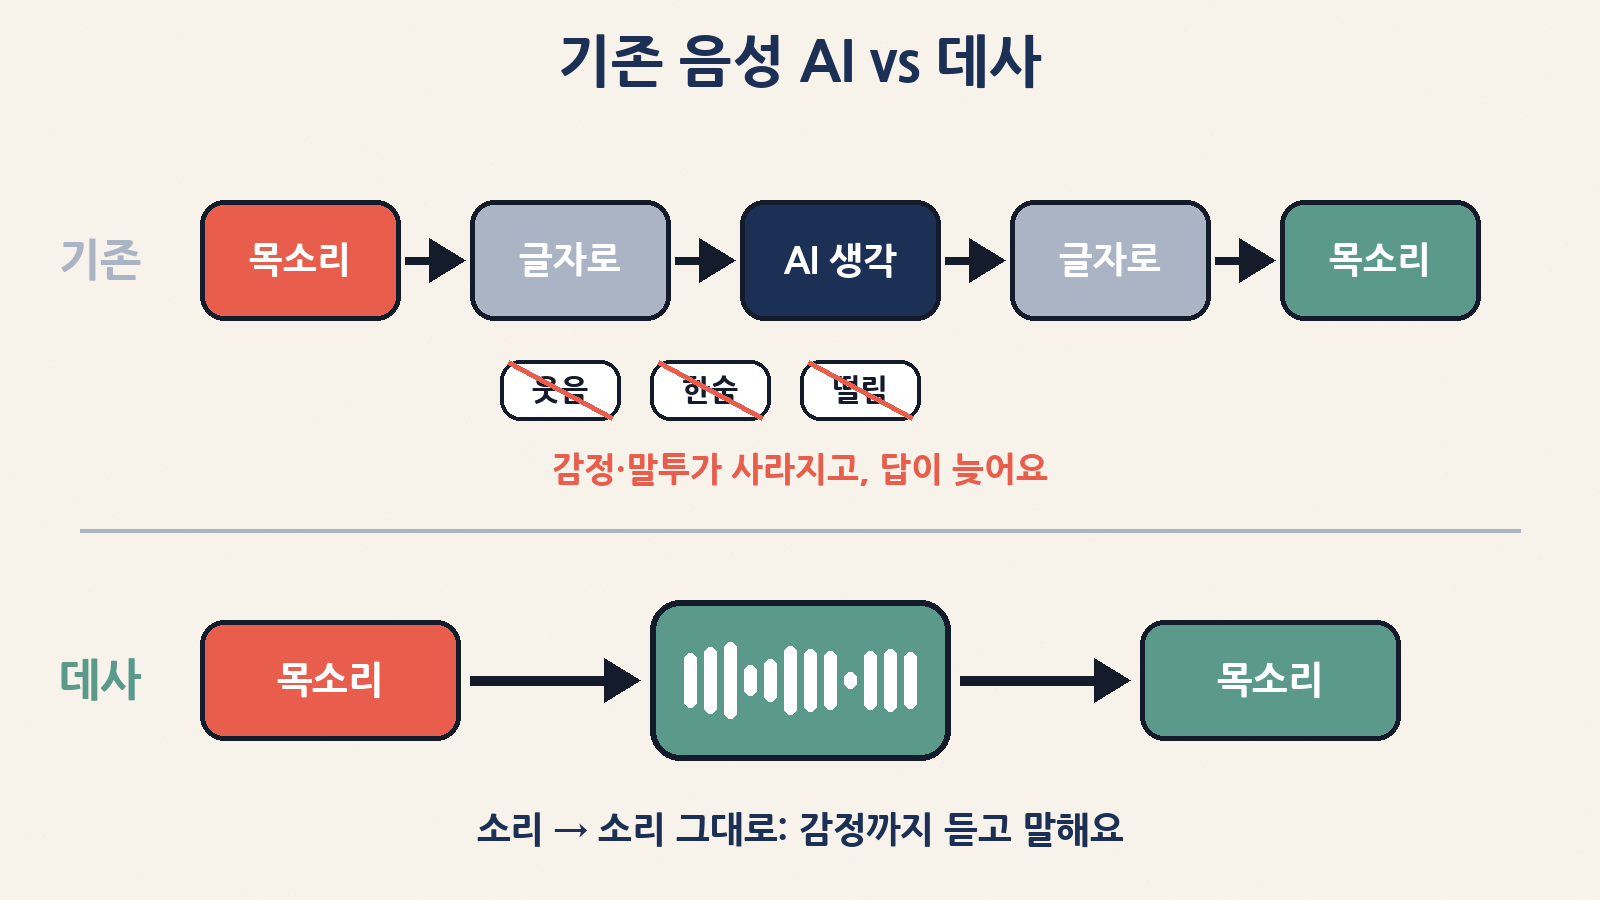
지금 우리가 쓰는 음성 비서는 대개 세 단계를 거쳐요. ① 내 목소리를 글자로 받아 적고(음성 인식), ② 그 글자를 AI가 읽고 글자로 답을 쓴 뒤(언어 모델), ③ 그 글자를 다시 목소리로 읽어 줘요(음성 합성). 비유하면 통역사를 세 번 거쳐 대화하는 셈이에요. 시간이 걸리는 건 물론이고, 받아 적는 순간 웃음, 한숨, 떨리는 목소리, 비꼬는 말투 같은 정보가 대부분 사라져요.
데사는 소리를 듣고 바로 소리로 답하는 ‘음성-대-음성(speech-to-speech)’ 모델이에요. 블록 설명대로라면 데사가 아는 모든 것은 사람 목소리에서 왔어요. 그래서 같은 문장이라도 어느 단어에 힘을 주느냐에 따라 뜻이 달라지는 것까지 그대로 듣고 반응할 수 있다는 거예요. 예를 들어 “내가 케이크 먹었다고 안 했어”와 “내가 케이크 먹었다고 안 했어”는 글자로는 똑같지만 말로 하면 전혀 다른 뜻이죠.
| 구분 | 기존 음성 비서 (3단계 방식) | 데사 (음성-대-음성) |
|---|---|---|
| 처리 순서 | 목소리 → 글자 → AI → 글자 → 목소리 | 목소리 → 목소리 |
| 감정·말투 | 글자로 바꾸며 대부분 사라짐 | 웃음·한숨·비꼼·떨림을 직접 듣고 표현 |
| 반응 속도 | 단계마다 대기 시간이 쌓임 | 실시간보다 빠르게 처리한다고 설명 |
| 끼어들기 | 내 말이 끝나야 차례가 돌아옴 | 말하면서 듣기 때문에 중간에 반응 |
| 지식의 출처 | 인터넷의 방대한 글 | 사람 대화 녹음만 (그래서 지식은 상대적으로 적을 수 있음) |
| 대표 예 | 많은 스마트 스피커·초기 음성 비서 | 데사, (비슷한 전이중 방식) 오픈AI GPT-Live 계열 |
맞아요. 오픈AI의 GPT-Live처럼 듣는 동시에 말하는 음성 AI는 이미 있어요. 다만 이런 모델들은 대개 글로 먼저 배운 거대한 언어 모델을 바탕으로 해요. 데사가 주목받는 건 글을 전혀 쓰지 않고 소리만으로 이 수준까지 왔다는 ‘배우는 방식’ 때문이에요. 공개 페이지에는 데사가 GPT-Live-1과 서로 대화하는 녹음도 올라와 있어요.
‘듣는 동시에 말하기’는 왜 그렇게 어려울까?
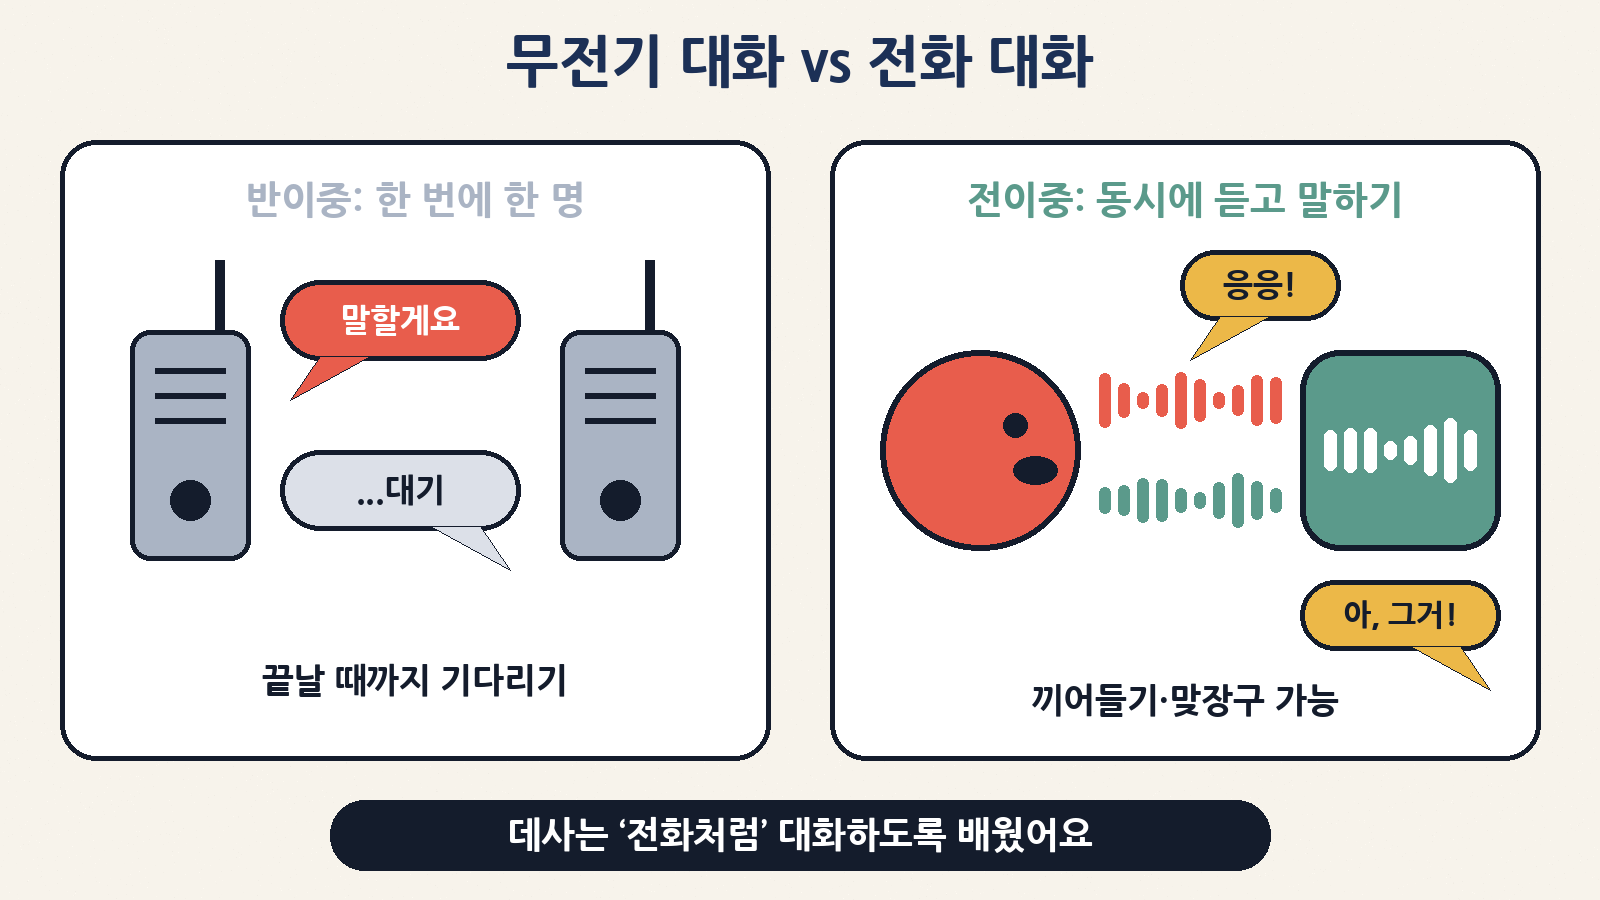
대화 방식은 무전기와 전화로 비유하면 쉬워요. 무전기는 한 사람이 버튼을 누르고 말하는 동안 상대는 듣기만 해야 해요. 이걸 반이중(half-duplex)이라고 해요. 전화는 둘이 동시에 말하고 들을 수 있죠. 이게 전이중(full-duplex)이에요. 우리가 친구와 수다를 떨 때 “응”, “헐”, “진짜?” 하고 끼어드는 건 전화 방식이라 가능한 거예요.
데사는 실제 사람들의 대화를 들으며 언제 끼어들고 언제 “응, 그렇구나” 하고 맞장구(백채널)를 칠지까지 배웠다고 해요. 공개된 녹음에는 이런 장면들이 있어요.
| 공개 녹음 장면 | 무슨 일이 있었나 | 의미 |
|---|---|---|
| 출시 이야기 | 웃긴 대목에서 말하는 도중에 바로 웃음. “더 크게 말해 줘” 하자 목소리가 커짐 | 아무도 따로 가르치지 않은 행동이라고 블록은 설명 |
| 영화 제목 기억하기 | 상대가 영화 제목을 까먹자 데사가 문장을 대신 끝내 줌 | 소리만으로 배웠는데도 상식이 꽤 있음 |
| 기념일 깜짝 소식 | 숨죽여 “오 마이 갓” 하고, 울먹이는 듯한 목소리로 고마움 표현 | 감정 표현의 폭 |
| 인생 상담 | 공감하는 듯한 말투로 대답 | 위로·상담 쪽 활용 가능성 (동시에 위험성) |
| GPT-Live-1과 대화 | AI 두 개가 서로 수다 | 다른 회사의 음성 AI와도 대화가 이어짐 |
| ‘호날두’ 장면 | 상대를 엉뚱하게 ‘호날두’라는 사람으로 착각 (더버지 지적) | 아직 어색하고 틀리는 순간도 있음 |
블록이 강조한 숫자도 있어요. 말 한 단어를 소리로 저장하면 같은 단어를 글자로 저장할 때보다 수천 배 많은 데이터가 필요해요. 게다가 같은 문장을 두 번 말해도 소리 데이터는 매번 달라요. 그런데도 데사는 거대 언어 모델(LLM)보다 수백 배 적은 단어 양으로 말을 배웠고, 학습도 엔비디아 GB200 NVL72 랙 한 대로 해냈다고 해요. 블록은 “LLM은 C++ 같은 프로그래밍 언어까지 배워야 하니까 공정한 비교는 아니다”라는 농담도 덧붙였어요.
| 용어 | 쉬운 뜻 | 비유 |
|---|---|---|
| 음성-대-음성 (speech-to-speech) | 글자를 거치지 않고 소리를 듣고 소리로 답하는 AI | 통역 없이 바로 대화 |
| 전이중 (full-duplex) | 듣기와 말하기를 동시에 | 전화 통화 |
| 반이중 (half-duplex) | 한 번에 한쪽만 말하기 | 무전기 |
| 백채널 (backchannel) | 상대 말 중간의 “응”, “아하” 같은 맞장구 | 고개 끄덕임의 소리 버전 |
| 로컬 실행 | 회사 서버가 아니라 내 컴퓨터에서 AI가 돌아감 | 배달 대신 집에서 직접 요리 |
| 연구용 미리보기 (research preview) | 일반 출시 전, 연구자에게만 먼저 열어 주는 단계 | 가오픈 전 시식회 |
| GB200 NVL72 | 엔비디아 GPU 72개를 묶은 데이터센터용 랙 한 대 | AI 학습용 ‘대형 주방’ 한 칸 |
내 노트북에서 돌아간다는 건 어떤 의미일까?
블록은 데사가 맥북 프로 M4 맥스 또는 그 이상에서 돌아간다고 밝혔어요. 수백만 원대 고성능 노트북이긴 하지만, 거대한 데이터센터가 아니라 개인 컴퓨터 한 대로 실시간 대화가 된다는 건 꽤 큰 의미예요. 장점과 단점이 같이 있어요.
| 관점 | 좋은 점 | 걱정되는 점 |
|---|---|---|
| 개인정보 | 대화가 회사 서버로 가지 않을 수 있음 | 누가 어떤 목적으로 돌리는지 밖에서 알기 어려움 |
| 속도 | 인터넷 왕복이 없어 반응이 빠름 | – |
| 비용 | 사용료(구독·API 요금) 없이 쓸 가능성 | 고성능 기기가 필요 |
| 통제 | 인터넷이 끊겨도 동작 가능 | 회사가 악용을 막는 ‘안전장치’를 중간에 걸기 어려움 |
“내 맥북에서 된다”는 건 블록의 설명일 뿐, 아직 누구나 내려받을 수 있는 파일이나 앱은 없어요. 인터넷에 ‘데사 다운로드’, ‘데사 한국어 앱’ 같은 링크가 돌면 가짜일 가능성이 높으니 누르지 마세요.
지금 써 볼 수 있을까? 현재 상태 정리
| 항목 | 현재 상태 (10월 25일 기준) |
|---|---|
| 일반인 사용 | 불가. 앱·웹사이트 체험·API 모두 없음 |
| 들어 볼 수 있는 것 | 블록 공식 페이지(block.xyz/dessa)의 녹음 샘플. 블록은 실제 사람과 나눈 생방송 녹음이며 아무도 조종하지 않았다고 설명 (자막은 나중에 추가) |
| 먼저 써 보는 사람 | 소수의 AI 안전 연구자. 위험을 찾아 달라며 연락을 받는 중 |
| 공개 안 된 것 | 모델 크기, 성능 점수, 출시일, 가격, 지원 언어 |
| 독립 검증 | 아직 없음. 지금 들을 수 있는 건 회사가 고른 시연이에요 |
여기서 하나 기억해 두면 좋은 습관이 있어요. 회사가 직접 고른 시연은 대개 가장 잘된 장면이에요. 실제 성능은 외부 연구자들이 써 보고, 일반에 공개된 뒤에야 제대로 알 수 있어요. 더버지가 지적한 ‘호날두 착각’처럼 어색한 순간도 분명 있고요. 감탄은 하되, “아직 검증 전”이라는 꼬리표를 붙여 두는 게 좋아요.
사람들은 어떻게 반응했을까? 감탄과 걱정
| 반응 | 누가 | 내용 |
|---|---|---|
| 감탄 | X(옛 트위터) 이용자들 | “이렇게 사람 같은 인공 목소리는 처음”, “완전 공상과학” |
| 교육 활용 기대 | 바이낸스 창업자 창펑 자오(CZ) | 아이들 교육용으로 좋겠다. 지금의 ‘AI 목소리’로 아이를 가르치기는 어려웠다 |
| 속임수 우려 | 영화감독 저스틴 베이트먼 | AI 목소리가 왜 사람 같아야 하나. 사람들의 경계를 풀게 하려고? |
| 사기 우려 | 인도 언론인 시브 아루르 | 사기 전화가 ‘팬데믹 수준’이 될 것 |
| 회사 입장 | 블록 | 목소리의 고통·불안을 알아듣는 AI가 오히려 더 안전. 그래서 안전 연구자에게 먼저 공개 |
진짜 같은 AI 목소리 시대, 우리 가족이 준비할 것
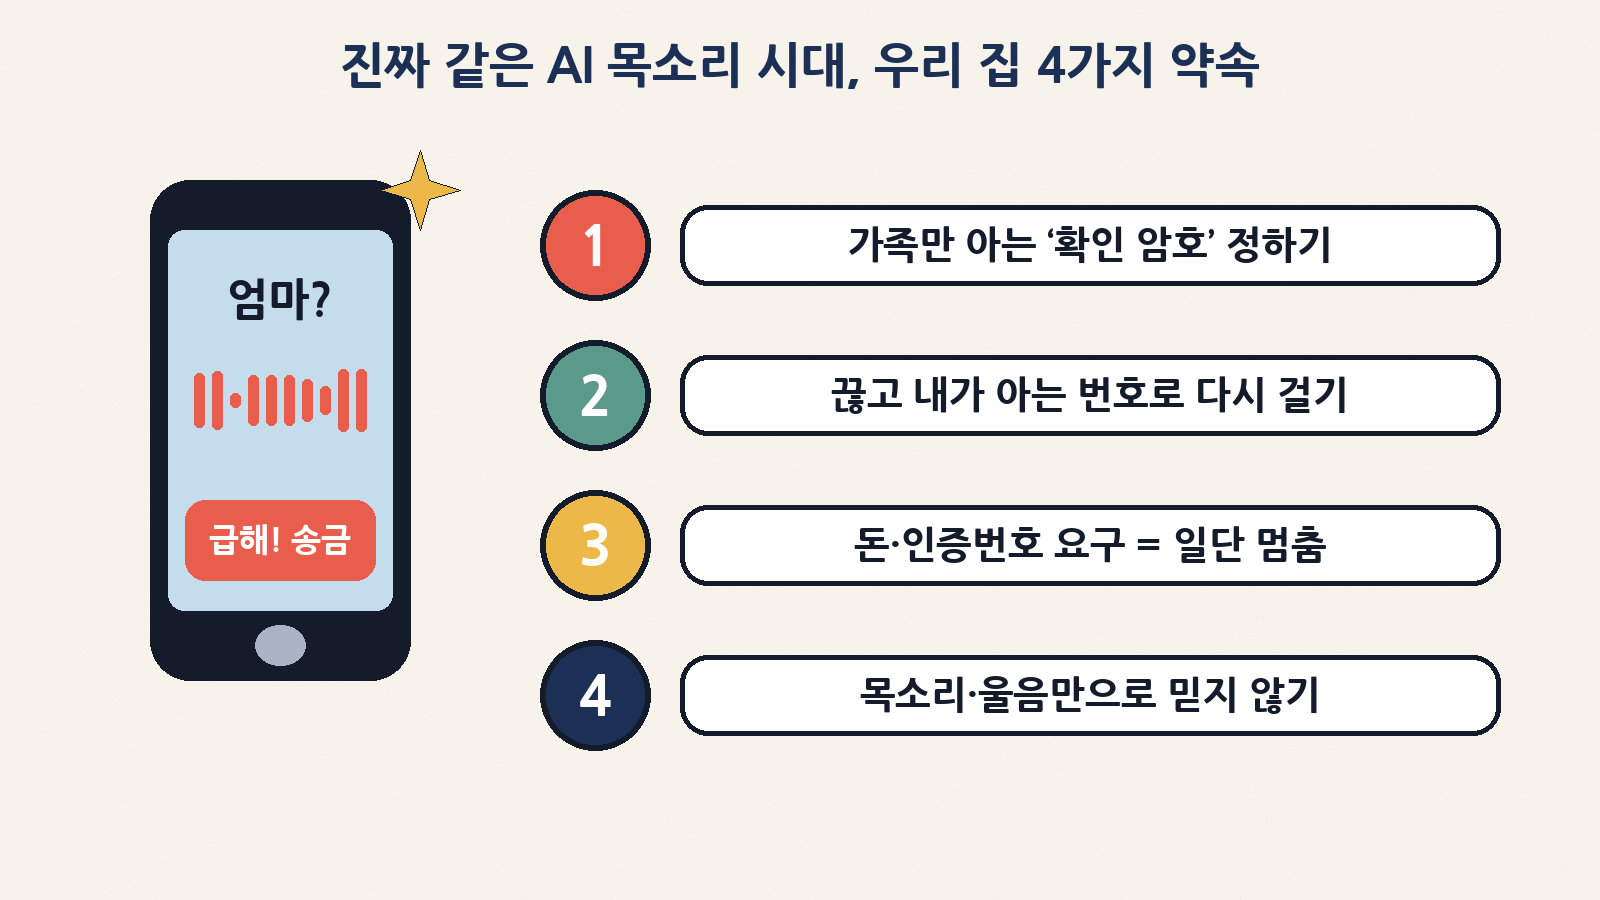
데사 자체는 아직 공개되지 않았지만, 목소리를 흉내 내는 AI 기술은 이미 여기저기 퍼져 있어요. 짧은 영상 속 목소리 몇 초만으로 비슷한 목소리를 만드는 도구도 있죠. 데사 같은 기술이 보여 주는 건, 앞으로는 목소리가 진짜 같을 뿐 아니라 대화까지 자연스러워진다는 점이에요. 예전 보이스피싱은 말이 어색하거나 질문에 엉뚱하게 답해 눈치챌 수 있었는데, 앞으로는 울먹이며 맞장구치고 내 질문에 즉석으로 반응하는 사기 전화가 나올 수 있어요.
그래서 기술을 ‘알아보는’ 것보다 목소리만으로 믿지 않는 습관을 가족이 함께 만드는 게 중요해요.
| 우리 집 약속 | 어떻게 하나요? | 예시 |
|---|---|---|
| ① 가족 확인 암호 | 가족끼리만 아는 질문·단어를 미리 정해 두기 (SNS에 안 나오는 것) | “우리 첫 강아지 이름은?” → 정답을 모르면 끊기 |
| ② 끊고 다시 걸기 | 급한 전화라도 일단 끊고, 내 연락처에 저장된 번호로 직접 다시 걸기 | “엄마 폰 고장 나서 친구 폰으로 걸어” → 엄마 원래 번호로 확인 |
| ③ 돈·인증번호 = 멈춤 신호 | 송금, 상품권, 인증번호, 앱 설치 요구가 나오면 무조건 멈추기 | “지금 바로 보내야 해”라는 재촉이 가장 위험한 신호 |
| ④ 감정에 흔들리지 않기 | 울음·비명·다급한 목소리는 사기에서 가장 많이 쓰는 장치 | “사고 났어, 살려 줘” → 심호흡하고 ②번부터 |
| ⑤ 내 목소리 노출 줄이기 | 모르는 번호에서 온 전화에 길게 말하지 않기, 공개 영상의 목소리 노출 생각해 보기 | “여보세요? 누구세요?”만 말하고 상대가 먼저 밝히게 |
| 이미 당했거나 의심된다면 | 할 일 |
|---|---|
| 돈을 보냈다면 | 바로 112 또는 보낸 은행 고객센터에 전화해 지급정지 요청 (시간이 가장 중요) |
| 금융 관련 상담 | 금융감독원 1332 |
| 인증번호·개인정보를 알려 줬다면 | 해당 금융사·통신사에 알리고 비밀번호 변경, 원격조종 앱을 깔았다면 삭제 후 기기 점검 |
| 가족에게 알리기 | 같은 수법으로 다른 가족에게도 연락이 갈 수 있으니 바로 공유 |
“요즘은 AI가 제 목소리로 울면서 전화할 수도 있대요. 제가 돈 얘기하면서 급하다고 하면 일단 끊고 제 번호로 다시 걸어 주세요. 그리고 우리끼리 암호 하나 정해요.” 이 두 문장만으로도 큰 피해를 막을 수 있어요.
앞으로 무엇이 달라질까? 기대와 숙제
| 분야 | 기대되는 변화 | 따져 볼 숙제 |
|---|---|---|
| 고객센터 | 기계음 대신 사람처럼 공감하며 응대 | 상대가 AI인지 사람인지 알려 줄 의무 |
| 교육 | 아이와 자연스럽게 대화하는 외국어·독서 선생님 | 아이가 AI에 정서적으로 지나치게 기대는 문제 |
| 돌봄·건강 | 목소리 속 피로·불안을 알아채는 말벗 | 민감한 감정 정보를 누가 저장·활용하나 |
| 접근성 | 글을 읽기 어려운 사람도 말로 편하게 이용 | 사투리·발음 차이에 따른 차별 없이 동작하나 |
| 안전 | 음성 AI가 위급 상황을 더 잘 알아챔 | 사칭·사기 악용, 출처 표시(워터마크) 같은 장치 |
특히 한국어 사용자에게 중요한 질문은 “한국어도 이렇게 될까?”예요. 데사는 사람 대화 녹음으로 배우기 때문에, 한국어를 잘하려면 대량의 한국어 대화 녹음이 필요해요. 블록도 “새 언어를 얼마나 효율적으로 배우는지”를 앞으로의 연구 질문으로 꼽았어요. 아직 답은 없지만, 글 대신 소리로 배우는 방식이 통한다면 글 자료가 적은 언어나 사투리에서 새로운 가능성이 열릴 수도 있어요.
자주 묻는 질문
| 질문 | 답 |
|---|---|
| 데사를 지금 한국에서 써 볼 수 있나요? | 아니요. 일반 공개 전이고 한국어 지원도 밝혀지지 않았어요. 공식 페이지에서 영어 녹음만 들어 볼 수 있어요 |
| 시리·빅스비·챗GPT 음성과 뭐가 달라요? | 기존 다수 음성 비서는 목소리를 글자로 바꿔 처리해요. 데사는 소리를 소리 그대로 처리하고, 글 없이 소리만으로 배웠다는 점이 달라요 |
| 글을 안 배웠으면 똑똑하지 않은 거 아니에요? | 지식은 글로 배운 거대 AI보다 적을 수 있어요. 대신 말투·감정·타이밍 같은 ‘대화 감각’이 강점이에요 |
| 블록은 결제 회사인데 왜 AI를 만들어요? | 블록 산하 연구실이 잭 도시에게 직접 보고하며 장기 연구를 하고 있어요. 상용 제품 계획은 아직 밝히지 않았어요 |
| AI 목소리인지 구별하는 방법이 있나요? | 귀로만 구별하기는 점점 어려워져요. 그래서 기술보다 ‘끊고 다시 걸기’, ‘가족 암호’ 같은 습관이 더 확실해요 |
마무리: 목소리는 더 사람다워지고, 확인은 더 꼼꼼해져야
데사를 한 줄로 줄이면 “아기처럼 듣기만 해서 말을 배운 AI가, 사람처럼 웃고 끼어들며 대화하기 시작했다”예요. 언젠가 외로운 어르신의 말벗이나 아이의 영어 선생님이 될 수도 있는 반가운 기술이에요. 동시에 ‘목소리 = 그 사람’이라는 오래된 믿음이 흔들리는 순간이기도 해요. 오늘 저녁 가족 단톡방에 “우리 가족 확인 암호 하나 정하자”고 한 줄 남겨 보는 건 어떨까요? 🎙️