오늘(2026-11-11) GitHub Trending Python 일간 목록에 OpenBMB/VoxCPM이 다시 올라왔습니다. 수집 시점 기준 하루 140★, 누적 42,234★·포크 4,818, 라이선스 Apache-2.0(코드와 가중치 모두), PyPI 최신 버전은 voxcpm 2.0.3(2026-05-11 배포)이고 기본 브랜치 HEAD는 300e426(2026-11-09 16:36 KST, 문서 링크 수정)입니다. 최근 커밋은 코드보다 문서·생태계 목록(11월 5일 VoxaDub 이름 변경 등) 쪽이라, 이번 재부상은 새 기능 출시보다는 vLLM-Omni·llama.cpp-omni·더빙 도구 같은 주변 생태계를 통한 노출이 이끈 것으로 보입니다.
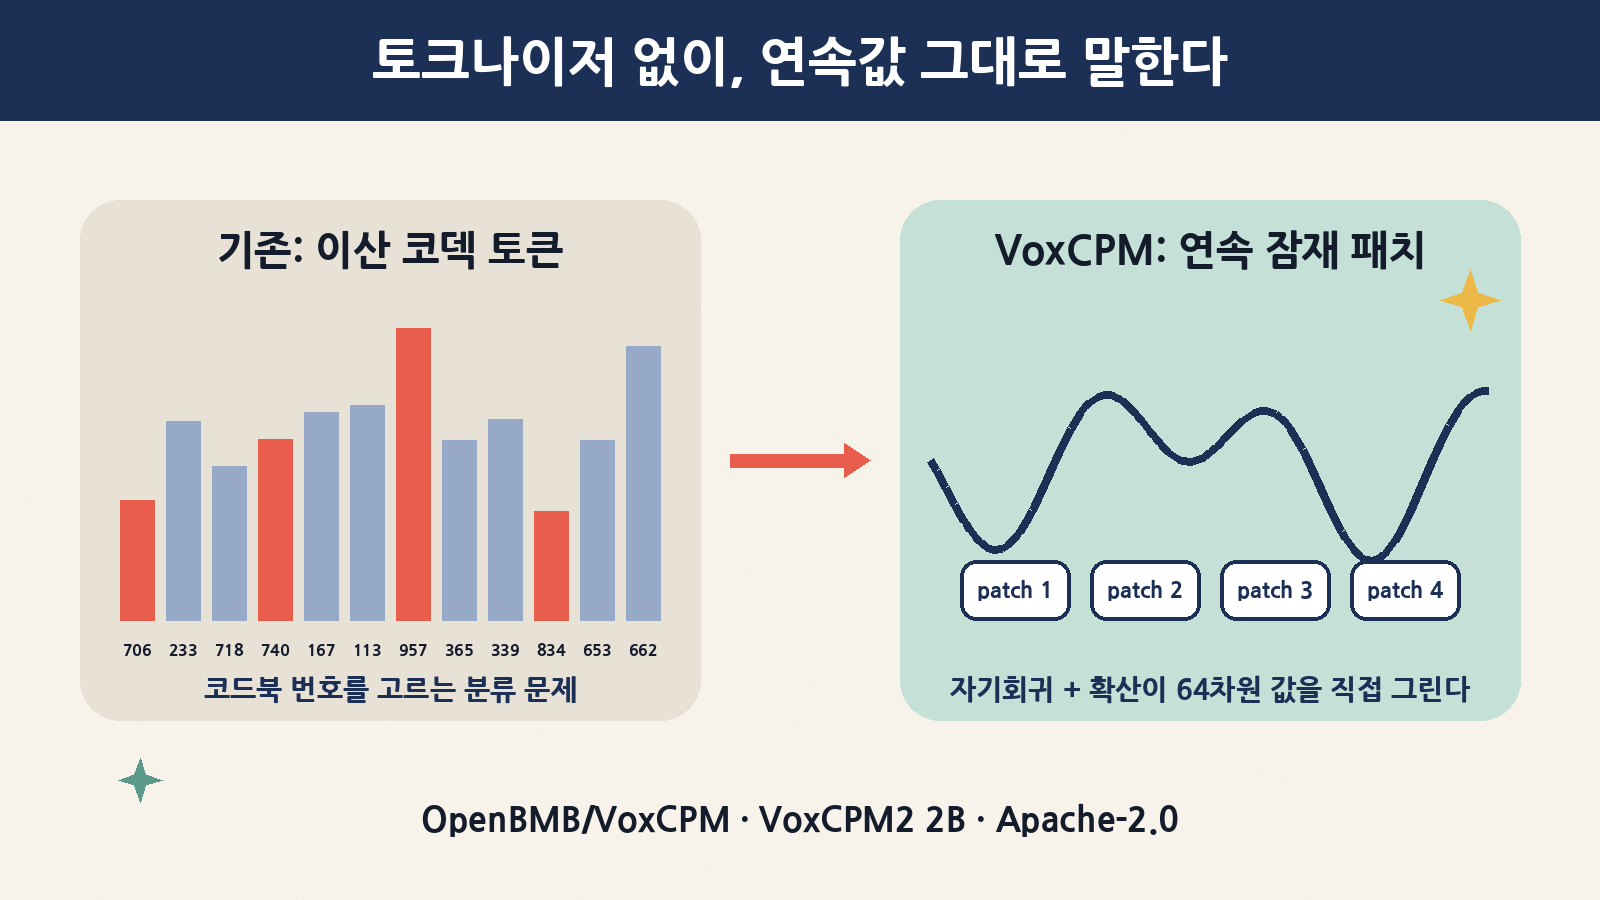
VoxCPM2는 2B 파라미터급 TTS 모델입니다. 다만 흔한 “LLM + 오디오 코덱 토큰” 구조가 아닙니다. 음성을 이산 토큰으로 바꾸지 않고, 연속 잠재값(latent) 패치를 자기회귀로 한 칸씩 이어 가면서 각 칸 안은 작은 확산 모델(flow matching)로 그리는 “tokenizer-free diffusion autoregressive” 구조입니다. 이 글은 입문 소개가 아니라 실무자 기준 해부입니다. 4단 파이프라인이 코드에서 실제로 어떻게 맞물리는지, 레이트(Hz) 계산이 왜 중요한지, 참조 음성 격리 클로닝이 시퀀스에 어떻게 들어가는지, 서빙 경로별 장단점은 무엇인지 정리합니다. 마지막에는 GPU 없는 8코어 박스에서 직접 돌린 결과와 거기서 발견한 함정 두 가지를 그대로 적습니다.
1. 프로젝트 카드
| 항목 | 내용 (2026-11-11 KST 확인) |
|---|---|
| 저장소 | github.com/OpenBMB/VoxCPM (2025-09-16 생성, 기본 브랜치 main, 확인한 HEAD 300e426) |
| 만든 곳 | OpenBMB / ModelBest, 칭화대 THUHCSI |
| 라이선스 | Apache-2.0. README는 코드와 가중치 모두 상업적 이용이 가능하다고 명시 |
| 버전 | GitHub 릴리스·PyPI 모두 2.0.3(2026-05-11, “fine-tuning validation, runtime stability, and streaming improvements”). 2.0.0(2026-04-06)이 VoxCPM2 첫 공개 |
| 인기 지표 | 42,234★ · 포크 4,818 · 오늘 +140★(Trending Python 일간) · Hugging Face openbmb/VoxCPM2 좋아요 1,776, API상 최근 다운로드 988,904 |
| 모델 크기 | model.safetensors 4,580,080,592바이트(bf16) + audiovae.pth 376,951,122바이트 |
| 지원 언어 | 30개 언어(한국어 포함) + 중국어 방언 9종. 언어 태그 없이 입력 |
| 출력 | 48kHz 모노. 참조 음성은 16kHz로 받아 인코딩 |
| 요구 사항 | README 기준 Python 3.10 이상 3.13 미만, PyTorch 2.5 이상, CUDA 12.0 이상(CPU·MPS도 동작) |
| 기술 보고서 | VoxCPM2 Technical Report(arXiv 2606.06928), VoxCPM(arXiv 2509.24650, ICLR 2026) |
2. 세 세대 비교: 왜 2B로 키웠나
README의 버전 표를 그대로 옮기면 아래와 같습니다. 눈여겨볼 점은 LM 토큰 레이트가 1.5부터 6.25Hz로 내려갔다는 것과, VoxCPM2에서 클로닝 모드가 “이어 말하기(continuation)” 하나에서 “격리 참조 + 이어 말하기” 두 갈래로 늘었다는 점입니다. 대신 RTX 4090 기준 RTF는 0.15에서 0.30으로 느려졌고 VRAM은 약 8GB로 늘었습니다. 표현력과 다국어를 얻고 속도를 내준 교환입니다.
| 항목 | VoxCPM2 | VoxCPM1.5 | VoxCPM-0.5B |
|---|---|---|---|
| 상태 | 최신 | 안정 | 레거시 |
| 백본 파라미터 | 2B | 0.6B | 0.5B |
| 출력 샘플레이트 | 48kHz | 44.1kHz | 16kHz |
| LM 토큰 레이트 | 6.25Hz | 6.25Hz | 12.5Hz |
| 언어 | 30 | 2(zh, en) | 2(zh, en) |
| 클로닝 모드 | 격리 참조 & 이어 말하기 | 이어 말하기만 | 이어 말하기만 |
| Voice Design / 제어형 클로닝 | 지원 | — | — |
| SFT / LoRA | 지원 | 지원 | 지원 |
| RTF(RTX 4090, PyTorch) | ~0.30 | ~0.15 | ~0.17 |
| RTF(Nano-vLLM, RTX 4090) | ~0.13 | ~0.08 | ~0.10 |
| VRAM | ~8GB | ~6GB | ~5GB |
3. 아키텍처: LocEnc → TSLM → RALM → LocDiT
공식 다이어그램부터 보겠습니다. 아래쪽이 입력(참조 음성·텍스트·프롬프트 음성), 가운데가 두 개의 언어 모델, 위쪽이 패치 단위 확산 생성기입니다. 오른쪽 아래 AudioVAE V2는 생성 루프 바깥에서 파형과 잠재값을 오가는 코덱입니다.
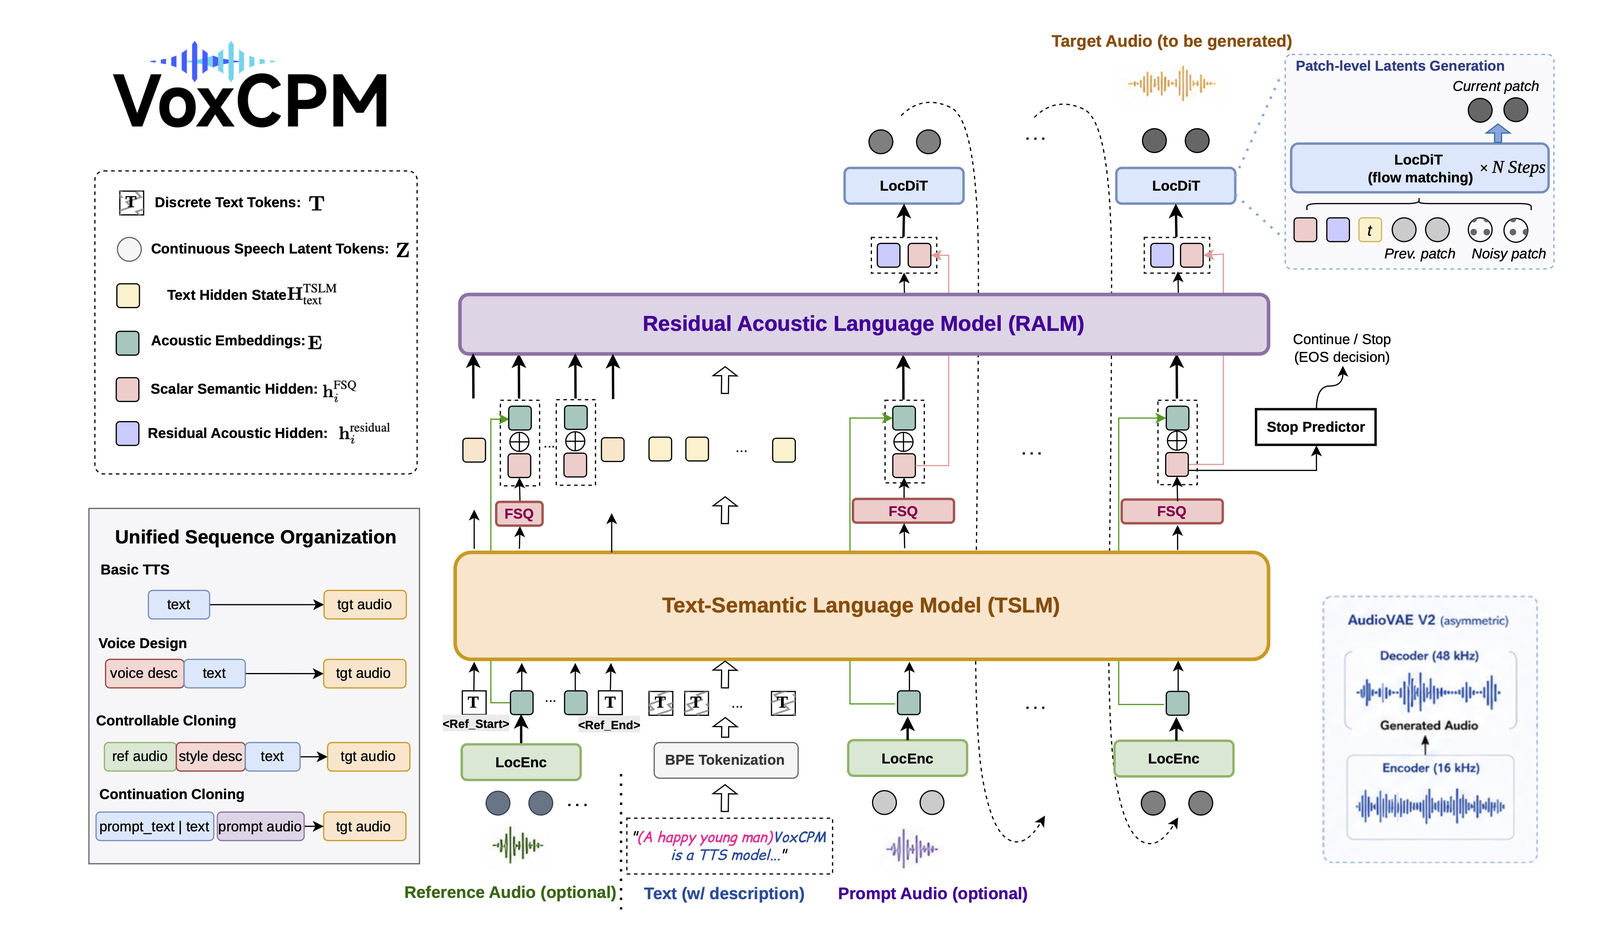
코드(src/voxcpm/model/voxcpm2.py, 1,279줄)를 따라가면 역할이 더 분명해집니다. 각 모듈의 크기는 Hugging Face의 model.safetensors 헤더만 HTTP Range 요청으로 받아(본문 4.6GB는 받지 않고) 텐서 모양을 합산해서 박스에서 직접 셌습니다. 총 2,290,004,544개, 577개 텐서 전부 BF16입니다.
| 모듈 | 설정(config.json) | 파라미터(박스 집계) | 하는 일 |
|---|---|---|---|
base_lm = TSLM |
MiniCPM-4, 28층, hidden 2048, FFN 6144, 헤드 16 / KV 헤드 2(GQA), vocab 73,448, LongRoPE | 1,471.7M (64.3%) | 텍스트 토큰과 음성 임베딩을 한 시퀀스로 받아 “무엇을 어떤 운율로 말할지” 계획. 출력은 FSQ로 양자화 |
residual_lm = RALM |
같은 MiniCPM 설정에서 8층, vocab 0, RoPE 없음 | 377.5M (16.5%) | TSLM 출력과 직전 음향 임베딩을 concat→projection으로 섞어 세부 음향 정보를 보강 |
feat_decoder = LocDiT(CFM) |
12층, hidden 1024, FFN 4096, Euler solver, log-norm t 스케줄 | 212.0M (9.3%) | 패치 하나(잠재 프레임 4개 × 64차원)를 노이즈에서 flow matching으로 생성 |
feat_encoder = LocEnc |
12층, hidden 1024, 양방향 어텐션 | 207.7M (9.1%) | 잠재 패치 4프레임 + 특수 토큰을 넣고 특수 토큰 출력 하나를 패치 벡터로 사용(CLS 방식) |
| 투영·FSQ·정지 예측 | FSQ latent 512, scale 9 / stop_proj + stop_head(2클래스) | 약 21M (1% 미만) | 차원 맞춤, 반연속 병목, 매 스텝 “계속/멈춤” 분류 |
| AudioVAE V2(별도 파일) | 인코더 16kHz, rates 2·5·8·8 / 디코더 rates 8·6·5·2·2·2, 48kHz | safetensors에 미포함(.pth 377MB) | 파형 ↔ 64차원 잠재값. 생성 루프 바깥 |
몇 가지 설계 포인트를 코드 기준으로 짚어 둡니다.
- FSQ는 “반연속” 병목입니다.
ScalarQuantizationLayer는 2048→512로 줄이고tanh뒤round(x·9)/9로 각 차원을 19단계 격자에 맞춘 다음 다시 2048로 올립니다. 학습 때는 straight-through 추정으로 기울기를 흘립니다. 즉 음향 세부를 직접 담는 경로(RALM·LocDiT)는 연속값이지만, 의미 계획 경로는 일부러 거칠게 만들어 “무엇을 말할지”와 “어떤 소리로 낼지”를 분리합니다. - LocDiT 입력은 짧은 시퀀스 하나입니다.
local_dit_v2.py를 보면 [TSLM 투영 1토큰, RALM 투영 1토큰, 시간 임베딩 1토큰, 직전 패치 4프레임, 현재 노이즈 4프레임]을 이어 붙여 11토큰짜리 양방향 트랜스포머를 돌립니다. 문서가 말하는 “multi-token conditioning prefix”(1.x의 단일 융합 토큰 대비 개선)가 이것입니다. - CFG는 배치를 두 배로 늘려 계산합니다. 조건부/무조건부를 한 배치(2B)로 묶고, CFG-Zero* 방식으로 최적 스케일을 구한 뒤 첫 스텝(전체 스텝의 4%, 최소 1스텝)은 속도를 0으로 둡니다. 시간축은 sway sampling(계수 1.0)으로 휘어 씁니다.
inference_timesteps=10이면 패치 하나에 DiT 순전파가 사실상 9번, 각각 배치 2입니다. - Chinese 다문자 토큰을 글자 단위로 쪼갭니다.
mask_multichar_chinese_tokens가 토크나이저를 감싸 두 글자 이상 한자 토큰을 한 글자씩 나눕니다. 글자와 발음의 정렬을 쉽게 하려는 장치입니다.
4. 레이트 계산: 한 스텝이 오디오 몇 ms인가
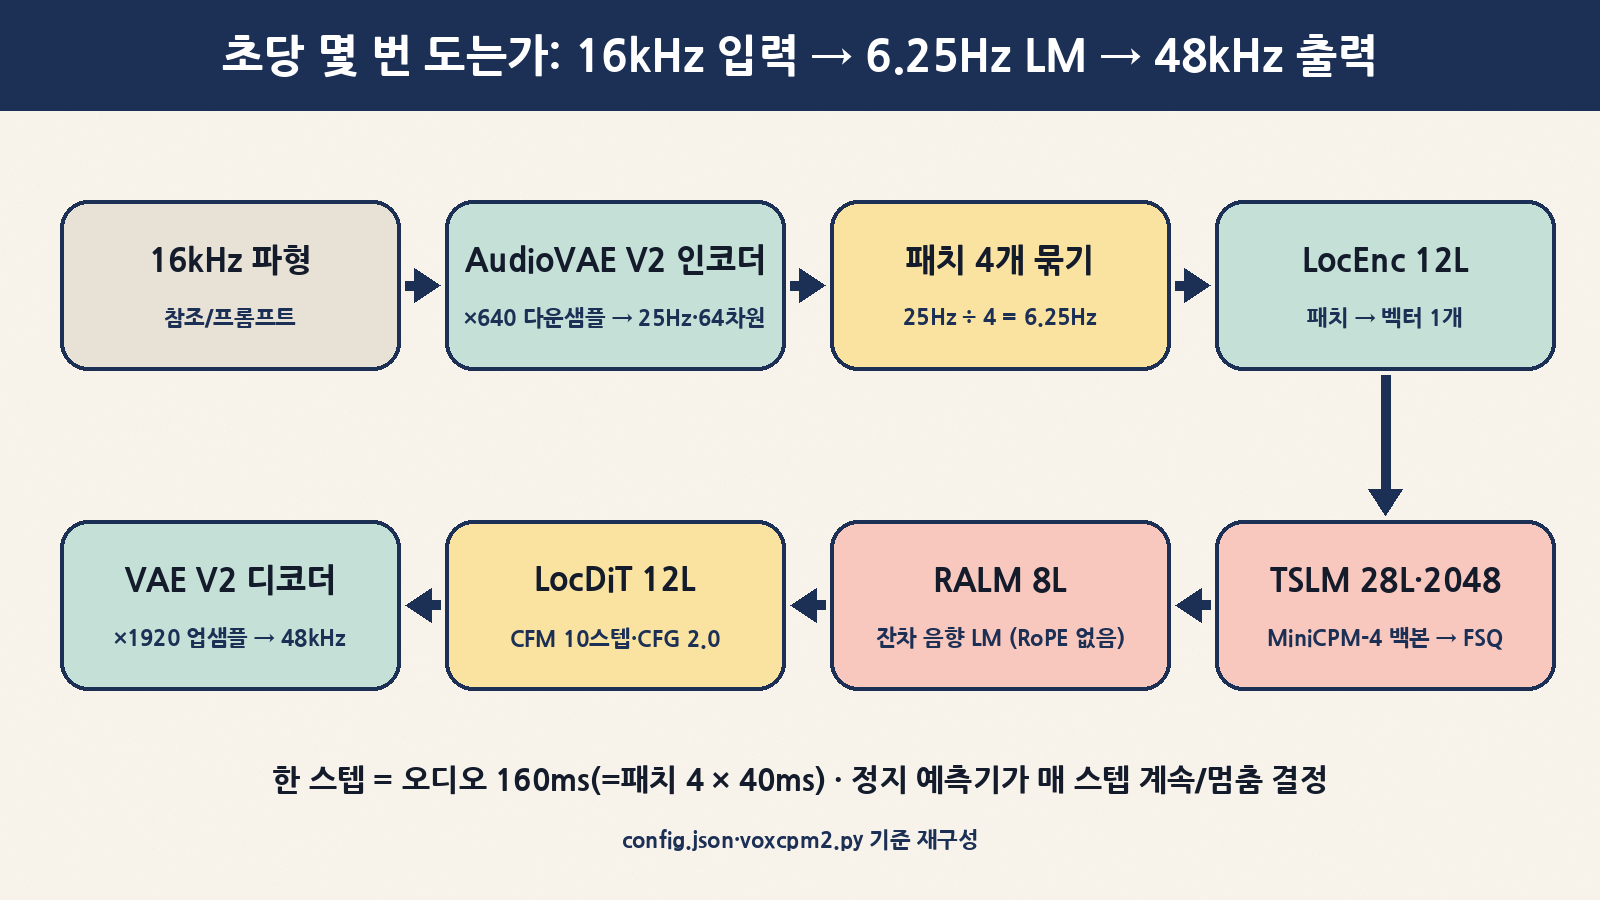
연속 잠재 TTS를 운영할 때 가장 먼저 머리에 넣어야 할 숫자는 “LM 한 스텝 = 오디오 몇 초”입니다. 지연, 컨텍스트 길이, 스트리밍 조각 크기가 전부 여기서 나옵니다. config.json 값만으로 계산하면 이렇습니다.
| 단계 | 계산 | 결과 |
|---|---|---|
| VAE 인코더 hop | 2 × 5 × 8 × 8 = 640샘플 @16kHz | 25Hz, 프레임당 40ms, 64차원 |
| 패치 묶기 | patch_size 4 | LM 1스텝 = 4프레임 = 160ms → 6.25Hz |
| VAE 디코더 hop | 8 × 6 × 5 × 2 × 2 × 2 = 1,920샘플 @48kHz | 역시 25Hz. 패치 1개 = 7,680샘플 |
| 컨텍스트 한도 | max_length 8,192(KV 캐시 사전할당) | 텍스트 토큰 + 참조/프롬프트 패치 + 생성 패치 합계. 음성만이라면 이론상 약 21.8분 분량 |
| 생성 길이 상한 | min(대상 텍스트 토큰 수 × 6 + 10, max_len 2,000) | 텍스트가 짧으면 상한도 짧음 → 무한 생성 방지 |
박스 실측에서 스트리밍 조각 하나의 길이가 정확히 7,680샘플(48kHz에서 160ms)로 나왔습니다. 위 계산이 코드 동작과 일치한다는 뜻입니다. 1.5와 2가 6.25Hz를 쓰는 이유도 여기서 보입니다. 같은 1분짜리 음성이 12.5Hz면 750스텝, 6.25Hz면 375스텝이라 2B 백본을 써도 자기회귀 횟수가 절반입니다. 대신 한 스텝이 160ms를 책임지므로 LocDiT가 패치 안에서 더 많은 일을 해야 합니다.
5. 생성 모드 네 가지와 시퀀스 배치
VoxCPM2의 기능 이름(Voice Design, 제어형 클로닝, Ultimate Cloning)은 결국 “TSLM에 들어가는 한 줄짜리 시퀀스를 어떻게 짜느냐”의 차이입니다. _generate()의 네 갈래를 정리하면 다음과 같습니다. 특수 토큰은 audio_start=101, ref_audio_start=103, ref_audio_end=104입니다.
| 모드 | 호출 | 시퀀스 구성 | 비고 |
|---|---|---|---|
| 기본 TTS / Voice Design | text만 |
[텍스트 … 101] → 생성 | Voice Design은 별도 API가 아니라 텍스트 앞 괄호 설명. CLI --control은 "({control}){text}"로 붙임 |
| 참조 클로닝(격리) | reference_wav_path |
[103, 참조 패치들, 104, 텍스트 … 101] → 생성 | v2 신규. 참조 음성은 음색만 주고 이어 말하기 문맥이 되지 않음. 괄호 스타일 지시와 함께 쓸 수 있음 |
| 이어 말하기(continuation) | prompt_wav_path + prompt_text |
[프롬프트 텍스트+대상 텍스트 … 101, 프롬프트 패치들] → 이어서 생성 | 1.x와 같은 방식. 리듬·감정까지 따라가지만 프롬프트 전사가 정확해야 함 |
| 결합(Ultimate) | 세 인자 모두 | [103, 참조, 104, 텍스트 … 101, 프롬프트 패치] → 생성 | README 권장: 같은 클립을 reference와 prompt 양쪽에. CLI는 --control과 --prompt-text 동시 사용을 막음 |
여기서 실무적으로 중요한 차이는 “격리”입니다. 이어 말하기 방식은 참조 음성이 곧 직전 발화가 되므로 녹음 톤·잡음·말 끝 처리까지 그대로 이어집니다. 격리 참조는 103/104로 감싼 별도 구간이라 음색만 가져오고 새 문장은 처음부터 시작합니다. 그래서 v2에서는 “이 목소리로, 더 밝게” 같은 스타일 지시와 음색 복제를 동시에 걸 수 있습니다. 반대로 원본의 미세한 버릇까지 복제하려면 여전히 결합 모드가 필요합니다.
6. 손이 가는 생성 파라미터
| 파라미터 | 기본값 | 효과와 주의점 |
|---|---|---|
cfg_value |
2.0 | CFG 강도. 높이면 텍스트·지시를 더 따르지만 과하면 부자연스러워짐 |
inference_timesteps |
10 | 패치당 Euler 스텝 수. 지연에 거의 선형으로 비례(아래 박스 실측 참고) |
retry_badcase |
False(VoxCPM2Model 기본) |
생성 패치 수가 텍스트 토큰 × 6.0 이상이면 “망가진 생성”으로 보고 seed+1로 최대 3회 재시도. 스트리밍에서는 강제로 꺼짐 |
streaming_prefix_len |
4 | 이어 말하기 모드에서 VAE 디코딩을 매끄럽게 하려고 프롬프트 끝 패치 3개를 문맥으로 붙임 |
seed |
None | 재현성. main 브랜치에만 있고 PyPI 2.0.3에는 없음(7절) |
normalize / denoise |
False / 파이프라인 의존 | 텍스트 정규화(wetext), 참조 음성 잡음 제거(ZipEnhancer, ModelScope). from_pretrained()는 기본 load_denoiser=True라 추가 모델을 내려받음 |
optimize |
True | CUDA + triton일 때만 torch.compile(mode="reduce-overhead"). CPU·MPS에서는 경고 후 건너뜀 |
장치별 dtype 처리도 알아 둘 만합니다. pick_runtime_dtype()는 Apple MPS에서 bf16/fp16이 확산 자기회귀 루프에 수치 오차를 쌓아 bad-case 재시도가 끝없이 반복되는 문제 때문에 MPS만 float32로 강제합니다(VOXCPM_MPS_DTYPE로 덮어쓰기 가능). CUDA와 CPU는 체크포인트 dtype(bf16)을 그대로 씁니다.
7. 박스 실측: GPU 없는 8코어 CPU에서 돌려 보기
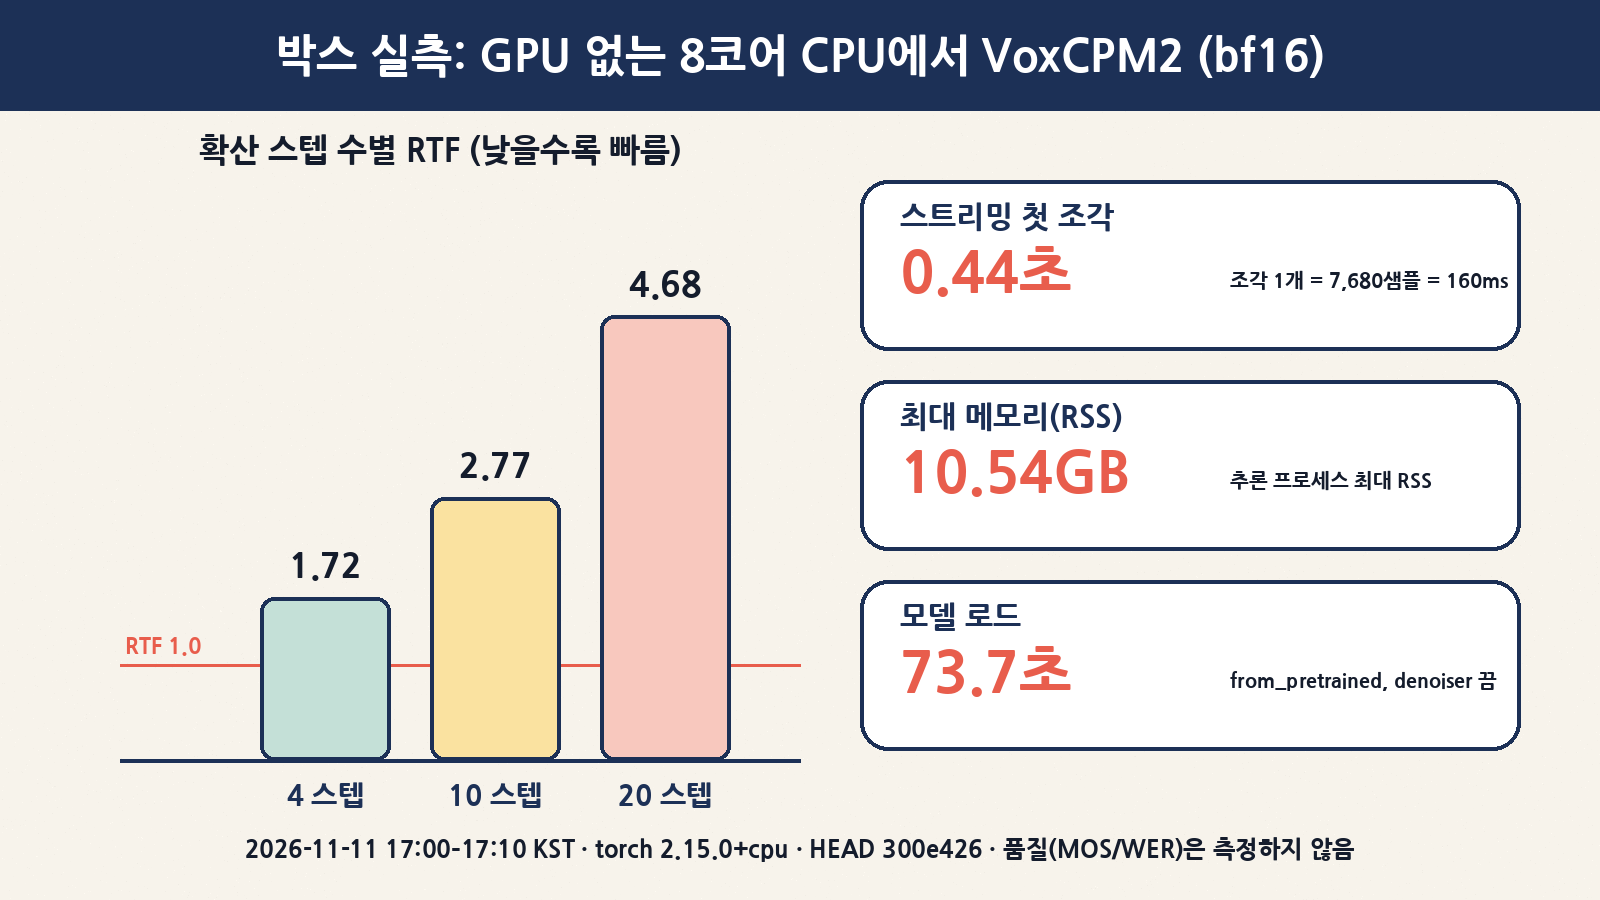
2026-11-11 16:50~17:10 KST, 8코어·RAM 15GB·GPU 없는 리눅스 박스에서 Python 3.12 가상환경, torch 2.15.0+cpu로 돌렸습니다. 가중치는 Hugging Face에서 받았고(약 26초), denoiser는 끄고(load_denoiser=False) torch.set_num_threads(8)로 고정했습니다.
uv venv -p 3.12 .venv && . .venv/bin/activate
uv pip install torch torchaudio --index-url https://download.pytorch.org/whl/cpu
uv pip install ./VoxCPM            # HEAD 300e426 (seed 인자 때문에 main 설치)
python - <<'EOF'
from huggingface_hub import snapshot_download
snapshot_download("openbmb/VoxCPM2", local_dir="./models/VoxCPM2")
EOF
python infer.py   # from_pretrained(load_denoiser=False) → generate / generate_streaming
첫 번째 함정: README 예제가 PyPI 버전에서 안 돕니다. 처음에는 README대로 pip install voxcpm(2.0.3)을 설치했는데, README 예제에 있는 seed=42를 넣자 TypeError: VoxCPM._generate() got an unexpected keyword argument 'seed'로 바로 실패했습니다. 설치된 2.0.3의 core.py에는 seed가 아예 없고, main 브랜치에는 있습니다. README가 마지막 PyPI 릴리스(5월)보다 앞서 있는 상태입니다. 재현성이 필요하면 커밋을 고정해 소스에서 설치하거나, seed 없이 쓰면서 torch.manual_seed를 직접 거는 수밖에 없습니다.
| 측정 항목 | 결과 | 메모 |
|---|---|---|
모델 로드(from_pretrained) |
73.7초 | bf16, CPU. 첫 로드 기준 |
| 한국어 문장 1(워밍업 포함) | 생성 15.5초 / 음성 5.60초 → RTF 2.77 | “테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다.” |
| Voice Design 문장 | 생성 7.1초 / 음성 4.16초 → RTF 1.72 | “(차분하고 낮은 목소리의 중년 남성 아나운서)…” 괄호 지시 |
| 스트리밍 | 첫 조각 0.44초, 조각 19개(각 7,680샘플), 총 5.7초 / 음성 3.04초 → RTF 1.87 | 루프 진행률은 초당 약 3.3~3.5패치 |
| 확산 스텝 4 / 10 / 20(같은 문장, seed 42) | RTF 1.72 / 2.77 / 4.68 | 스텝을 줄이면 거의 선형으로 빨라짐. 음질 차이는 평가하지 않음 |
| 프로세스 최대 RSS | 10.54GB | 15GB 박스에서 다른 작업과 같이 돌리기는 빠듯 |
| 출력 파일 | 48,000Hz · 모노 · PCM_16 | model.tts_model.sample_rate = 48000 |
| 저장소 테스트(pytest) | 전체 한 번에: 57 통과 / 5 실패 · 분리 실행: 56 + 6 = 62개 전부 통과 | test_lora_checkpoint_loading.py가 sys.modules["transformers"]에 가짜 모듈을 넣고, 이게 뒤이은 test_training_data.py로 새어 나가 PreTrainedTokenizerBase AttributeError. transformers 4.57.6·5.22.2 두 버전 모두 같은 양상 → 버전 문제가 아니라 테스트 격리 문제 |
해석은 조심스럽게 해야 합니다. CPU에서도 “돌기는” 하지만 RTF가 1을 넘으므로 실시간 서비스용은 아닙니다. 그래도 스트리밍 첫 조각이 0.44초에 나온다는 점은 의미가 있습니다. 6.25Hz 패치 구조 덕분에 프리필 후 패치 하나만 만들면 바로 160ms 분량을 내보낼 수 있기 때문입니다. 정밀한 품질 평가(WER·화자 유사도·MOS)는 이번 측정 범위 밖이고, 위 수치는 이 박스 한 대, 짧은 문장 몇 개 기준입니다.
8. 서빙 경로: PyTorch 그대로 쓰면 안 되는 이유
기본 구현은 base_lm.setup_cache(1, max_length, …)처럼 배치 1 KV 캐시를 미리 잡아 두는 구조입니다. 한 프로세스가 한 요청씩 처리하는 연구용·데스크톱용 형태라, 동시 요청을 받으려면 별도 엔진을 쓰는 게 맞습니다. README가 안내하는 경로를 비교하면 다음과 같습니다(수치는 모두 README 기재값).
| 경로 | 성격 | README 기재 성능 | 언제 쓰나 |
|---|---|---|---|
PyTorch(voxcpm 패키지) |
레퍼런스 구현, 배치 1, CUDA에서 torch.compile | RTF ~0.30(RTX 4090) | 평가, 파인튜닝 검증, 단일 사용자 도구 |
| Nano-vLLM-VoxCPM | Nano-vLLM 기반 전용 엔진, 동시 요청·async API, FastAPI 서버 | RTF ~0.13(RTX 4090) | GPU 한두 장으로 처리량을 올릴 때 |
| vLLM-Omni | vLLM 공식 옴니모달 확장. PagedAttention, continuous batching, OpenAI 호환 /v1/audio/speech |
수치 미기재 | 멀티테넌트 운영, 기존 vLLM 인프라 재사용 |
| llama.cpp-omni | C++ / GGUF(BaseLM F16·Q8_0 + Acoustic 파일), CPU·Metal·CUDA·Vulkan | RTF ~1.76(Q8_0, Apple M4 Pro Metal) | 파이썬 없는 온디바이스·엣지 |
| 기타 커뮤니티 | VoxCPM.cpp, VoxCPM-ONNX, VoxCPMANE(Apple Neural Engine), voxcpm_rs, ComfyUI 노드, audio.cpp 등 | — | 특정 런타임 통합. OpenBMB가 직접 유지하지 않음 |
# vLLM-Omni (README 예시)
vllm serve openbmb/VoxCPM2 --omni --port 8000
curl http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model":"openbmb/VoxCPM2","input":"Hello from VoxCPM2 on vLLM-Omni!","voice":"default"}' \
  --output out.wav
9. 벤치마크 읽기와 비슷한 도구 비교
README의 Seed-TTS-eval 표에서 공개 모델 일부만 뽑았습니다(WER/CER은 낮을수록, SIM은 높을수록 좋음). 모두 프로젝트가 직접 정리한 표라 독립 검증 수치는 아닙니다.
| 모델 | 파라미터 | test-EN WER / SIM | test-ZH CER / SIM | test-Hard CER / SIM |
|---|---|---|---|---|
| VoxCPM2 | 2B | 1.84 / 75.3 | 0.97 / 79.5 | 8.13 / 75.3 |
| VoxCPM1.5 | 0.8B | 2.12 / 71.4 | 1.18 / 77.0 | 7.74 / 73.1 |
| Qwen3-TTS | 1.7B | 1.23 / 71.7 | 1.22 / 77.0 | 6.76 / 74.8 |
| FishAudio S2 | 4B | 0.99 / – | 0.54 / – | 5.99 / – |
| LongCat-Audio-DiT | 3.5B | 1.50 / 78.6 | 1.09 / 81.8 | 6.04 / 79.7 |
| IndexTTS2 | 1.5B | 2.23 / 70.6 | 1.03 / 76.5 | 7.12 / 75.5 |
| F5-TTS | 0.3B | 2.00 / 67.0 | 1.53 / 76.0 | 8.67 / 71.3 |
| CosyVoice2 | 0.5B | 3.09 / 65.9 | 1.38 / 75.7 | 6.83 / 72.4 |
읽는 법은 이렇습니다. VoxCPM2는 화자 유사도(SIM)가 강하고, 받아쓰기 오류율(WER/CER)은 최상위권이 아닙니다. 특히 어려운 문장 세트(test-Hard)에서는 1.5(7.74)보다 오히려 숫자가 나쁩니다(8.13). 한국어만 보면 MiniMax 다국어 테스트에서 WER 1.962로 FishAudio S2(1.180)·MiniMax(1.747)보다 높고 SIM은 83.3으로 가장 높습니다. 내부 30개 언어 ASR 벤치에서는 한국어 CER 0.95%(Fish S2-Pro 0.29%)입니다. 이 내부 벤치는 Gemini 3.1 Flash Lite로 받아쓴 결과라 외부 벤치와 직접 비교하기 어렵습니다. 반대로 크메르어·라오어·버마어처럼 다른 모델이 무너지는 언어(Fish S2-Pro CER 75~87%)에서 VoxCPM2는 1~2%대를 유지합니다. 정리하면 “목소리를 닮게 만드는 능력과 언어 폭”이 강점이고, “가장 정확하게 읽는 모델”은 아닙니다.
| 구분 | VoxCPM2 | F5-TTS | CosyVoice 2/3 | Qwen3-TTS |
|---|---|---|---|---|
| 생성 단위 | 연속 잠재 패치(6.25Hz) 자기회귀 + 패치 내 flow matching | 비자기회귀 flow matching(DiT)로 전체 길이를 한 번에 | LLM이 음성 토큰을 생성한 뒤 flow matching으로 음향 복원 | 12Hz 음성 토크나이저 계열(README의 모델명 기준) |
| 스트리밍 | 패치 단위로 자연스럽게 지원(160ms 조각) | 구조상 전체 길이를 정한 뒤 생성 | 토큰 단위 스트리밍 지원 | 이 글에서 미검증 |
| 참조 클로닝 | 격리 참조 + 이어 말하기 둘 다 | 참조 음성 + 전사(없으면 ASR로 생성) | 지원 | 이 글에서 미검증 |
| 텍스트 지시형 Voice Design | 괄호 지시로 지원(InstructTTSEval-EN APS 84.2) | — | 지시 기능 일부 | VD 전용 변형(InstructTTSEval-ZH APS 85.2) |
| 출력 | 48kHz | 24kHz | 버전별 상이 | 이 글에서 미검증 |
| 선택 기준 | 다국어·음색 유사도·48kHz가 중요할 때 | 작고 단순한 비자기회귀 모델이 필요할 때 | 중국어 생태계와 성숙한 서빙 경험이 필요할 때 | 읽기 정확도(WER)가 최우선일 때 |
표 아래쪽 정성 비교(생성 단위·출력 레이트 등)는 각 프로젝트의 일반적인 설계 기준이며, 세부 사양은 버전마다 다르니 도입 전에 해당 저장소를 직접 확인하는 것이 안전합니다.
10. 파인튜닝: LoRA 설정이 말해 주는 것
README는 5~10분 분량 오디오로 화자·언어·도메인 적응이 가능하다고 설명합니다. 학습 스크립트(scripts/train_voxcpm_finetune.py, 867줄)와 conf/voxcpm_v2/voxcpm_finetune_lora.yaml을 보면 기본값은 이렇습니다.
| 설정 | 값 | 의미 |
|---|---|---|
| LoRA 대상 | LM(base_lm + residual_lm)과 DiT의 q/k/v/o_proj, 투영층은 기본 끔 |
LocEnc와 VAE는 그대로 |
| r / alpha / dropout | 32 / 32 / 0.0 | 코드 기본값(r 8, alpha 16)보다 크게 잡은 공식 예시 |
| 배치 | batch 2 × grad_accum 8 = 유효 16, max_batch_tokens 8,192 |
긴 클립은 토큰 예산으로 제한 |
| 학습률·스텝 | 1e-4, warmup 100, 1,000스텝, 500스텝마다 검증·저장 | 소량 데이터 과적합에 주의 |
| 손실 | loss/diff(flow matching) 1.0 + loss/stop(정지 예측) 1.0 |
정지 예측이 망가지면 문장 끝에서 안 멈추는 증상 |
| 데이터 형식 | JSONL 매니페스트(examples/train_data_example.jsonl), 16kHz 입력 |
sample_rate는 VAE 인코더 입력과 일치해야 함 |
python scripts/train_voxcpm_finetune.py --config_path conf/voxcpm_v2/voxcpm_finetune_lora.yaml
python lora_ft_webui.py      # 학습·추론 WebUI (기본 7860)
# 추론 시 LoRA 핫스왑: model.load_lora(path) / set_lora_enabled(False) / unload_lora()
11. 운영 체크리스트와 한계
| 항목 | 확인할 것 |
|---|---|
| 버전 고정 | PyPI 2.0.3과 README/main 사이 API 차이(seed)가 있음. 커밋 해시로 고정해 설치하고 CI에서 예제 코드를 실제로 실행 |
| 의존성 | transformers>=4.36.2로 상한이 없어 새 환경에는 5.x가 깔림(박스: 5.22.2). 추론은 문제없었지만 학습 경로는 고정 버전에서 검증 권장. Python 3.13은 README상 미지원 |
| 외부 다운로드 | from_pretrained() 기본값이 ModelScope denoiser(ZipEnhancer)까지 받음. 폐쇄망이면 load_denoiser=False 또는 미리 내려받기 |
| 메모리 | CPU bf16에서 RSS 10.5GB. GPU는 README 기준 ~8GB VRAM. KV 캐시를 8,192 길이로 미리 잡으므로 긴 참조 음성은 컨텍스트를 빨리 소모 |
| 동시성 | 레퍼런스 구현은 배치 1. 서비스는 Nano-vLLM 또는 vLLM-Omni로 |
| 결과 변동 | Voice Design·제어형 클로닝은 실행마다 결과가 달라 README도 1~3회 재생성을 권함. seed 고정 + retry_badcase 조합 검토 |
| 오용 방지 | README가 사칭·사기·허위정보 사용을 금지하고 AI 생성 표시를 권고. 클로닝 기능을 외부에 열 때는 본인 동의 확인·워터마크·로그 정책을 별도로 설계해야 함(저장소에 워터마크 기능은 없음) |
| 언어 커버리지 | 공식 30개 언어 밖은 보장 없음. 벤치상 아랍어·체코어·루마니아어·힌디어 WER이 두 자릿수인 테스트가 있음 |
정리하면 VoxCPM2는 “토큰 없이 연속값으로 말한다”는 아이디어를 2B 규모, 30개 언어, 48kHz까지 밀어붙인 저장소입니다. 연구 코드가 깔끔하게 읽히고(핵심 모델 파일 하나에 생성 루프가 다 있음) Apache-2.0이라 내부 서비스에 붙이기도 좋습니다. 다만 PyPI 릴리스와 문서의 간극, 상한 없는 의존성, 배치 1 레퍼런스 구현, 테스트 격리 문제 같은 “연구실 냄새”는 아직 남아 있습니다. 도입한다면 커밋 고정 → CPU/GPU 스모크 → vLLM-Omni나 Nano-vLLM으로 서빙 → 클로닝 정책 수립 순서를 권합니다.