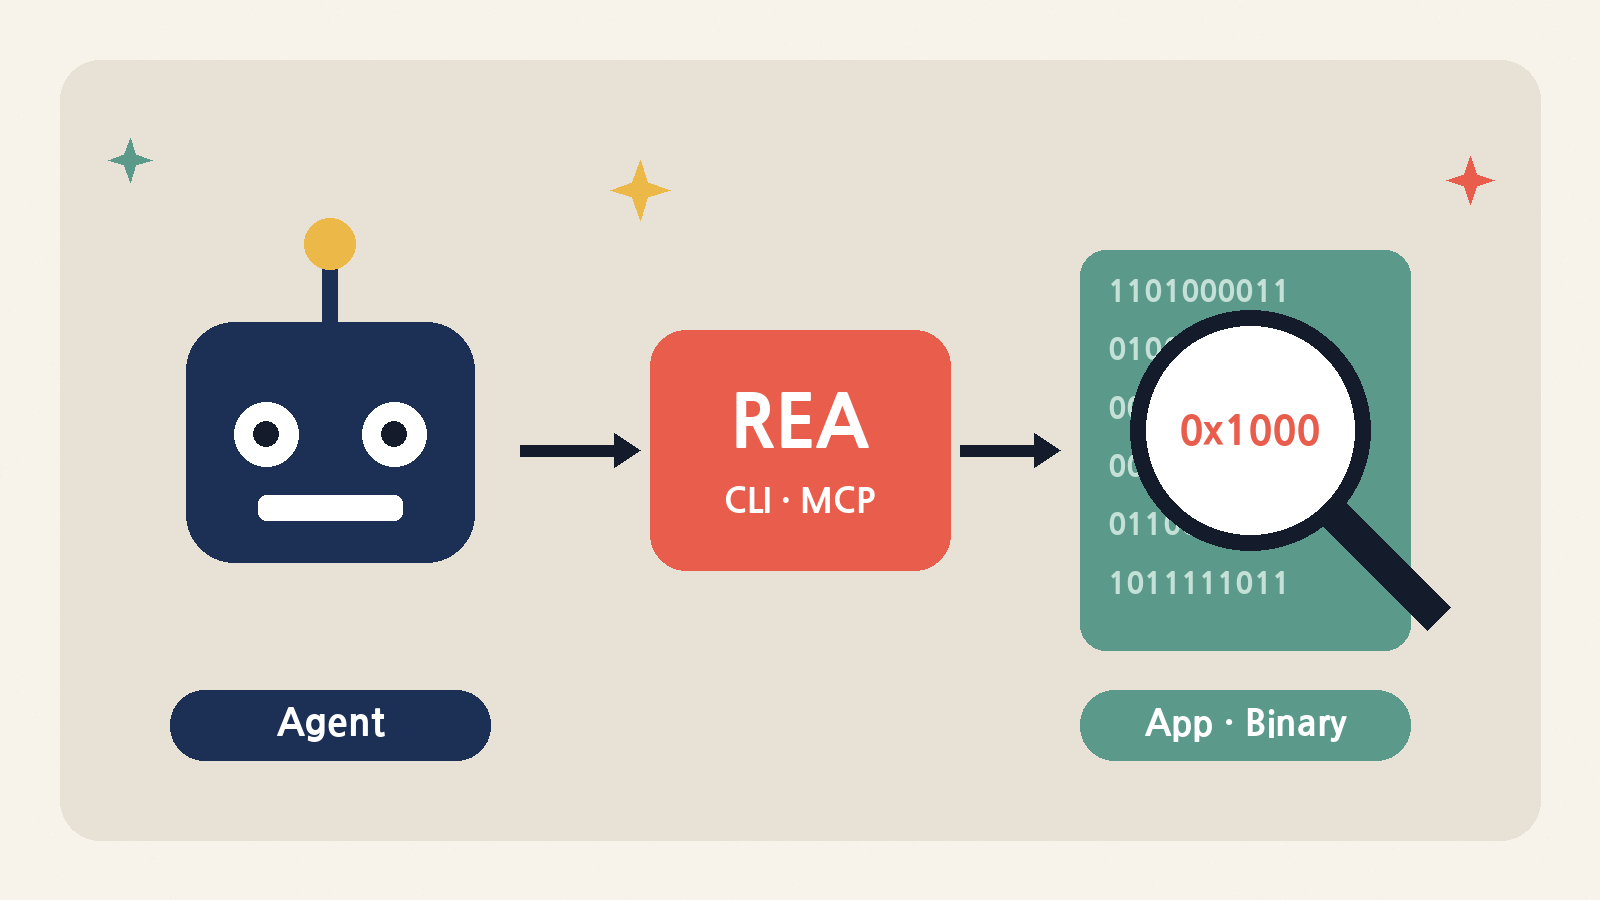
에이전트에게 “이 앱의 오프라인 검색이 어떻게 동작하는지 알아봐 줘”라고 맡기면, 소스가 없는 순간 대개 추측이 시작된다. 오늘(10월 7일) GitHub Trending 일간 목록에서 하루 상승폭이 가장 컸던 morluto/rea(REA: Reverse Engineer Anything)는 이 빈틈을 겨냥한다. Hopper·Ghidra·IDA 같은 디스어셈블러, Electron·JavaScript 정적 분석, .NET 메타데이터, APK, 펌웨어, 브라우저 관찰을 하나의 CLI와 MCP 서버로 묶고, 모든 결과를 생산 엔진·신뢰도·한계가 붙은 Evidence로 돌려준다. 16시 52분(KST) 기준 별 10,783개, 오늘 하루 +2,956개. 이 글은 실무자 관점에서 구조와 설계 판단, 직접 설치·테스트한 결과, 대안 비교, 그리고 기술보다 무거운 법·데이터 리스크까지 정리한다. 테크부터 경제, 생활까지 복잡한 소식을 쉽게 풀어보는 MoricWorld의 오후 오픈소스 심층 편이다.
한눈에 보는 프로젝트 현황
| 항목 | 확인한 값 (10/7 KST 기준) | 해석 |
|---|---|---|
| 저장소 / 패키지 | morluto/rea / npm rea-agents |
CLI 이름은 rea, MCP 레지스트리 이름은 io.github.morluto/rea |
| 별 / 포크 | 10,783 / 1,188 (16:52 KST, Trending 페이지) | 같은 시각 일간 Trending에서 ‘오늘 +2,956’으로 목록 중 상승폭이 가장 컸다 |
| 최신 릴리스 | 4.1.0 (npm 게시 10/7 03:06 KST) | 4.0.0이 10/6 03:38 KST, 4.0.1이 같은 날 03:58 KST. npm 첫 버전(0.2.1)은 7/12. 지금까지 25개 버전 |
| main 상태 | HEAD faaee69 (10/7 16:46 KST) |
README가 스스로 ‘main이 npm 릴리스보다 앞설 수 있다’고 경고한다 |
| 라이선스 | MIT | Hopper·IDA는 별도 상용 라이선스, Ghidra는 별도 설치(Apache-2.0) |
| 런타임 | Node.js 22.19+ / 24.11+ / 26+ | 호스트는 macOS 12+, Ubuntu 24.04+, Fedora 41+, 64비트 Arch |
| 규모 | MCP 도구 130개, CLI 1차 명령 85개, 프로바이더 22개, 셋업 대상 에이전트 12종 | docs/product-catalog.json에 소스에서 생성된 수치로 기록돼 있다 |
숫자만 보면 ‘MCP 도구 130개짜리 거대한 래퍼’처럼 보이지만, 코드를 열어 보면 무게중심은 다른 곳에 있다. 이 프로젝트가 진짜로 풀려는 문제는 “에이전트가 바이너리에 대해 말한 것을 무엇으로 검증하나”다. 디컴파일러는 원래 소스가 아니라 추정된 의사코드를 내놓고, 같은 바이트라도 엔진·버전·로더 설정에 따라 결과가 다르다. 사람 분석가는 이 불확실성을 감각으로 다루지만, 에이전트는 그럴듯한 문장으로 덮어 버리기 쉽다. REA는 이 간극을 도구 수가 아니라 계약(contract)으로 메우려 한다.
해결하려는 문제: ‘도구 연결’이 아니라 ‘증거 관리’
README가 제시하는 조사 모델은 디컴파일(Decompile) → 이해(Understand) → 재구성(Recreate)의 세 단계다. 대표 시나리오에서는 에이전트가 open_binary, binary_overview로 대상을 열고, search_strings·search_procedures로 단서를 찾고, find_xrefs_to_name·procedure_callers로 코드를 잇고, get_call_graph로 제어 흐름을 복원한 뒤 procedure_pseudo_code·batch_decompile로 해당 루틴을 읽는다. 여기까지가 REA의 몫이고, 마지막 ‘내 프로젝트에 구현’은 에이전트가 평소의 편집·테스트 도구로 한다.
흥미로운 건 이 흐름 곳곳에 박힌 부정형 문장이다. “원래 소스를 복원한다고 주장하지 않는다”, “관찰이 없다는 것은 두 실행이 같다는 증거가 아니다”, “상관관계에서 인과를 주장하지 않는다”, “재구성 검사는 증거가 없으면 통과가 아니라 unknown”. 결과물의 필드 구성도 같은 철학을 따른다. 모든 응답은 subject(대상 이름·SHA-256), provider, operation, parameters, normalized_result, confidence, authority, limitations, locations로 이루어진 봉투에 담긴다. 에이전트는 결론과 함께 “무엇을 몰랐는지”를 받는다.
아키텍처와 저장소 구조
| 디렉터리 | 역할 | 눈여겨볼 점 |
|---|---|---|
src/domain/ (약 5.2만 줄) |
Evidence, 분석 스냅샷, 바이너리 타깃, 비교 규칙 같은 순수 모델 | 전체 비테스트 TS 약 14.2만 줄 중 가장 크다. 도구보다 ‘증거의 문법’에 코드가 몰려 있다 |
src/application/ (약 3.2만 줄) |
세션, AnalysisProviderRegistry, CompositeProvider, 워크플로 조합 |
딥 프로바이더 선택과 보조 프로바이더 합성이 여기서 갈린다 |
src/hopper, ghidra, ida |
딥 분석 엔진 어댑터 | Hopper는 bridge/hopper_bridge.py, Ghidra는 bridge/ghidra/*.java 헤드리스 브리지를 띄운다 |
src/javascript, browser, inspector |
Electron·JS 정적 그래프, CDP 수동 관찰, V8 Inspector | 정적 분석은 번들 코드를 실행하지 않고 AST로만 관계를 복원 |
src/dotnet, android, firmware |
.NET 메타데이터·CIL, JADX 기반 APK, Binwalk·Unblob | 외부 도구는 모두 ‘사용자가 가져오는(BYO)’ 방식 |
src/server, src/cli |
MCP 서버와 CLI 진입점 | 같은 워크플로·같은 Evidence 계약을 공유(CLI·MCP 동등성) |
skills/reverse-engineer-anything/ |
에이전트용 SKILL.md(버전 26)와 참조 문서 5종 | ‘소스 저장소 분석에는 REA를 쓰지 말라’는 사용 범위까지 적혀 있다 |
docs/adr/ |
설계 결정 기록 3건 | 0001 프로바이더 선택, 0002·0003은 실행형 기능을 제거한 기록 |
TypeScript 비테스트 코드가 약 14.2만 줄, 테스트 코드가 약 8.7만 줄이다(줄 수는 이번에 클론한 main 기준으로 직접 셌다). 이 중 src/domain/이 약 5.2만 줄로 가장 크다는 점이 구조를 잘 설명한다. 엔진 어댑터는 비교적 얇고, Evidence·스냅샷·비교·재구성 의무(obligation) 같은 증거 모델이 두껍다. 테스트도 모듈·컴포지션·경계(boundary)·MCP 경계·수용(acceptance)·적합성(conformance)·평가로 층을 나눠, “경로 이름만으로 테스트 깊이를 주장하지 말라”는 원칙을 docs/testing.md에 적어 두었다. 실제 Hopper·Ghidra·IDA·브라우저 동작은 별도의 npm run verify:* 레인으로 분리된다.
엔진과의 통신도 눈여겨볼 만하다. Hopper 브리지(bridge/hopper_bridge.py)는 Hopper 내부 파이썬 스레드에서 돌며, 현재 사용자 전용 Unix 소켓과 무작위 capability 토큰으로 요청마다 인증한다(hmac.compare_digest로 비교). SECURITY.md에 따르면 토큰은 프로세스 인자나 환경 변수가 아니라 비공개 세션 디스크립터로 전달된다. 다만 같은 문서가 곧바로 “이것은 샌드박스가 아니며 이미 실행 중인 악성 프로세스로부터 보호하지 않는다”고 선을 긋는다. 리눅스에서 Hopper 데모를 띄울 때는 Xvfb 기반 비공개 가상 디스플레이를 써서 사용자 데스크톱을 건드리지 않는다.
핵심 설계 결정 1: 딥 프로바이더는 하나만, 조용한 폴백은 없다
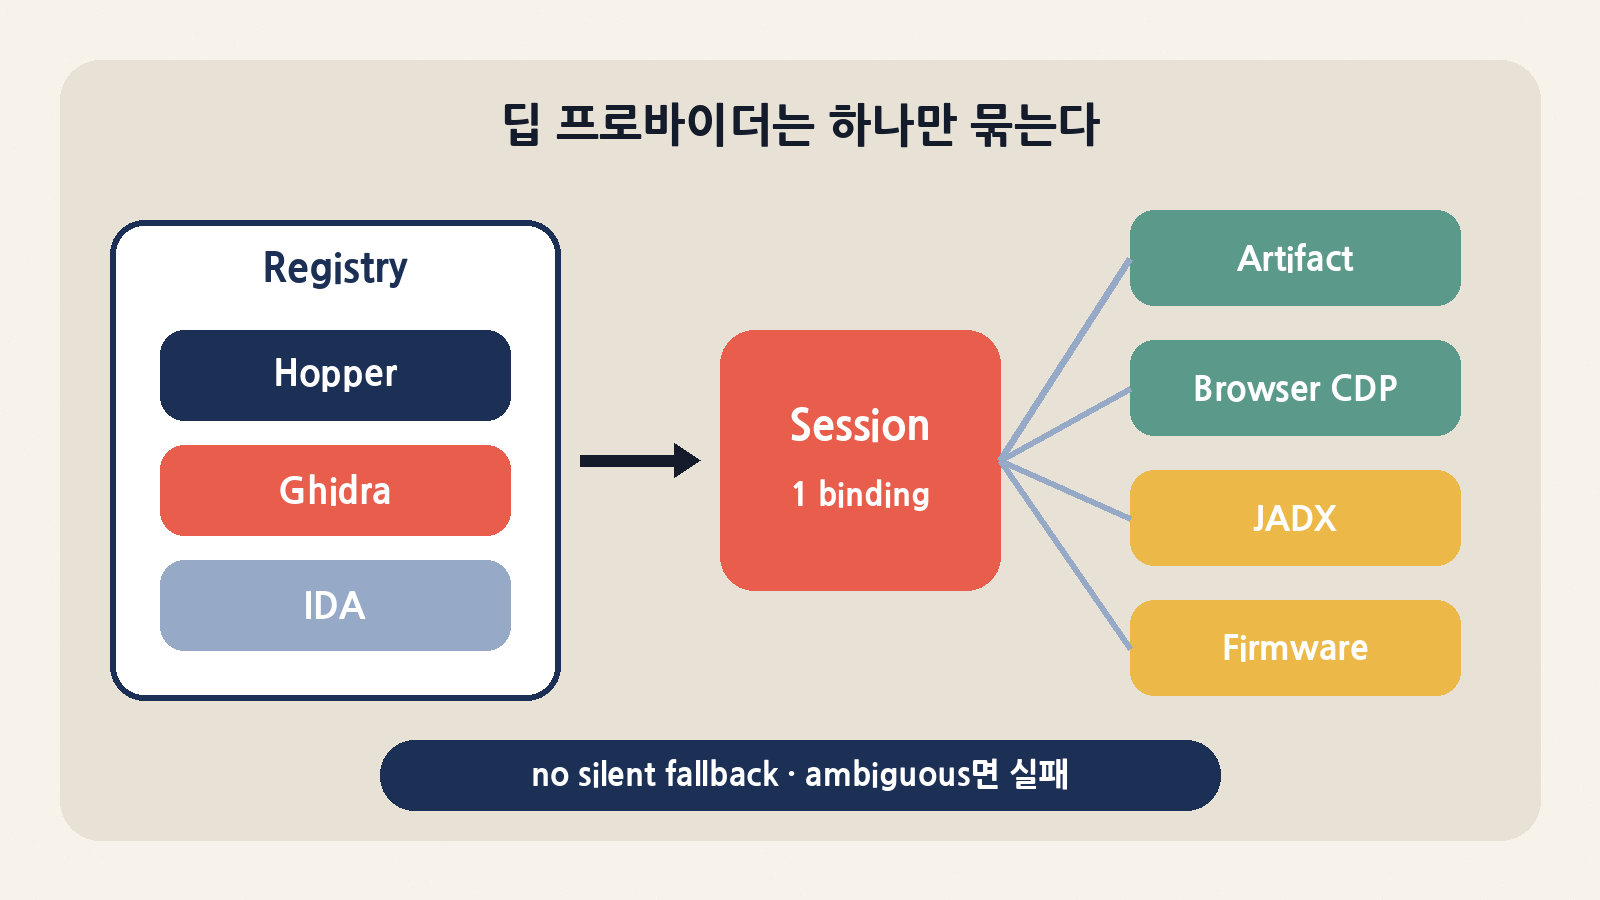
가장 실무적인 설계 판단은 ADR-0001(2026-07-15, ‘프로바이더 선택과 분석 프로필’)에 있다. 초기 REA는 아티팩트·macOS 네이티브·Hopper 프로바이더를 CompositeProvider로 합쳤는데, 이 클래스는 연산마다 경로가 정확히 하나여야 한다. Ghidra가 Hopper와 같은 ‘딥 정적 분석’ 연산군을 구현하게 되자, 둘을 그냥 합치면 생성 단계에서 실패하거나 배열 순서가 곧 선택 정책이 되는 문제가 생겼다. 해법은 두 층 분리다. 서로 겹치지 않는 연산군(아티팩트, 브라우저 CDP, JADX, 펌웨어)은 기존처럼 합성하고, 겹치는 딥 엔진은 새 AnalysisProviderRegistry가 후보로 들고 있다가 대상 하나에 정확히 하나만 바인딩한다.
| 선택 상황 | REA의 동작 | 운영상 의미 |
|---|---|---|
| 설치된 딥 엔진이 하나 | auto-single-candidate로 자동 선택 |
대부분의 개인 환경은 설정 없이 동작 |
| Hopper와 Ghidra가 모두 사용 가능 | capability_unavailable + selection_reason: ambiguous로 실패 |
등록 순서나 응답 속도로 고르지 않는다. --provider, provider_id, REA_ANALYSIS_PROVIDER 중 하나로 명시 |
| 지정한 엔진이 고장 | provider_unavailable, 다른 엔진으로 넘어가지 않음 |
rea doctor --provider <id> --json의 처방을 따르면 된다 |
| 한 세션 안에서 일부 연산 미지원 | 그 연산만 ‘사용 불가’로 반환 | 다른 엔진에서 한 연산만 빌려오지 않아 결과를 만든 엔진이 섞이지 않는다 |
| 스냅샷 재사용 | 대상 바이트·연산·파라미터·엔진·설정이 모두 같을 때만 | 엔진 버전이나 로더 설정이 바뀌면 캐시가 무효. 재현성 우선 |
이 결정의 비용은 분명하다. Hopper와 Ghidra를 둘 다 설치한 사용자는 처음에 ‘ambiguous’ 오류를 만난다. 대신 얻는 것은 결과를 만든 엔진이 섞이지 않는다는 보장이다. 같은 함수에 대해 어제는 Hopper 의사코드, 오늘은 Ghidra 의사코드가 섞여 들어와 에이전트가 모순된 설명을 내놓는 상황을 구조적으로 막는다. 분석 프로필(엔진·엔진 버전·정규화된 분석 설정)을 스냅샷 호환성에 포함시킨 것도 같은 맥락이다. 예전 스냅샷 v1은 로더 인자는 기록했지만 엔진 버전과 분석 설정은 기록하지 않아, 실제로는 다른 조건의 분석이 ‘같은 대상’처럼 보일 수 있었다고 ADR이 스스로 적고 있다.
핵심 설계 결정 2: Evidence 봉투와 스냅샷
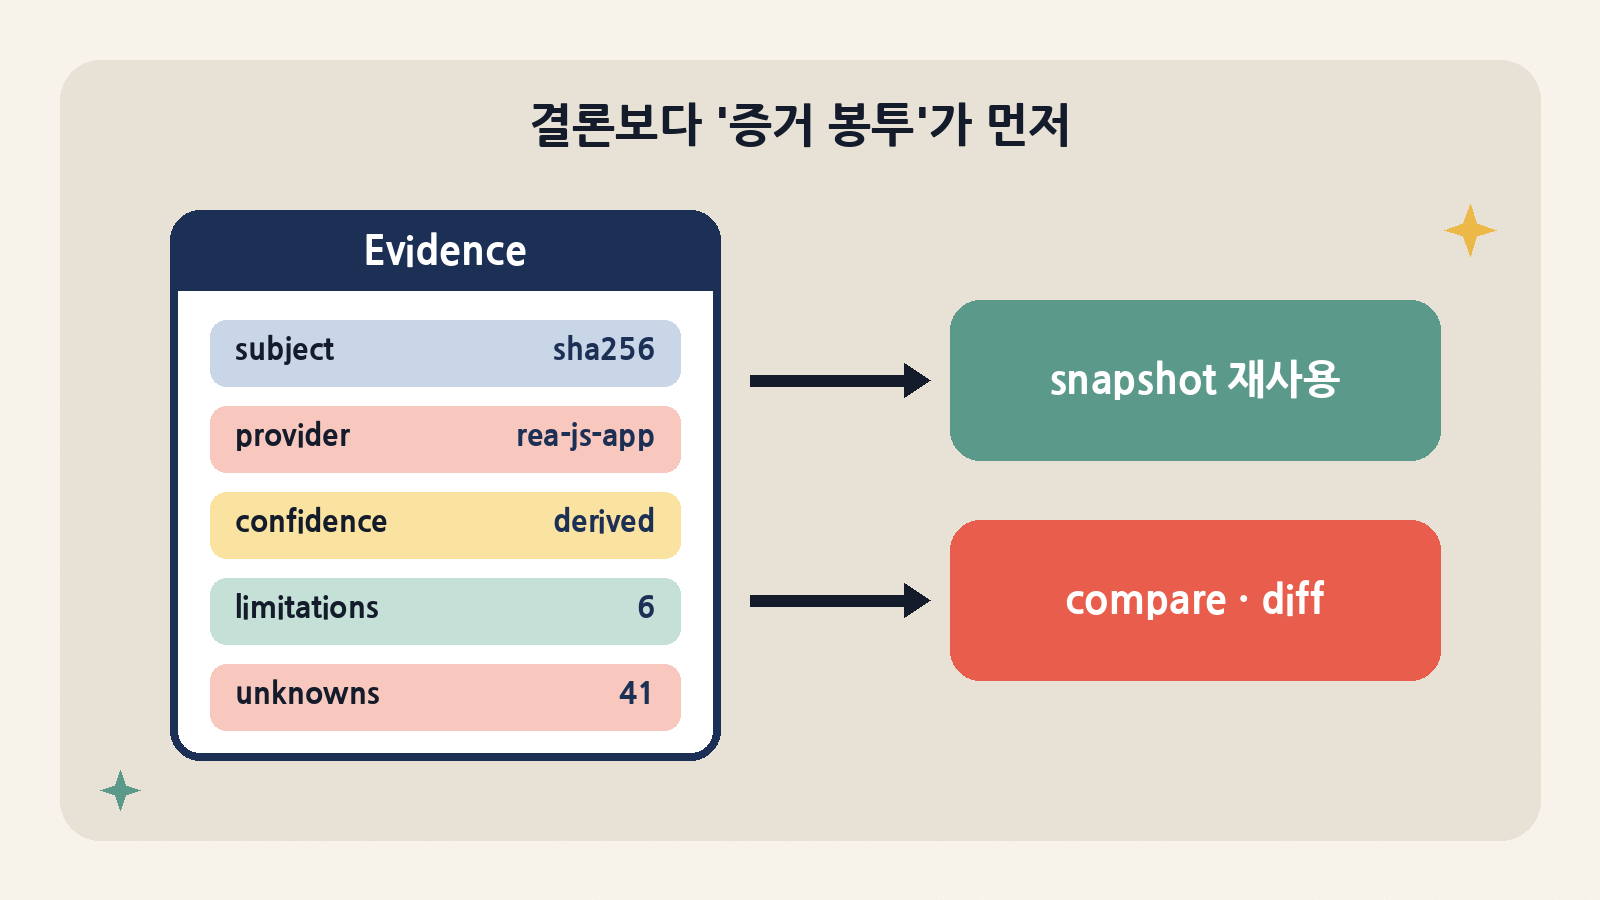
모든 도구가 같은 Evidence 봉투를 쓰기 때문에, 결과를 파일로 내보내고(evidence-export), 검증해 들여오고(evidence-import), 두 묶음을 비교(compare)하는 것이 엔진과 무관하게 된다. 스냅샷(--snapshot)은 대상 바이트·연산·파라미터·엔진·설정이 모두 일치할 때만 재사용되고, 커서 위치에 의존하는 호출이나 변경 연산은 캐시하지 않는다. 스냅샷 파일은 소유자 전용 권한으로 저장된다. CI에 넣으면 “새 빌드에서 이 함수의 호출 그래프가 바뀌었나” 같은 질문을 엔진을 다시 띄우지 않고도 답할 수 있다.
도구 설계 원칙(docs/tool-design.md)도 흥미롭다. 도구 모양을 inspect, search/list, trace, compare, workflow, observe/capture로 나누고, “에이전트 예산에 맞춘다는 이유만으로 인위적 제한을 두지 말라, 대신 실제 형식·권한·자원 제약은 남기고 그 효과를 보고하라”고 적는다. 특정 앱의 비즈니스 규칙에 의존하는 해석은 범용 도구 계약 밖에 두고, 그 아래의 증거만 재사용 가능한 원시 도구로 노출한다. MCP 서버를 설계하는 다른 팀도 한 번 읽어 볼 만한 문서다.
핵심 설계 결정 3: 읽기·관찰·실행의 권한 경계
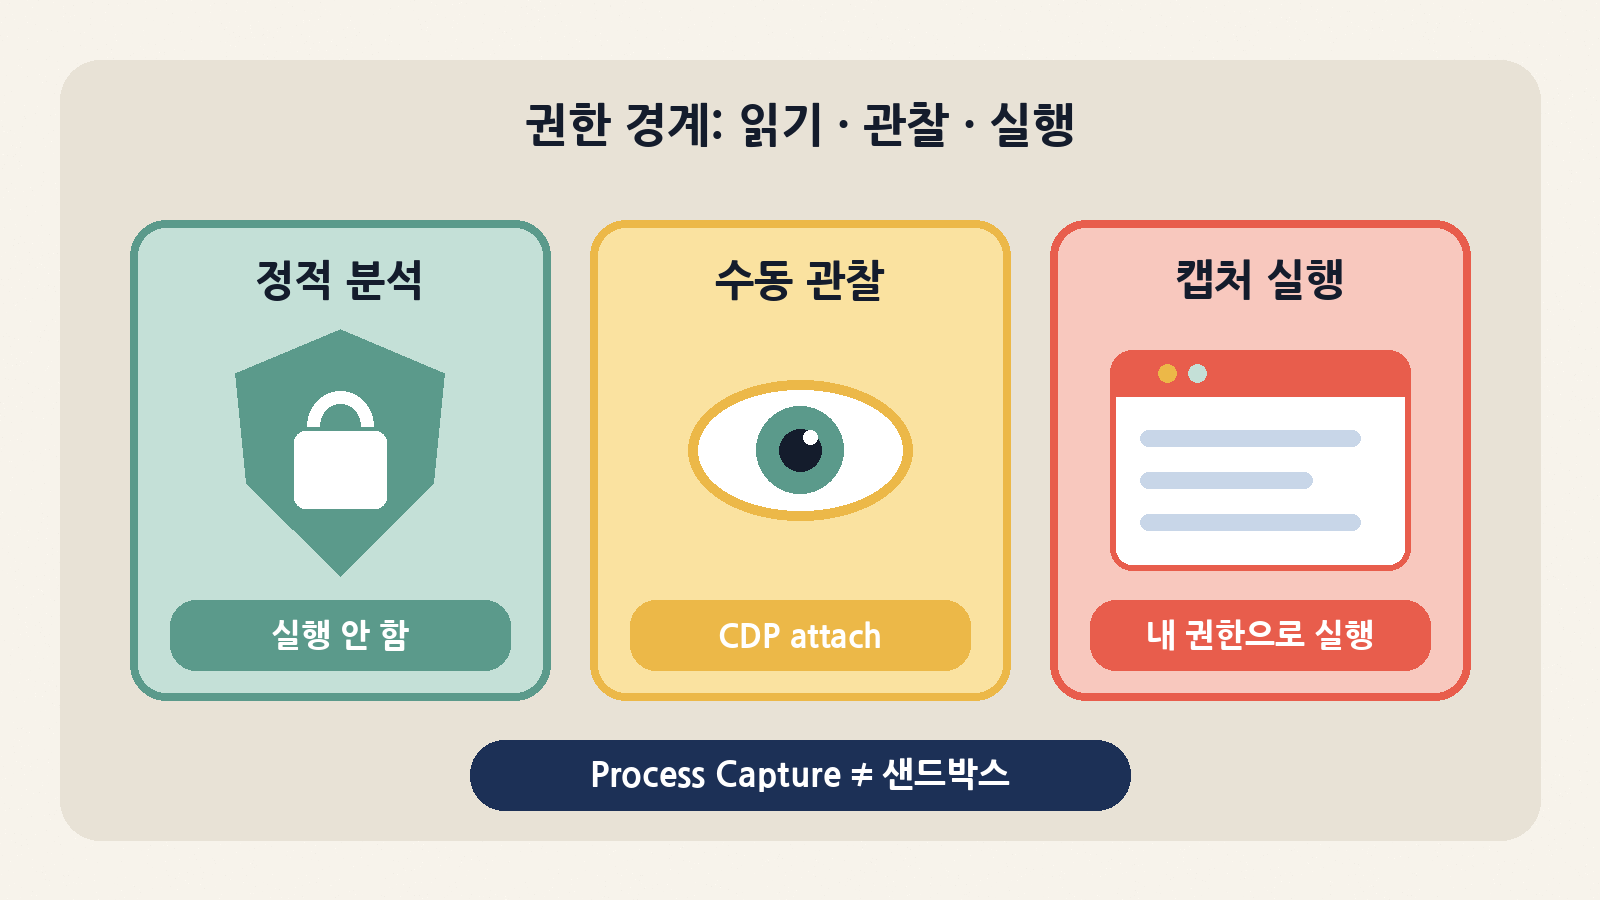
REA의 기능은 권한 수준으로 세 층이 된다. 첫째, 정적 분석은 대상을 실행하지 않는다. JavaScript·Electron 분석은 번들을 비활성 텍스트로 파싱해 모듈·IPC 채널·preload·contextBridge 관계를 복원하고, Ghidra는 대상의 임시 사본을 분석한 뒤 세션 종료 시 임시 프로젝트를 지운다. 둘째, 수동 관찰은 이미 실행 중인 Chrome 계열 브라우저나 Electron에 루프백 CDP로 붙어 페이지를 탐색·클릭·평가하지 않고 구조와 네트워크 메타데이터를 기록한다. 쿠키·인증 헤더·원시 페이로드 값은 보존하지 않는다고 명시한다. 셋째, 캡처 실행(capture-process, Playwright 기반 브라우저 시나리오)은 요청에 선언된 실행 파일과 시나리오를 사용자 권한으로 실제로 돌린다.
각 프로바이더는 연산별로 mutates_artifact, launches_process, may_show_ui, may_access_network, may_write_filesystem, requires_root 같은 부작용을 선언하고, rea capabilities로 이를 그대로 볼 수 있다. ADR-0002와 0003은 거꾸로 기능을 뺀 기록이라 더 흥미롭다. 추출한 JavaScript 모듈을 통제된 입력으로 실행해 버전 간 동작을 비교하는 ‘통제 재생’ 도구를 설계했다가, Node의 vm 컨텍스트나 권한 모델이 악성 코드 격리 경계가 아니라는 판단 끝에 구현 자체를 제거했다. “샌드박스를 보장할 수 없으면 더 약한 모드로 내려가지 말고 기능을 사용 불가로 만든다”는 원칙이 실제 코드 삭제로 이어진 사례다.
설치·실행·평가: 직접 돌려 본 결과
박스(리눅스 x64, Hopper·Ghidra·IDA 미설치)에서 main을 얕게 클론해 확인했다. 기본 Node가 20이라 요구 버전을 맞추려고 Node 22.20.0을 따로 받았다.
git clone --depth 50 https://github.com/morluto/rea && cd rea
npm ci            # 244개 패키지, 약 4초
npm run build     # tsc 빌드 성공
npx vitest run    # 520개 파일 중 512 통과·8 건너뜀
                  # 테스트 4,181 통과·32 건너뜀, 약 276초
엔진 없이 바로 쓸 수 있는 경로는 정적 JavaScript 분석이다. BrowserWindow·preload·contextBridge·ipcMain.handle을 가진 6개 파일짜리 가짜 Electron 노트 앱을 만들어 돌려 봤다.
node scripts/rea.mjs analyze-javascript-application /abs/path/sample-app --json
# 약 2초, JSON 약 880KB
# summary: browser_windows 1, preload_entrypoints 1, context_bridge_apis 1
#          ipc.main_handlers 1, paired_renderer_transmissions 1
#          sender_validation_observations 0
# semantic_graph: 노드 177, 관계 105, unknowns 41, limitations 6
작은 앱인데도 출력이 880KB에 이른다는 점은 기억해 둘 만하다. 에이전트 컨텍스트에 그대로 넣기보다는 요약 필드와 Evidence ID 위주로 읽히는 편이 낫다. 반면 결과의 질은 기대 이상이었다. 렌더러의 ipcRenderer.invoke('notes:search')와 메인 프로세스 핸들러를 짝지어 냈고, IPC 발신자 검증 코드가 없다는 사실(sender_validation_observations: 0)을 따로 세어 준다. Electron 앱 보안 검토에서 바로 쓸 수 있는 신호다. 결과마다 “Electron 관계는 비활성 구문에서 도출됐으며 런타임 등록·도달 가능성은 증명되지 않았다”는 한계 문장이 붙는다.
rea inspect-artifact /usr/bin/ls --json은 엔진 없이도 ELF 인벤토리를 약 1.6초에 반환했고, rea doctor --json은 엔진이 없는 박스에서 예상대로 healthy: false를 냈다. 문서 설명대로 전체 감사 결과이므로, 운영에서는 작업 범위를 지정한 doctor를 쓰는 게 맞다. 실제 Hopper·Ghidra·IDA로 함수 디컴파일까지 하는 경로와 verify:* 레인은 이번에 돌리지 않았다. 딥 분석 품질에 대한 판단은 각자 표준 엔진으로 직접 확인해야 한다.
# 에이전트 연결(변경 계획을 먼저 보여 주고 승인 후 적용)
npx rea-agents setup
# 수동 MCP 등록은 정확한 버전으로 고정
{{ "mcpServers": {{ "rea": {{ "command": "npx", "args": ["-y", "rea-agents@4.1.0", "mcp"] }} }} }}
# 엔진 선택을 명시
export REA_ANALYSIS_PROVIDER=ghidra
export GHIDRA_INSTALL_DIR=/opt/ghidra_12.1.4_PUBLIC # Ghidra 12.1.x + JDK 21| 점검 항목 | 방법 | 합격 기준 예시 |
|---|---|---|
| 설치 무결성 | npm ci → npm run build → npx vitest run |
실패 0. 이번 박스에서는 4,181개 통과·32개 건너뜀 |
| 작업 범위별 준비 상태 | rea doctor --provider ghidra --json, --client cursor, --skill |
전체 감사(doctor)의 healthy:false는 무시하고 scope_checks만 본다 |
| 버전 고정 | MCP 설정에 rea-agents@4.1.0처럼 정확한 버전 |
@latest는 CLI 일회성 실행에만 |
| 근거 검증 | 결과의 provider, confidence, limitations, unknowns 필드 확인 |
에이전트 답변 속 주장마다 Evidence ID를 붙이도록 프롬프트에 요구 |
| 재현성 | --snapshot 저장 후 같은 질의 재실행, rea compare |
같은 입력이면 같은 Evidence 해시 |
| 실제 엔진 검증 | npm run verify:* 레인(Hopper·Ghidra·IDA·브라우저) |
사내 표준 엔진·버전 조합으로 한 번은 직접 돌려 볼 것 |
CLI 종료 코드 규약도 자동화에 유리하다. 0은 ‘완료(경고·부분 증거 포함 가능)’, 1은 ‘완료 불가’, 128+N은 시그널 종료다. README는 파이프라인에서 set -o pipefail을 켜라고 권한다. 저장소에는 실제 Codex CLI로 네이티브·JS·관리 코드·브라우저 조사 과제를 돌려 도구 선택, 반복 호출, 토큰 사용, 완료 품질, 미확인 처리 방식을 채점하는 npm run verify:agent도 있다. 사내 에이전트를 붙일 때 같은 과제로 모델·프롬프트를 비교하는 기준선으로 쓰기 좋다.
대안과 비교
| 대안 | 강점 | 약점 | 어울리는 상황 |
|---|---|---|---|
| REA | 엔진 중립 도구 이름, Evidence·한계·미확인 항목을 구조화해 반환, CLI·MCP 동등, JS/Electron·.NET·APK·펌웨어·브라우저까지 한 서버 | 표면이 넓고(도구 130개) 빠르게 바뀜. 딥 분석 품질은 결국 Hopper·Ghidra·IDA에 의존 | 여러 형태의 산출물을 한 에이전트 세션에서 오가며 조사하는 팀 |
엔진 전용 MCP(예: mrexodia/ida-pro-mcp, Ghidra용 MCP 플러그인류) |
해당 엔진 기능을 얇게, 거의 그대로 노출. 구조가 단순 | 엔진마다 도구 이름·출력 형식이 달라 프롬프트와 평가를 따로 만들어야 함 | 이미 한 엔진에 표준화된 리버서 팀 |
| 엔진 스크립트 직접 작성(Ghidra headless, IDAPython, r2pipe 등) | 완전한 통제, CI에 넣기 쉬움, 재현성 높음 | 에이전트 친화적 계약·증거 포맷을 직접 설계해야 함 | 반복되는 정형 분석(패치 비교, 시그니처 추출) |
| 단일 포맷 도구(JADX, ILSpy 계열, asar 추출 등) | 특정 포맷에 깊고 성숙 | 포맷을 넘나드는 추적과 런타임 대조는 사람 몫 | 한 종류의 앱만 다루는 업무 |
| 사람 분석가 + GUI | 판단력, 난독화 대응 | 느리고 기록이 남지 않는 경우가 많음 | 고위험 취약점 분석, 법적 분쟁 대응 |
REA의 차별점은 개별 엔진 기능보다 엔진 중립 계약 + 증거 형식 + 포맷을 넘나드는 추적에 있다. 예컨대 Electron 앱의 렌더러 IPC를 따라가다가 네이티브 애드온으로 내려가고, 그 애드온을 Ghidra로 여는 흐름을 같은 세션·같은 Evidence 형식으로 이어 갈 수 있다. 반대로 이미 IDA 하나로 표준화된 팀이라면 REA가 IDA를 ‘첨부(attached)’ 모드에서 읽기 전용으로 쓰고 데이터베이스를 저장하지 않는다는 점을 감안해, 엔진 전용 MCP와 직접 비교 평가해 보는 편이 낫다. 문서상 IDA 실사용 검증은 Windows GUI와 Windows x64 헤드리스 IDA 9.3 조합까지다.
라이선스와 주의할 점
코드는 MIT라 도입 장벽이 낮다. 하지만 이 도구에서 라이선스보다 무거운 건 무엇을, 어떤 권한으로, 어디까지 분석하느냐다.
| 리스크 | 구체 내용 | 완화책 |
|---|---|---|
| 법·계약 | README 면책 조항대로 합법적 권한 확보는 사용자 책임. 상용 소프트웨어 EULA는 역분석을 금지하는 경우가 많고, 국내 저작권법(제101조의4)도 호환성 확보 등 제한된 목적·범위에서만 프로그램코드역분석을 허용한다 | 대상·목적을 문서화하고 법무 검토. 자사 제품, 오픈소스, 계약상 허용된 대상부터 |
| ‘보고 따라 만들기’의 저작권 문제 | README의 대표 시나리오가 ‘마음에 드는 기능을 분석해 내 제품에 구현’이다. 디컴파일 의사코드를 그대로 옮기면 침해 소지 | 분석 담당과 구현 담당을 나누는 클린룸 방식, 동작 명세만 넘기기 |
| 모델 제공자로의 데이터 흐름 | 분석은 로컬이지만 의사코드·문자열·심볼은 에이전트를 통해 모델 제공자로 간다. README도 ‘모델 제공자의 데이터 정책은 별개’라고 명시 | 기밀 바이너리는 사내·로컬 모델 에이전트로, 또는 CLI로 사람이 직접 |
| 실행 권한 | Process Capture·브라우저 시나리오는 사용자 권한으로 실제 실행한다. 문서도 ‘보안 샌드박스가 아니다’라고 못박는다 | 악성 의심 샘플은 격리 VM에서만, 정적 분석 경로 우선 |
| 변경 속도 | 4.0.0 → 4.1.0이 하루 남짓, main이 npm보다 앞서 있음. 스킬 문서가 main 기준이면 구버전 서버에 없는 도구를 설명할 수 있다 | 서버·스킬 버전 동시 고정, rea update 계획은 검토 후 승인 |
| 엔진 라이선스 | Hopper 데모는 벤더 제한이 있고, IDA는 상용 | 팀 표준 엔진을 정하고 그 엔진만 활성화해 ambiguous 실패도 예방 |
특히 ‘마음에 드는 기능을 보고 내 제품에 만든다’는 메시지는 매력적인 만큼 조심해야 한다. REA 자신도 원래 소스를 복원하지 않으며 의사코드는 추정이라고 강조한다. 실무에서는 리버싱 결과를 동작 명세와 테스트 케이스로 정리해 넘기고, 구현은 그 명세만 보고 하는 클린룸 구조가 안전하다. README 쇼케이스의 DX-Ball 재구성 프로젝트가 원본 x86과의 차분 테스트(3,205개 케이스)로 동작 일치를 확인하는 방식도 같은 방향이다.
누가 도입하면 좋은가
- 보안·취약점 분석 팀: Electron·JS 데스크톱 앱의 IPC·preload·contextBridge 노출면을 정적으로 빠르게 훑는 용도는 엔진 없이도 바로 쓸 만하다.
- 호환성·마이그레이션 담당: 문서가 없는 레거시 바이너리·파일 포맷·.NET 어셈블리의 인터페이스를 복원하고, 빌드 간 차이를 Evidence로 비교해야 하는 경우.
- 자사 제품 회귀 분석: 출시 바이너리와 이전 버전을 스냅샷·compare로 대조해 ‘무엇이 바뀌었나’를 증거와 함께 남기려는 릴리스 엔지니어링 팀.
- 신중해야 할 팀: 경쟁사 앱 분석이 주목적이거나, 기밀 바이너리를 외부 모델로 보내야 하는 구조라면 법무·보안 검토가 먼저다.
정리하면 REA는 “에이전트에게 디스어셈블러를 쥐여 준다”보다 “에이전트의 리버싱 결과를 감사 가능한 증거로 만든다”에 가까운 프로젝트다. 엔진은 하나만 바인딩하고, 폴백은 하지 않으며, 모르는 것은 모른다고 반환한다. 이 보수적인 설계가 오늘의 급등세보다 오래 남을 가치다. 도입한다면 버전을 고정하고, 엔진을 하나로 정하고, 정적 분석 경로부터 시작해 Evidence를 검토하는 습관을 팀에 먼저 심는 것을 권한다.