한 줄 요약: trymirai/uzu는 “LLM을 서버가 아니라 앱 프로세스 안에서 돌린다”는 목표로 만든 Rust 추론 엔진입니다. Apple Silicon의 통합 메모리와 Metal을 1순위로 겨냥하고, 같은 커널 체계를 WebGPU(Slang→WGSL)와 CPU로 넓혀 가는 중입니다. 모델은 코드가 아니라 config.json으로 조립되고, DFlash 드래프트와 Weaver 트리 확장을 묶은 트리형 투기 디코딩까지 엔진 안에 들어 있습니다. 이 글은 저장소 구조와 내부 동작을 코드 기준으로 읽고, 박스(Linux x86_64)에서 직접 변환·빌드·생성까지 돌려 본 결과를 정리합니다.
왜 오늘 이 저장소인가
2026년 10월 29일(KST) GitHub Trending Rust 일간 목록에서 6위, 하루 +260 stars로 올라왔습니다. 전체 스타는 2,999개(GitHub API 기준)로 규모 자체는 크지 않지만, 최근 커밋 흐름이 눈에 띕니다. 10월 28일(KST 20:20) 머지된 마지막 커밋이 WebGPU runtime (#380)이고, 그 직전 커밋들이 Optimize weight layout for untied readout, Remove f32 matmul입니다. 즉 “Apple 전용 엔진”에서 “Metal 우선 + 이식 가능한 런타임”으로 넘어가는 시점에 관심이 몰린 것으로 보입니다.
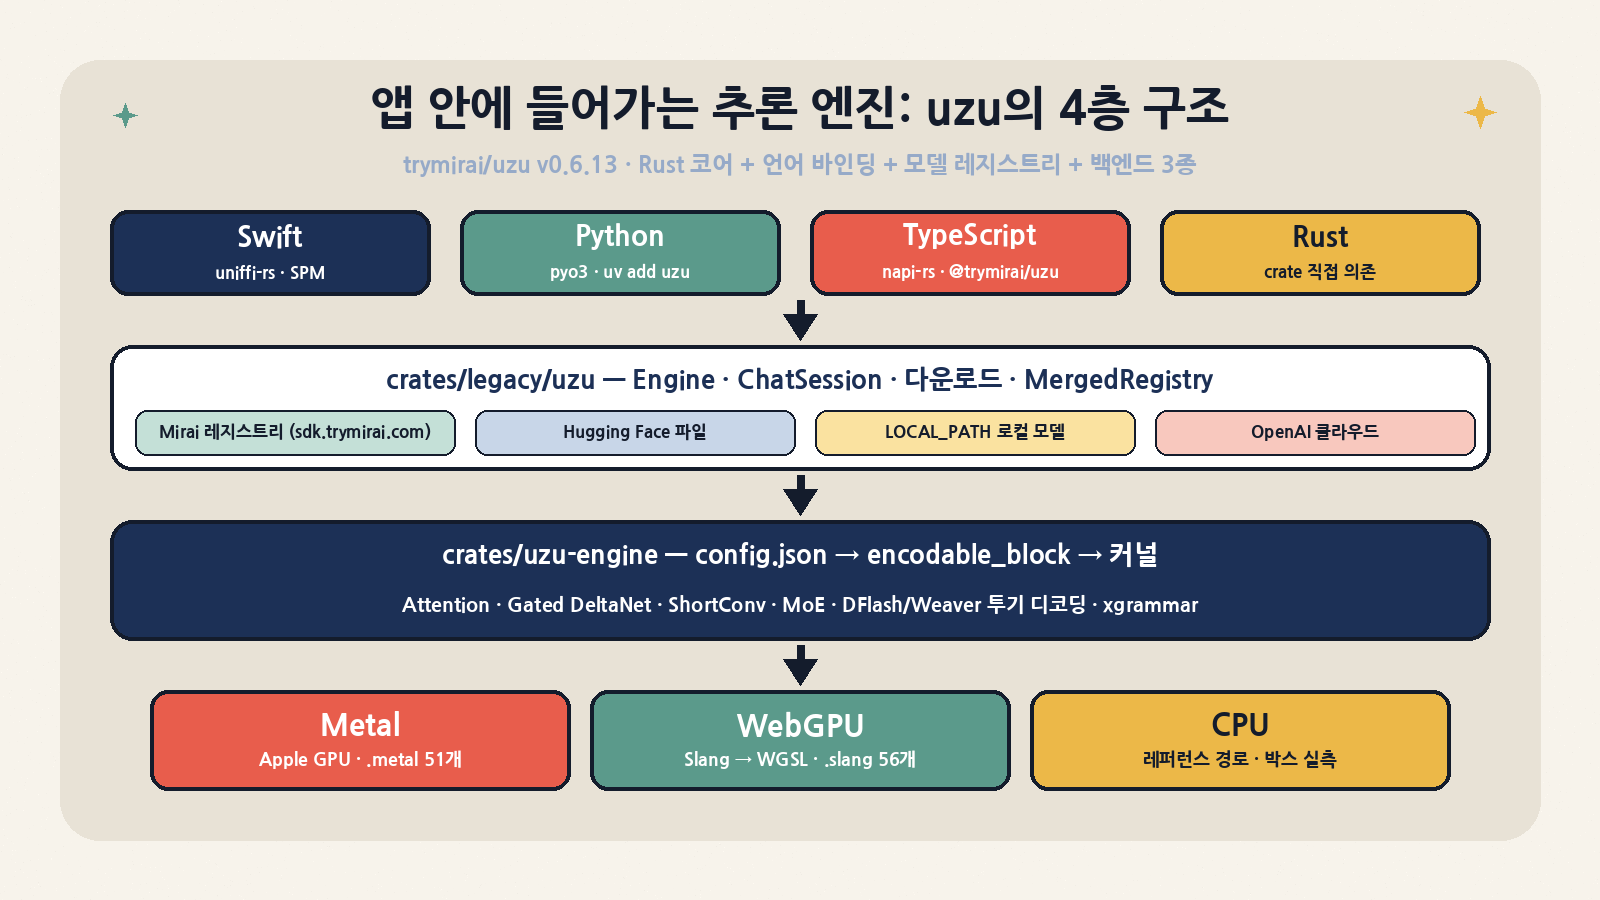
로컬 LLM 런타임은 이미 llama.cpp, MLX, Ollama가 자리를 잡은 시장입니다. uzu가 노리는 자리는 조금 다릅니다. CLI·데몬을 따로 띄우는 대신 Swift/Python/TypeScript/Rust 앱에 라이브러리로 링크해서, 모델 다운로드부터 세션 관리, 구조화 출력, 도구 호출까지 SDK 한 덩어리로 해결하는 쪽입니다.
프로젝트 스냅샷
| 항목 | 내용 |
|---|---|
| 저장소 | trymirai/uzu (Mirai Tech Inc.) |
| 라이선스 | MIT (변환 도구 lalamo도 MIT) |
| 최신 릴리스 | 0.6.13 (2026-10-23 00:43 KST 게시, 릴리스 노트 본문 없음) · 10월(KST)에만 0.6.0→0.6.13 사이 릴리스 10개 |
| 스타 / 포크 | 2,999 / 183 (2026-10-29 오전 기준) · 오늘 +260 |
| 언어 / 툴체인 | Rust edition 2024, rust-version = 1.98, rust-toolchain.toml은 nightly 고정 |
| 배포 패키지 | PyPI uzu==0.6.13(macOS arm64·x86_64 wheel만, Python ≥3.12) · npm @trymirai/uzu(os: darwin) · SwiftPM |
| 공식 지원 기기 | 문서 FAQ 기준 “현재 Apple Silicon(iOS/macOS)만” |
| 규모 | uzu-engine src Rust 약 26,100줄 · Metal 셰이더 51개 · Slang 셰이더 56개 |
저장소 구조: “새 엔진”과 “레거시 SDK”의 이중 구조
루트 Cargo.toml의 workspace 멤버를 보면 구조가 명확합니다. 핵심은 crates/uzu-engine(새로 쓰인 연산 코어)이고, 사용자가 실제로 만지는 API는 crates/legacy/* 아래에 있습니다. 주석에도 --- to be rewritten이라고 적혀 있어, SDK 계층은 아직 재작성 대상이라는 점을 감안해야 합니다.
| 경로 | 역할 | 실무 관점 메모 |
|---|---|---|
crates/uzu-engine |
설정 파싱, 블록 조립(encodable_block), 백엔드 커널, 투기 디코딩, 문법 제약 |
성능·정확성의 본체. 기본 feature는 metal, cpu, grammar, webgpu는 옵션 |
crates/uzu-engine-macros |
#[uzu_config] 등 설정 구조체 매크로 |
serde에 deny_unknown_fields를 강제 → 설정 스키마가 엄격 |
crates/legacy/uzu |
Engine/ChatSession, 다운로드, 레지스트리 병합, 오디오 재생(TTS) | README의 Quick Start가 쓰는 API. rodio 재생 의존성 포함 |
crates/legacy/bindings* |
Swift(uniffi-rs), Python(pyo3), TypeScript(napi-rs) 바인딩 | 네 언어 API가 거의 1:1로 대응 |
crates/legacy/cli |
대화형 CLI, bench, server, list-models |
OpenAI 호환 서버(/v1/chat/completions, /v1/models) |
hanashi · nagare · token-stream-parser · json-transform |
채팅 템플릿, 스트림/도구 호출 API, 토큰 스트림 파싱, JSON 변환 | 추론 결과를 reasoning/text/tool call로 쪼개는 계층 |
keisoku · kanka |
Apple 플랫폼 텔레메트리(CPU/GPU/전력/센서), 비공개 프레임워크 dlsym 바인딩 | uzu-engine에서는 macOS dev-dependency(벤치 쿨다운용)로만 연결 |
apps/ |
mirai-gui(Tauri v2 데스크톱), playground(Swift), uzu-pi-extension(Pi용 provider) | mirai-gui는 macOS 26.4+ · Xcode 26 Metal toolchain 요구 |
scripts/benchmarks |
llama.cpp, ML Drift, MLX, mlx-serve, MTPLX, oMLX, Splash 어댑터 | stdin/stdout JSON Lines로 같은 메트릭을 수집하는 공통 하네스 |
내부 동작 1: 모델은 설정으로 조립된다
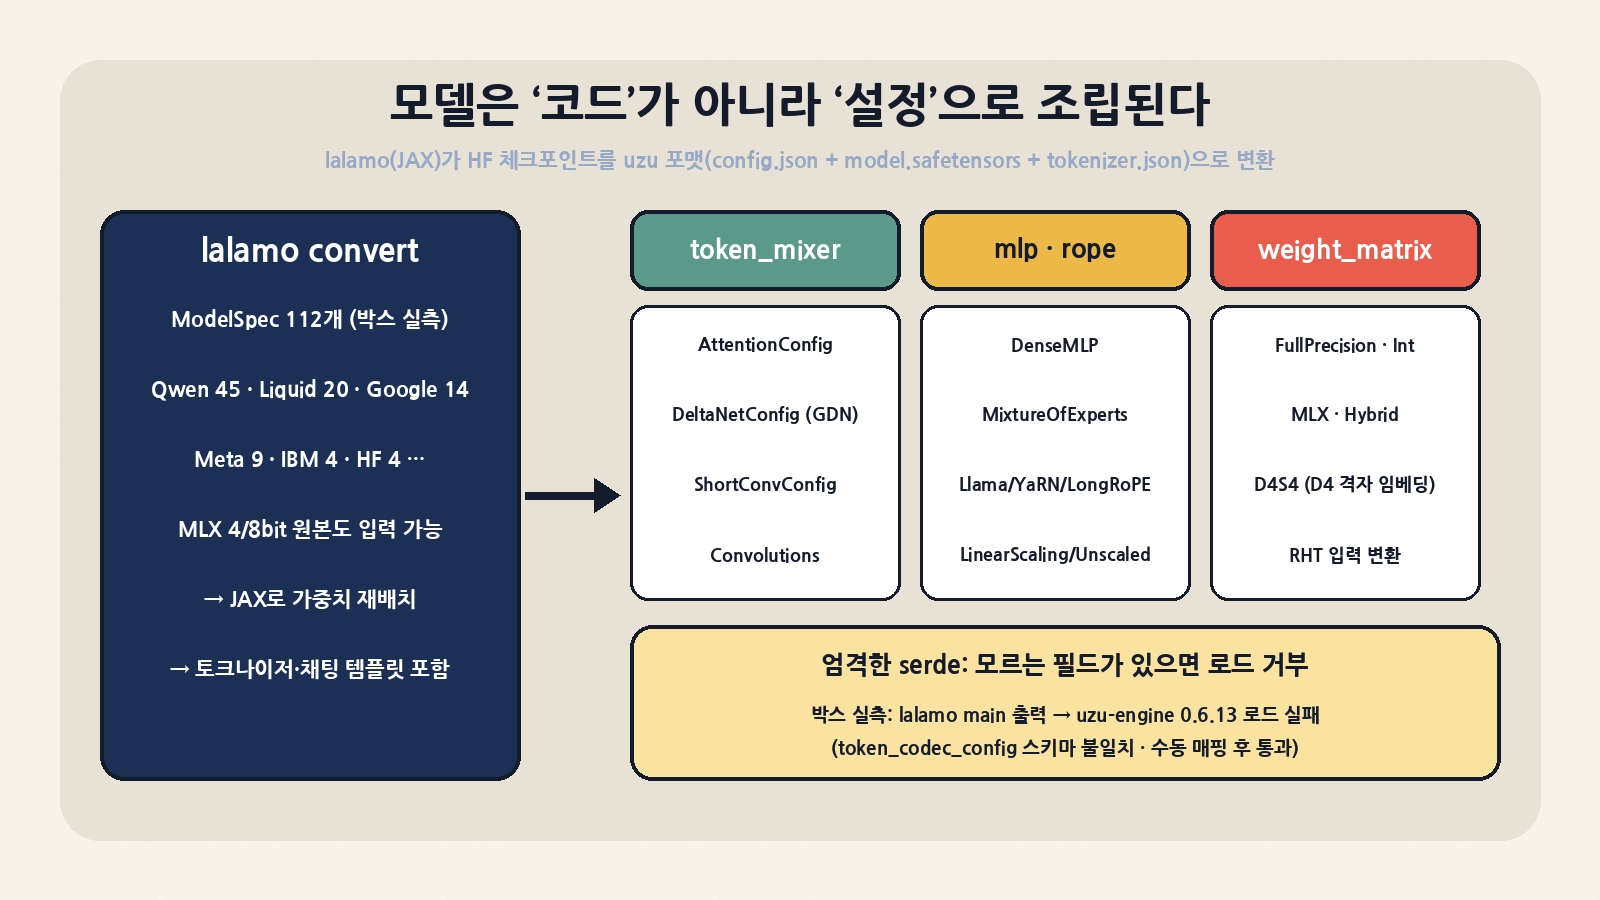
uzu는 자체 모델 포맷을 씁니다. 디렉터리에 config.json, model.safetensors, tokenizer.json 세 파일이 있고(투기 디코딩용 speculator/는 선택), 엔진은 load_language_model()에서 이 세 파일을 읽어 Decoder, Sampling, 선택적 DFlashTfmSpeculator를 만듭니다. 로드 마지막에 weight_loader.assert_all_tensors_read()로 읽히지 않은 텐서가 남아 있으면 실패시키는 점이 인상적입니다. 설정과 가중치가 어긋난 변환본을 조용히 돌리는 일을 막는 장치입니다.
config.json은 레이어 단위로 구성 요소를 선언합니다. 예컨대 박스에서 변환한 Qwen3-0.6B는 28개 레이어 모두 AttentionConfig + DenseMLPConfig + UnscaledRoPEConfig, TiedEmbeddingConfig, model_dim 1024 / hidden_dim 3072 / vocab 151,936으로 기술됩니다. 같은 스키마로 하이브리드 모델(Attention과 DeltaNet 혼합)이나 MoE도 표현합니다.
| 설정 축 | 지원 변형 (src/config 기준) | 의미 |
|---|---|---|
| token_mixer | Attention, DeltaNet, ShortConv, Convolutions | Qwen3.5 계열의 Gated DeltaNet, Liquid LFM 계열의 short conv 같은 비-어텐션 믹서까지 1급 지원 |
| mlp | DenseMLP, MixtureOfExperts(+ routing_function) | Qwen3.5-35B-A3B 같은 MoE 체크포인트 대응 |
| rope | Llama, YaRN, LongRoPE, LinearScaling, Unscaled | 컨텍스트 확장 방식별 구현을 분리 |
| weight_matrix | FullPrecision, Int, MLX, Hybrid, D4S4 | MLX 4/8bit 양자화 원본을 그대로 받는 경로와, D4 격자 코드(4열당 1코드, 64열당 스케일)로 임베딩을 압축하는 D4S4 |
| linear | matmul, input RHT, rht_wrapper, untied_readout | 입력 측 무작위 하다마드 변환(RHT)으로 양자화 오차를 펴는 기법을 블록으로 제공 |
| 기타 | per_layer_embedding, classifier 모델, embedding soft-cap/scale | Gemma 계열의 PLE, 분류 모델까지 같은 엔진으로 처리 |
이 설정을 만드는 것이 lalamo(JAX 기반 변환 도구)입니다. uv run lalamo list-models를 박스에서 돌리면 ModelSpec 112개가 나왔고, 벤더별로는 Alibaba(Qwen) 45, Liquid 20, Google 14, Meta 9, IBM 4, Hugging Face 4 순이었습니다. Qwen3.8-27B, Qwen3.6-35B-A3B, GPT-OSS-20B, Devstral, 1비트 Bonsai-4B 같은 항목도 목록에 있습니다.
내부 동작 2: 커널은 빌드 타임에 생성된다
crates/uzu-engine/build/main.rs가 백엔드별 코드 생성을 맡습니다. 대상 OS가 macOS/iOS 계열이고 metal feature가 켜져 있으면 backend="metal" cfg를 세우고 .metal 커널을 컴파일합니다(Xcode Metal toolchain 필요). webgpu feature는 Slang 셰이더를 naga로 WGSL에 맞춰 넣는 경로이고, CPU는 Rust 함수 시그니처를 파싱해 같은 커널 인터페이스를 생성합니다. 덕분에 상위 블록 코드는 B: Backend 제네릭 하나로 세 백엔드를 공유합니다.
런타임에서는 select_backend()가 컴파일된 백엔드 중 우선순위(metal → webgpu → cpu)로 고르고, UZU_BACKEND 환경변수로 강제할 수 있습니다(코드 주석에 “TODO: remove magic env var”라고 되어 있어 바뀔 수 있는 인터페이스입니다). Metal 쪽 커널 디렉터리에는 attention single/two-pass, int8 KV, gemm/gemv, GDN(gated delta net), hadamard_transform, radix top-k, weaver 전용 커널이 분리되어 있습니다.
| 백엔드 | 현재 상태 | 타깃(README) |
|---|---|---|
| Metal | 주력. 통합 메모리 활용, 커널 벤치(Criterion) 그룹 제공 | aarch64-apple-darwin/ios/ios-macabi/ios-sim, x86_64-apple-darwin |
| WebGPU | 10월 28일 “WebGPU runtime” 머지. Slang 기반 | wasm32-unknown-unknown, wasm32-wasip1-threads (in progress) |
| CPU | 기본 feature에 포함. 정확성 기준 경로 성격 | x86_64/aarch64 Linux, Windows (in progress) |
내부 동작 3: DFlash + Weaver 트리형 투기 디코딩
투기 디코딩(speculative decoding)은 작은 드래프트가 여러 토큰을 미리 제안하고 큰 모델이 한 번에 검증해 수락하는 기법입니다. uzu는 여기서 한 단계 더 나아가 후보를 한 줄이 아니라 트리로 만듭니다. 코드 흐름은 다음과 같습니다.
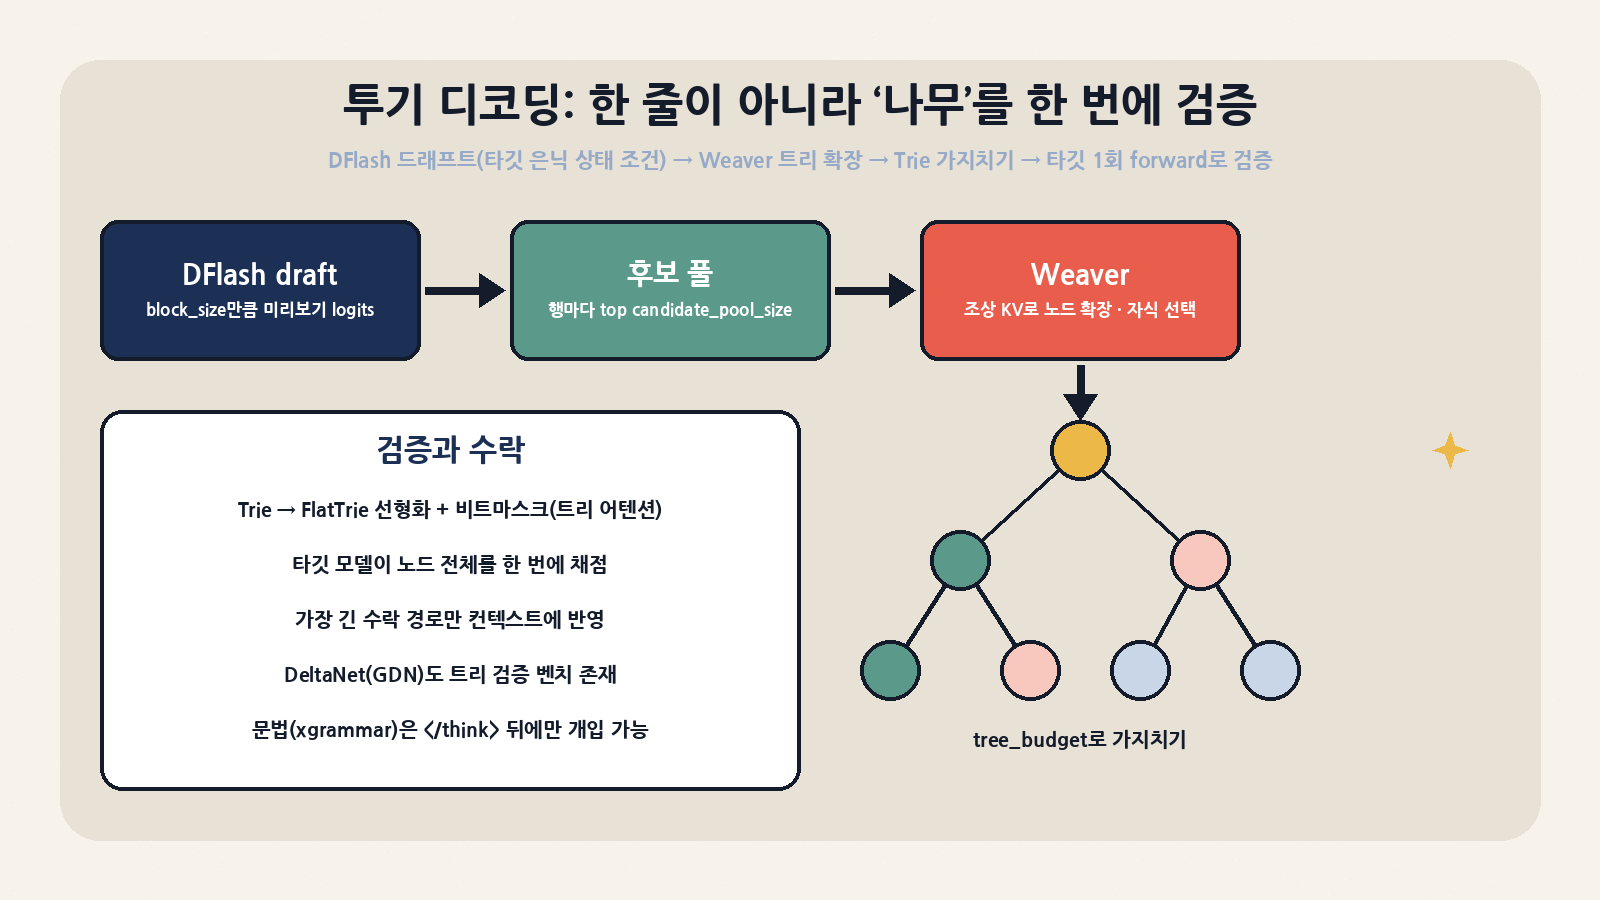
- DFlash 드래프트:
DFlashDraftConfig에target_layer_ids,block_size,mask_token_id가 있습니다. 타깃 모델의 특정 레이어 은닉 상태를 컨텍스트로 받아 블록 단위로 미리보기 logits를 냅니다. - 후보 풀: 미리보기 행마다 상위
candidate_pool_size개 토큰을 뽑아 풀을 만듭니다(radix_top_k_small커널). - Weaver: 작은 트랜스포머(
WeaverConfig: num_layers, max_depth, candidate_pool_size)가 노드를 확장합니다. 주석 그대로 “배치 토큰을 임베딩하고, 모든 레이어를 prefix KV와 각 노드의 조상(ancestors)에 대해 돌린 뒤 자식을 고른다”는 방식이고, 이를 위해AncestorAttentionKernel이 따로 있습니다. 선택 모드는 Children/Frontier/Fused 세 가지입니다. - Trie 가지치기·선형화:
TrieNode::prune_to_budget()이 로그확률 기준으로tree_budget까지 자르고,linearize()가 GPU용FlatTrie와 비트마스크(트리 어텐션 마스크)를 만듭니다. - 검증: 타깃 모델이 트리 전체를 한 번의 forward로 채점하고 가장 긴 수락 경로만 상태에 반영합니다. 단위 테스트 폴더에
delta_net_tree_verify_bench.rs가 있어, 순환 상태를 가진 DeltaNet 레이어에서도 트리 검증을 다룬다는 점이 눈에 띕니다.
구조화 출력은 xgrammar로 처리하고, grammar/engagement.rs에 Always/Triggered 두 모드가 있습니다. Triggered는 추론 모델의 end-of-thinking 태그(예: </think>)가 나올 때까지 문법을 잠재우고, 최종 답변에만 제약을 겁니다. “생각은 자유롭게, 답은 JSON 스키마대로”를 엔진 수준에서 보장하는 설계입니다. 투기 디코딩의 롤백과 맞물리도록 토큰마다 매칭 상태를 쌓아 두는 점도 실무적으로 중요합니다.
설치와 실행: 실제로 쓰는 명령
| 목적 | 명령 | 비고 |
|---|---|---|
| Python SDK | uv add uzu==0.6.13 |
macOS wheel만 존재 (Linux에서는 설치 불가) |
| TypeScript SDK | pnpm add @trymirai/uzu@0.6.13 |
npm 메타데이터 os: darwin |
| Swift | .package(url: "https://github.com/trymirai/uzu.git", from: "0.6.13") |
iOS는 Increased Memory Capability entitlement 권장(README) |
| Rust | uzu = { git = "https://github.com/trymirai/uzu", branch = "main", package = "uzu" } |
main 브랜치 추적이므로 커밋 고정 권장 |
| 대화형 CLI | cargo run --release -p cli -- --model trymirai/Qwen3.5-4B-M |
모델이 없으면 자동 다운로드 |
| OpenAI 호환 서버 | cargo run --release -p cli -- server --model trymirai/Qwen3.5-4B-M --port 8080 |
기본 127.0.0.1:8000, stream/temperature/top_p/top_k/max_tokens 지원 |
| 벤치 | cargo run --release -p cli -- bench {MODEL_PATH} {TASK_PATH} {OUTPUT_PATH} |
비교 엔진은 scripts/benchmarks |
| 모델 변환 | uv run lalamo convert meta-llama/Llama-3.2-1B-Instruct |
CPU에서 XLA 오류 시 JAX_DISABLE_JIT=1 |
| 개발 환경 | cargo tools setup / cargo tools example python chat |
rustup·uv·pnpm·타깃·Metal toolchain 일괄 설치 |
SDK 쪽 모델 식별자는 alibaba:qwen3.5:0.8b:mirai:mirai-m:4 형식입니다. 벤더:패밀리:크기:양자화 주체:방식:비트로 읽히며, Pi 확장 README가 “Mirai Medium Quantization”을 언급하는 것으로 보아 mirai-m은 Mirai 자체 중간 강도 양자화로 추정됩니다(공식 문서에 명시된 정의는 확인하지 못했습니다). 같은 Engine에 with_openai_api_key()를 주면 gpt-5 같은 클라우드 모델도 동일한 ChatSession API로 호출합니다. 로컬과 클라우드를 한 인터페이스로 묶는 라우팅 계층을 노린 설계입니다.
박스 스모크 테스트: Linux에서 CPU로 실제 생성까지
공식 지원은 Apple Silicon뿐이지만, 엔진이 CPU 백엔드를 기본 feature로 갖고 있으므로 Linux x86_64(8 vCPU를 여러 작업이 나눠 쓰는 공유 박스)에서 어디까지 되는지 확인했습니다. 아래 수치는 모두 직접 실행해서 본 값이며, 성능 비교용이 아니라 동작 확인용입니다.
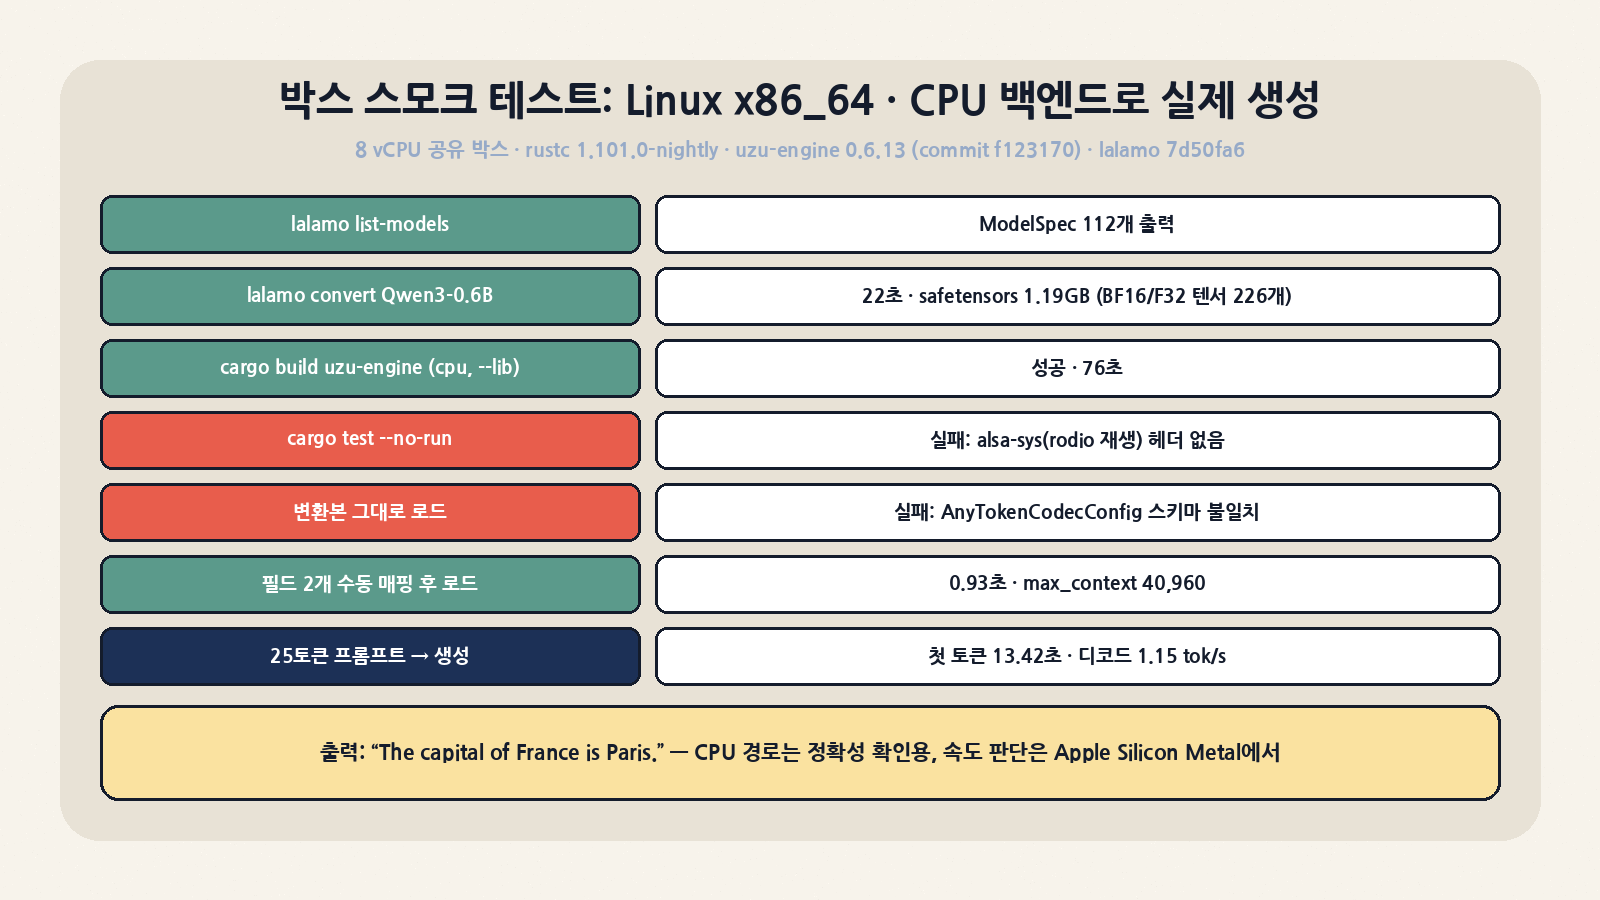
| 단계 | 명령/조건 | 관찰 결과 |
|---|---|---|
| 1. 모델 목록 | uv run lalamo list-models (lalamo 7d50fa6) |
ModelSpec 112개 출력, 종료 코드 0 |
| 2. 변환 | JAX_DISABLE_JIT=1 uv run lalamo convert Qwen/Qwen3-0.6B |
22초 만에 완료. model.safetensors 1,192,276,800바이트, 텐서 226개(BF16 113 · F32 113), tokenizer.json 11.4MB |
| 3. 엔진 빌드 | cargo build -p uzu-engine --no-default-features --features cpu --lib (rustc 1.101.0-nightly) |
성공, 76초 |
| 4. 테스트 빌드 | cargo test -p uzu-engine ... --no-run |
실패: dev-dependency인 legacy uzu → rodio → alsa-sys가 ALSA 헤더를 요구. 헤드리스 서버 CI라면 libasound 개발 패키지가 필요 |
| 5. 변환본 로드 | uzu-engine 0.6.13 + lalamo main 출력 그대로 | 실패: data did not match any variant of untagged enum AnyTokenCodecConfig. lalamo는 response_format 객체를 쓰고, 엔진은 output_parser_regex·end_of_thinking_tag를 기대 |
| 6. 수동 매핑 후 로드 | response_format.reasoning_pattern→output_parser_regex, end_of_thinking_tag="</think>" |
로드 0.93초, max_context_length=40960, speculation_supported=true(speculator 디렉터리는 없음) |
| 7. 생성 | 25토큰 프롬프트, 기본 샘플링(설정의 temperature 0.6/top_k 20/top_p 0.95), seed 42 | 첫 토큰 13.42초, 8토큰 생성, 디코드 1.15 tok/s, 출력 “The capital of France is Paris.” |
테스트용 바이너리는 공개 API인 select_backend() + BackendSelection 트레이트로 작성했습니다(backends::cpu 모듈은 pub(crate)라 직접 지정할 수 없습니다). 결론은 세 가지입니다. 첫째, 엔진 코어는 Linux CPU에서 빌드되고 수치적으로 맞는 답을 냅니다. 둘째, CPU 경로는 0.6B 모델에서도 체감 속도가 나오지 않아, 현재로서는 정확성 기준(reference) 용도로 보는 것이 맞습니다. 셋째, lalamo main과 uzu main의 포맷이 항상 같이 움직이지는 않습니다. 직접 변환한 모델을 쓸 계획이라면 두 저장소의 커밋을 짝지어 고정하거나, Mirai 레지스트리가 배포하는 변환본을 쓰는 편이 안전합니다.
어떻게 평가할 것인가
저장소에는 벤치 결과표가 아니라 벤치 하네스가 들어 있습니다. 각 엔진 어댑터가 모델을 한 번 올린 뒤 stdin으로 요청을 받아 생성 텍스트, 타이밍, 처리량, 프로세스 메모리를 JSON Lines로 내보내는 구조라, 같은 기기·같은 체크포인트로 직접 비교하기 좋습니다. 실무 평가는 다음 순서를 권합니다.
| 평가 항목 | 방법 | 판단 기준 |
|---|---|---|
| 처리량·지연 | scripts/benchmarks로 llama.cpp(GGUF Q4_K_M)·MLX(4bit)·uzu를 같은 Qwen 체크포인트로 비교. ML Drift 비교는 compare/uzu_mldrift.py --bits 4 |
첫 토큰 지연(TTFT), 디코드 tok/s, 피크 메모리 |
| 투기 디코딩 효과 | speculator 포함 모델과 미포함 모델로 같은 프롬프트 반복. 스트림 메트릭의 제안/수락 토큰 수(num_tokens_proposed/num_tokens_accepted) 확인 |
코드/구조화 출력처럼 예측 가능한 작업에서 이득이 큰지 |
| 품질 동등성 | 같은 시드·greedy로 원본(HF) 대비 출력 비교. README의 “traceable computations” 취지 | 양자화 방식(MLX/Int/Hybrid)별 품질 저하 폭 |
| 구조화 출력 | chat-structured-output 예제에 사내 스키마 적용, reasoning 모델에서 Triggered 모드 확인 |
스키마 위반 0건, 추론 품질 유지 |
| 메모리 안정성 | iOS 실기기에서 세션 하나 유지·해제 반복 | README 권고(동시에 한 세션만)를 지켰을 때 jetsam 없이 버티는지 |
비슷한 도구와 비교
| 항목 | uzu | llama.cpp | MLX / mlx-lm | Ollama | ML Drift |
|---|---|---|---|---|---|
| 주 사용 형태 | 앱 내장 SDK (Swift/Py/TS/Rust) | C/C++ 라이브러리 + CLI/서버 | Python 배열 프레임워크 + LLM 도구 | 로컬 데몬 + REST API | Google의 온디바이스 GPU 추론 런타임 |
| 강한 플랫폼 | Apple Silicon(Metal) | 사실상 전 플랫폼(CPU/CUDA/Metal/Vulkan 등) | Apple Silicon | macOS/Linux/Windows | 모바일·엣지 GPU |
| 모델 포맷 | 자체 포맷(lalamo 변환) | GGUF | safetensors(MLX 양자화) | GGUF 기반 | 자체 변환(벤치 README상 Q4_0 추출) |
| 투기 디코딩 | DFlash + Weaver 트리, Trie 검증 | 드래프트 모델·DFlash 지원(벤치 README) | mlx-serve 등 주변 도구에서 MTP/DFlash | 엔진(llama.cpp) 의존 | 벤치 어댑터상 greedy만, 투기 깊이 거부 |
| 구조화 출력 | xgrammar 내장, 추론 후 트리거 | GBNF 문법 | 외부 라이브러리 조합 | JSON 모드/스키마 | 해당 어댑터에서는 도구 호출 거부 |
| 라이선스 | MIT | MIT | MIT | MIT | 저장소 라이선스 별도 확인 필요 |
| 성숙도 | 0.6.x, SDK 계층 재작성 예고 | 매우 높음 | 높음 | 높음 | 초기 |
정리하면, “Mac/iPhone 앱 안에 모델을 넣고, 클라우드 모델과 같은 API로 섞어 쓰고 싶다”면 uzu가 가장 직접적인 선택지입니다. 반대로 서버 GPU, Linux/Windows 배포, 커뮤니티 생태계(GGUF 모델 풀)가 우선이라면 llama.cpp/Ollama가 여전히 안전합니다. MLX는 연구·실험 생산성에서, uzu는 제품 내장과 투기 디코딩 엔진 통합에서 장점이 갈립니다.
주의사항: 라이선스, 보안, 운영 리스크
| 리스크 | 근거 | 대응 |
|---|---|---|
| 네트워크 의존 카탈로그 | Mirai 레지스트리(https://sdk.trymirai.com/api/v1)의 fetch/models 요청에 os_name, cpu_name, memory_total, 백엔드 목록이 실림. 테스트 코드가 “로컬 경로는 포함하지 않음”을 단언 |
프롬프트가 아니라 기기 메타데이터지만, 폐쇄망·규제 환경이면 LOCAL_PATH 로컬 모델 경로로 고정 |
| Metal 확장의 비공개 셀렉터 조회 | device_extensions.rs가 obfstr!로 감싼 gpuCoreCount, supportsMXU 셀렉터 값을 선택적으로 조회 |
App Store 배포 전 앱 심사 정책 관점에서 자체 검토 |
| 빠른 변경 속도 | 10월에만 릴리스 10개(0.6.0~0.6.13), 최근 릴리스 노트 본문 비어 있음, Rust 의존성은 branch = "main" 예시 |
커밋/태그 고정, lalamo 버전과 짝 맞추기, 업그레이드마다 회귀 테스트 |
| 설정 스키마 엄격성 | deny_unknown_fields + untagged enum → 필드 하나 차이로 로드 실패(박스에서 실제 재현) |
변환 파이프라인을 CI에 넣고 엔진 로드까지 자동 검증 |
| 플랫폼 한계 | PyPI/npm 패키지는 macOS 전용, Linux/Windows/wasm 타깃은 in progress | 크로스플랫폼 제품이면 당분간 다른 런타임과 병행 |
| 툴체인 부담 | nightly 고정 + 다수 타깃 선언, Metal toolchain, git 의존성(wgpu v30 브랜치, slang-rs 포크) | 빌드 컨테이너/캐시를 별도로 준비, 공급망 검토 시 git 의존성 목록 확인 |
| 라이선스 | uzu·lalamo 모두 MIT. 단 변환 대상 모델 가중치는 각자 라이선스(Llama, Gemma, Qwen 등)를 따름 | 배포 앱에 넣을 모델별 라이선스·사용 정책 별도 검토 |
정리
uzu에서 눈여겨볼 지점은 “빠르다”는 주장보다 엔진의 짜임새입니다. 설정 주도 블록 조립, 엄격한 스키마와 텐서 전량 소비 검사, 빌드 타임 커널 생성으로 묶은 Metal·WebGPU·CPU 백엔드, 그리고 DFlash 드래프트와 Weaver 트리 확장, Trie 검증까지 이어지는 투기 디코딩 파이프라인이 한 코드베이스 안에 정리되어 있습니다. 박스 실측에서는 Linux CPU에서도 변환→로드→생성이 동작했지만, 변환 도구와 엔진의 스키마가 어긋나는 현실적인 문제도 함께 드러났습니다. Apple 플랫폼용 제품을 만드는 팀이라면 지금 PoC를 시작할 만하고, 그 밖의 플랫폼이라면 WebGPU 런타임이 안정화되는 시점을 지켜보는 것이 합리적입니다.