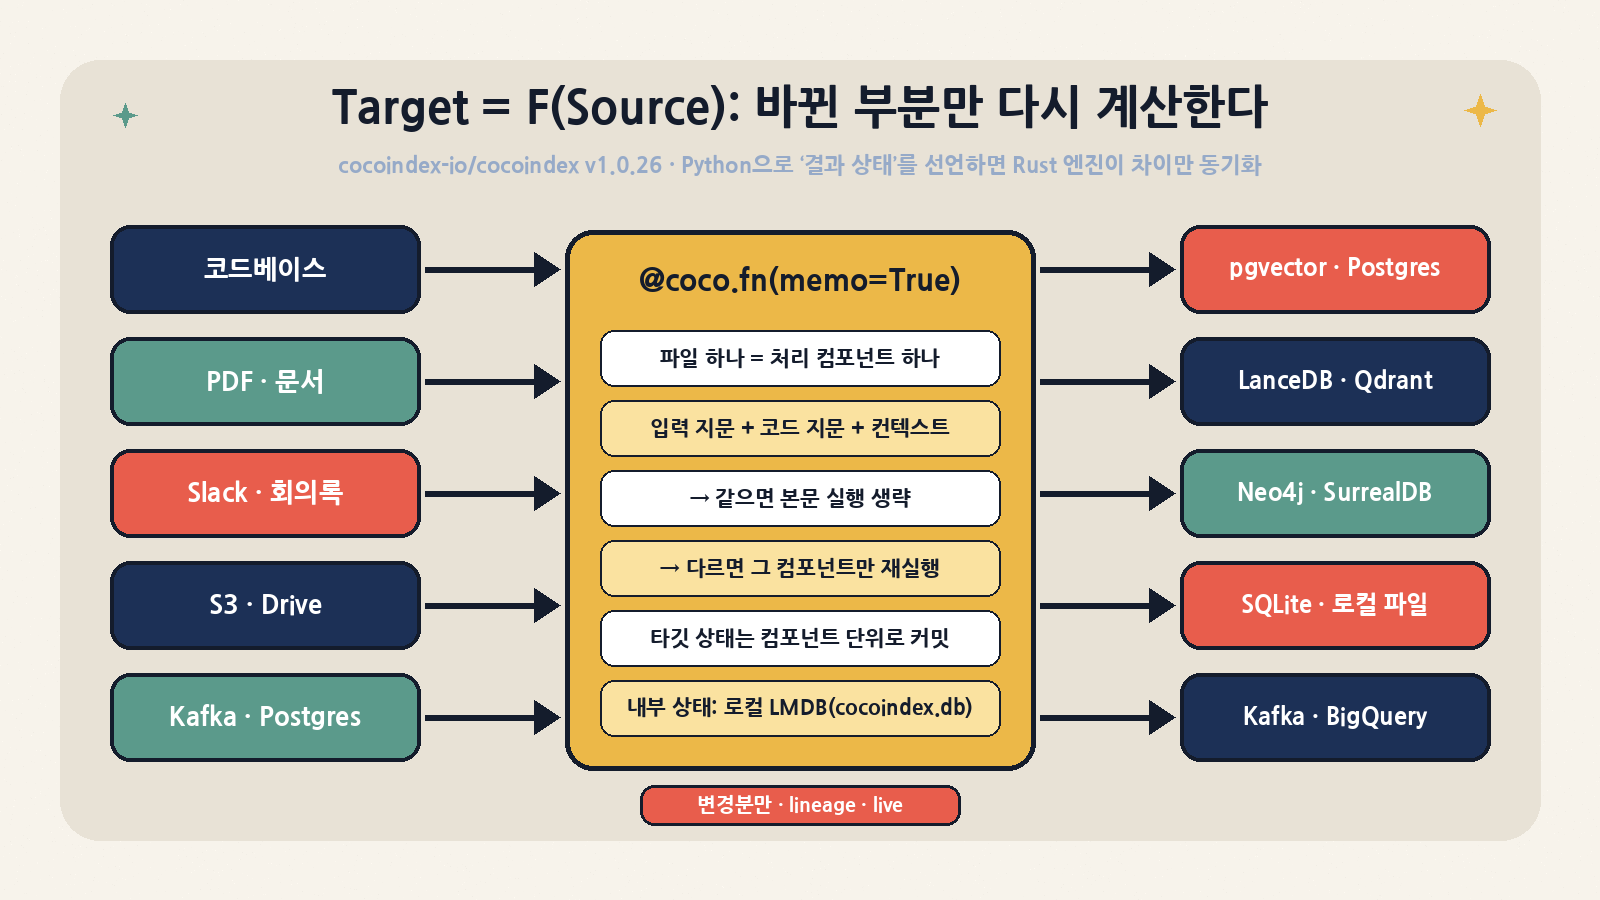
한 줄 요약: cocoindex-io/cocoindex는 RAG 인덱스, 에이전트 메모리, 지식 그래프처럼 원본에서 파생되는 데이터를 원본이나 코드가 바뀔 때마다 바뀐 부분만 다시 계산해 타깃에 반영하는 증분(incremental) 데이터 엔진입니다. 사용자는 Python으로 “타깃이 어떤 상태여야 하는가”(Target = F(Source))만 선언하고, 무엇이 바뀌었는지 찾아내는 일, 무엇을 넣고 지울지 계산하는 일, 무엇을 캐시할지 정하는 일은 Rust 엔진이 맡습니다. 2026-10-29 GitHub Trending Rust 일간 9위, GitHub API 기준 스타 11,781개, 최신 릴리스 v1.0.26, 라이선스 Apache-2.0입니다. 박스에서 pip install부터 증분·라이브 모드·코어 테스트(636 passed)까지 직접 돌려 봤습니다.
1. 지금 어떤 상태의 프로젝트인가
CocoIndex는 2026-04-22(KST)에 v1.0.0을 내면서 API를 처음부터 다시 설계했습니다. 저장소의 AGENTS.md는 v1을 v0과 “근본적으로 다른 재설계(fundamental redesign)”라고 설명하고, 옛 코드는 v0 브랜치에 따로 남겨 두었습니다. 그 뒤 반년 동안 v1.0.26까지 패치 릴리스가 26번 나왔고, 최근 커밋도 엔진 스케줄링·성능 쪽(“in-flight pool을 라이브 컴포넌트끼리 공평하게 나누기”, 10-28)입니다. 겉으로는 “RAG 프레임워크”처럼 보이지만, 실제 개발 무게는 증분 실행 엔진에 실려 있습니다.
| 항목 | 값 (2026-10-29 17시경 KST 확인) | 비고 |
|---|---|---|
| 저장소 | cocoindex-io/cocoindex | 저장소 생성 2025-03-04 (KST) |
| Stars / Forks | 11,781 / 923 (GitHub API) | Trending Rust 일간 9위, 표기상 오늘 +5 |
| 최신 버전 | v1.0.26 (2026-10-22 14:15 KST), PyPI 1.0.26 | 직전 v1.0.25는 10-06 14:50 KST |
| v1 첫 정식 릴리스 | v1.0.0 (2026-04-22 15:31 KST) | v0 계열 마지막 태그는 v0.3.39 (04-29) |
| 라이선스 | Apache-2.0 | 휠에 THIRD_PARTY_NOTICES.html 포함 |
| Python 요구 버전 | requires-python = ">=3.11" |
분류자는 3.11~3.14, Free Threading “2 – Beta”. README 배지는 “3.10–3.13”으로 표기가 엇갈림 |
| 규모(실측) | 추적 파일 1,233개 · Python 파일 320개 · Rust 파일 270개 | python/ 약 9.6만 줄, rust/ 약 10.1만 줄 (테스트 포함) |
| 커넥터 / 예제 | Python 커넥터 디렉터리 20개 · examples 디렉터리 38개(+rust) | Postgres, LanceDB, Qdrant, Neo4j, Kafka, S3, Google Drive 등 |
| 열린 이슈+PR | 113 (API open_issues_count) | GitHub API 값은 PR을 포함함 |
2. 무엇을 해결하려는가: “전체 재색인”이라는 비용
문서 1만 개짜리 RAG 인덱스를 생각해 봅시다. 파일 하나가 바뀌었다고 1만 개를 다시 청크로 나누고 다시 임베딩하면 비용도 시간도 아깝습니다. 그렇다고 직접 증분 처리를 짜면 문서(core concepts)가 꼽는 네 가지 문제를 혼자 떠안게 됩니다.
- 무엇이 바뀌었고 무엇이 그대로인지 판별하기
- 시간 축으로 생각하며 “델타”를 계산하기(어떤 행을 넣고, 고치고, 지울지)
- 전체 재계산을 피하려고 중간 상태를 보관하기
- 코드 로직이 바뀌면 타깃 스키마를 바꾸고 백필하기
CocoIndex의 답은 React, 스프레드시트, materialized view의 사고방식을 부수 효과가 있는 장기 실행 파이프라인에 가져오는 것입니다. 타깃 상태는 소스 상태의 순수 함수(TargetState = Transform(SourceState))로 선언하고, 그 선언과 실제 외부 시스템(Postgres, 벡터 DB, 파일 시스템 등) 사이의 차이는 엔진이 맞춥니다. 핵심은 원본(데이터)이 바뀔 때뿐 아니라 코드가 바뀔 때도 영향받는 부분만 다시 돈다는 점입니다.
3. v1의 프로그래밍 모델: App · 처리 컴포넌트 · 타깃 상태
README의 첫 예제가 v1 모델을 거의 다 보여 줍니다.
import cocoindex as coco
from cocoindex.connectors import localfs, postgres
from cocoindex.ops.text import RecursiveSplitter

@coco.fn(memo=True)                          # ← hash(input) + hash(code)로 캐시
async def index_file(file, table):
    for chunk in RecursiveSplitter().split(await file.read_text()):
        table.declare_row(text=chunk.text, embedding=embed(chunk.text))

@coco.fn
async def main(src):
    table = await postgres.mount_table_target(PG, table_name="docs")
    table.declare_vector_index(column="embedding")
    await coco.mount_each(index_file, localfs.walk_dir(src).items(), table)

coco.App(coco.AppConfig(name="docs"), main, src="./docs").update_blocking()- App: 최상위 실행 단위입니다. 소스를 읽고, 변환하고, 타깃 상태를 선언합니다.
- 처리 컴포넌트(processing component):
mount_each가 항목(여기서는 파일)마다 하나씩 만듭니다. 컴포넌트는 서로 독립적으로 돌고, 끝나는 대로 자기 타깃 상태를 외부 시스템에 반영합니다. 앱 전체가 끝날 때까지 기다리지 않습니다. - 타깃 상태:
declare_row,declare_file처럼 “이 행/파일이 있어야 한다”는 선언입니다. 파일이 줄어 청크가 3개에서 1개가 되면, 엔진이 사라진 2개를 지우고 새 1개를 넣는 작업을 한 단위로 처리합니다.
v0을 써 봤다면 머릿속을 통째로 바꿔야 합니다. 저장소에 들어 있는 에이전트용 스킬 문서(skills/cocoindex/SKILL.md)는 “v0 코드는 학습 데이터에서 배웠을 가능성이 높으니 내보내지 말라”고 못 박고 다음 대응표를 줍니다.
| v0 (제거됨) | v1 대응 | 실무 의미 |
|---|---|---|
@cocoindex.flow_def, FlowBuilder, Flow |
coco.App + @coco.fn main 함수 |
DSL 그래프 대신 평범한 Python 제어 흐름 |
DataScope, add_collector(), collect(), export() |
마운트된 컴포넌트 안에서 declare_row/declare_file |
수집기 대신 타깃 상태 선언 |
cocoindex.sources.* |
커넥터 API (예: localfs.walk_dir) |
소스·타깃이 커넥터 모듈로 통합 |
cocoindex.functions.SplitRecursively |
cocoindex.ops.text.RecursiveSplitter |
연산은 ops 아래로 |
cocoindex.init(), COCOINDEX_DATABASE_URL |
앱 설정 + 로컬 db 경로 | 내부 상태 저장에 Postgres가 더 이상 필수가 아님 |
CLI cocoindex setup |
setup 단계 없음, cocoindex update (-L 라이브) |
배포 스크립트 단순화 |
인터넷의 CocoIndex 튜토리얼이나 블로그 글 상당수가 v0 API 기준이라는 점을 꼭 기억하세요. 코딩 에이전트에게 맡길 때는 저장소의 skills/cocoindex/를 컨텍스트로 넣어 주는 편이 안전합니다.
4. 증분의 핵심: 메모이제이션과 세 가지 지문
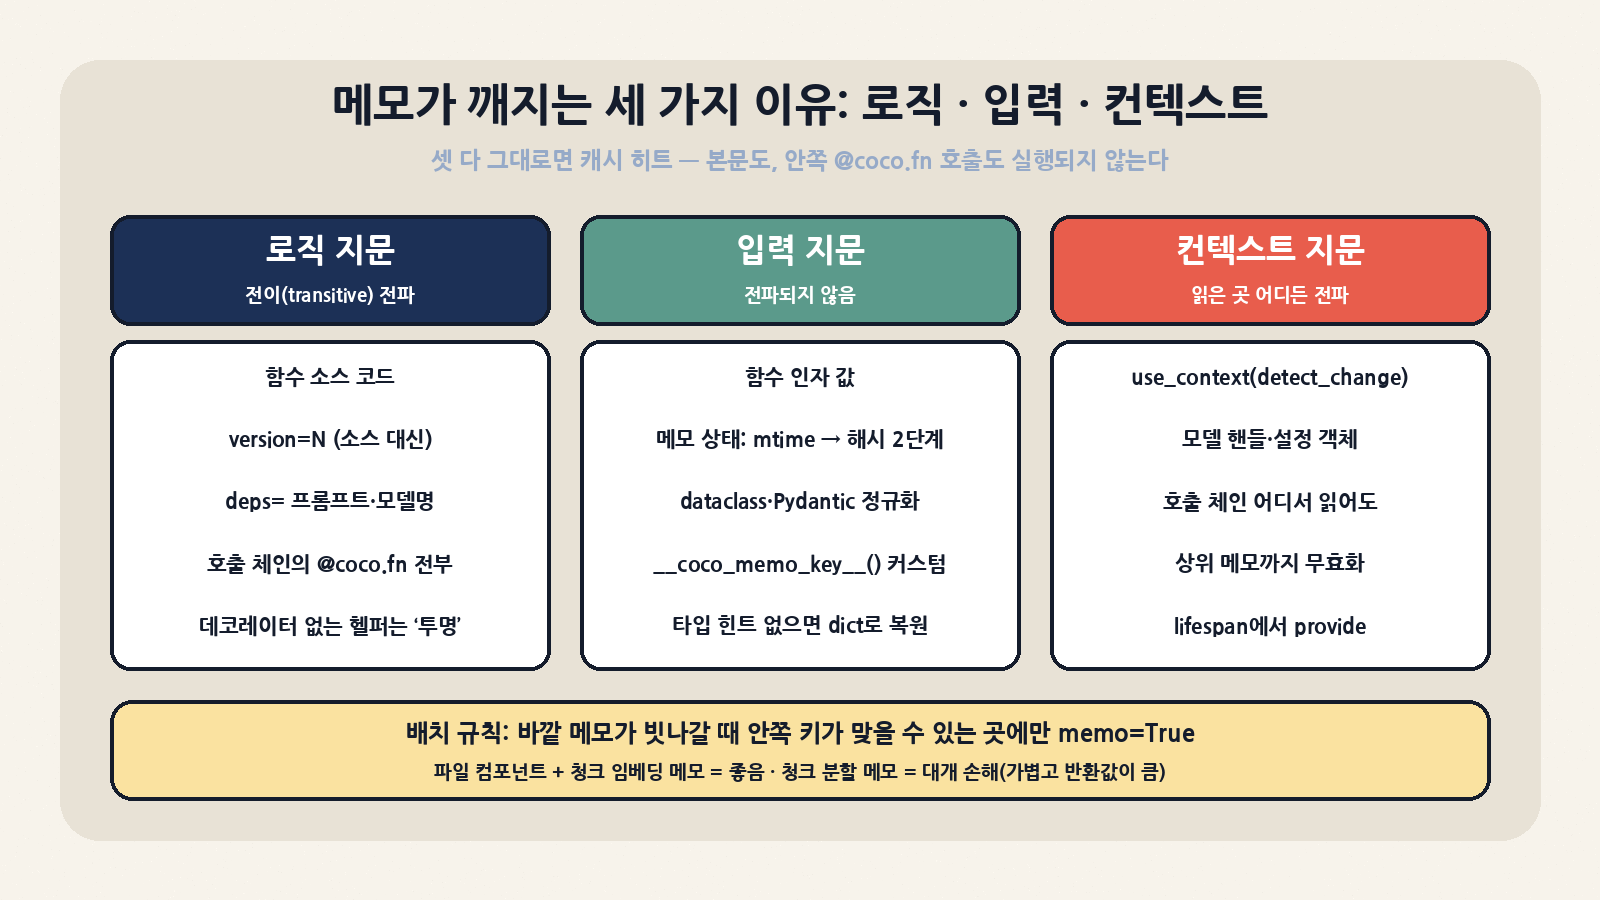
@coco.fn은 함수 시그니처를 바꾸지 않는 데코레이터입니다. 하지만 이 데코레이터를 붙인 함수는 변경 감지 시스템에 들어가고, memo=True를 주면 결과가 캐시됩니다. 캐시가 맞으면(hit) 함수 본문은 물론 본문 안의 @coco.fn 호출도 실행되지 않고, 이전 반환값과 이전에 선언한 타깃 상태가 그대로 재사용됩니다. 무효화 여부는 세 가지 지문으로 판단합니다.
| 지문 | 무엇으로 계산하나 | 전파 방식 | 함정 |
|---|---|---|---|
| 로직(logic) | 함수 소스 코드. version=N을 주면 소스 대신 그 정수. deps= 값(프롬프트, 모델명 등)도 포함 |
전이적: 실행 중 호출된 모든 @coco.fn의 로직이 바깥 메모에 기여 |
데코레이터 없는 헬퍼는 보이지 않음. 고쳐도 아무것도 무효화되지 않아 결과가 조용히 낡음 |
| 입력(input) | 함수 인자. __coco_memo_key__(), register_memo_key_function, memo_key=로 바꿀 수 있음 |
전파되지 않음 | 메모리 주소, 불안정한 UUID, datetime.now() 같은 값을 키에 넣지 말 것 |
| 컨텍스트(context) | use_context()로 읽은 값 가운데 detect_change=True인 것 |
호출 체인 어디서든 읽히면 바깥 메모까지 무효화 | 어디서 읽었는지가 아니라 읽었는지 여부가 기준 |
세밀한 제어 수단도 있습니다. logic_tracking="self"/None으로 로직이 위로 전파되는 범위를 끊을 수 있고, 호출마다 달라지는 의존성(예: 파일 언어별 파서)은 coco.LogicDep + use_logic_dep로 기록합니다. v1.0.26에는 라이브러리가 "self"로 감춰 버리는 사용자 콜백의 로직을 호출자 메모에 반영하는 coco.logic_propagated_to_callers(fn)가 들어갔습니다. 또 지문이 맞은 뒤 신선도를 한 번 더 확인하는 메모 상태 검증(__coco_memo_state__, MemoStateOutcome)이 있어서, 파일이라면 “mtime이 같으면 바로 재사용하고, 다르면 내용 해시로 다시 확인”하는 2단계 검사를 직접 짤 수 있습니다.
문서의 “한 가지 배치 규칙”은 운영 비용과 곧바로 이어지니 짚고 넘어가겠습니다. 메모는 바깥 메모가 모두 빗나갈 때 안쪽 키가 맞을 수 있는 경계에만 둡니다. 문서가 드는 예를 보면, 내용 해시로 키를 잡은 메모 컴포넌트 안에 임베딩 메모를 또 두면 1536차원 float32 벡터(약 6KB)를 청크 10만 개당 약 600MB씩 중복 저장하게 됩니다.
| 메모 대상 | 문서 판단 | 이유 |
|---|---|---|
| 임베딩 함수 | ✅ 좋음 | 계산이 무겁고, 반환값이 고정 크기이며 아주 크지 않음 |
| 고정 크기 청크 분할 | ❌ 대개 손해 | 계산은 가볍고 반환값이 클 수 있음 |
| 거의 바뀌지 않는 파일의 처리 컴포넌트 | ✅ 매우 유리 | 파일 읽기부터 통째로 건너뜀 |
| 파일 메모가 이미 있을 때의 청크 임베딩 | 🤔 상황에 따라 | 자주 바뀌는 파일, 자주 바뀌는 코드에서 효과가 커짐 |
| 내용 해시로 키를 잡은 메모 컴포넌트 안의 임베딩 | ❌ 대개 중복 | 바깥 메모가 이미 텍스트를 확정하므로, 벡터를 두 번 저장하게 됨 |
5. 아키텍처와 저장소 구조
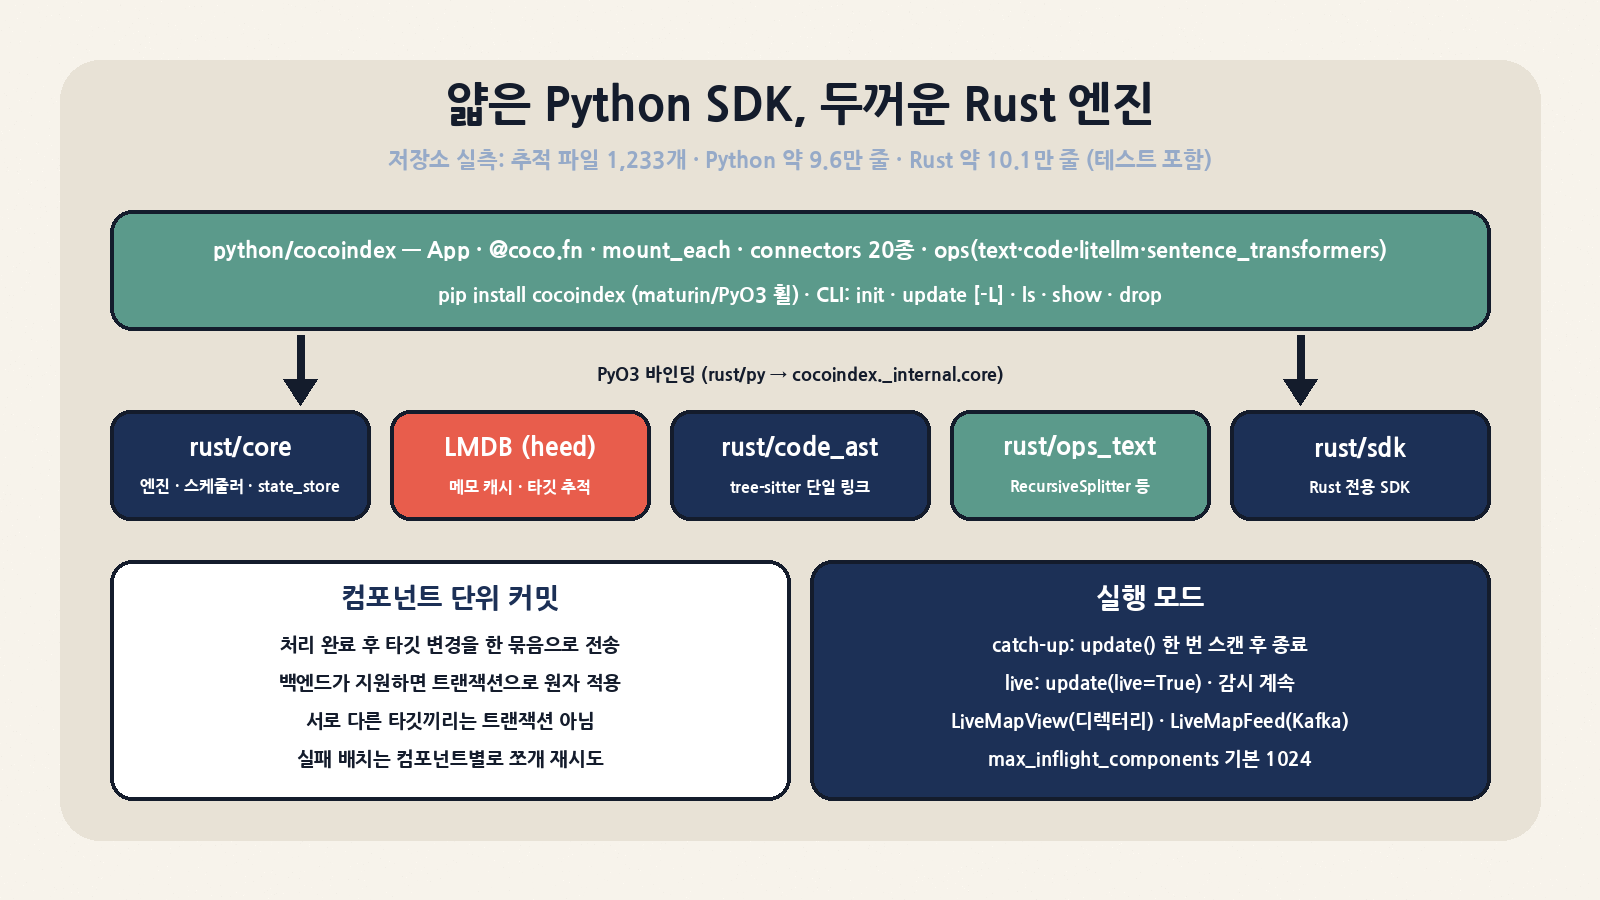
사용자가 보는 것은 Python SDK이고, 일은 Rust가 합니다. 휠은 maturin/PyO3로 빌드되며 Rust 쪽 rust/py 크레이트가 cocoindex._internal.core 모듈이 됩니다. 메모 캐시와 타깃 추적 같은 내부 상태는 heed 크레이트를 통해 로컬 LMDB(COCOINDEX_DB 또는 Settings.db_path)에 저장됩니다.
| 경로 | 역할 | 메모 |
|---|---|---|
python/cocoindex/ |
App, @coco.fn, 마운트 API, CLI(cli.py) |
CLI 명령: init, update, ls, show, drop |
python/cocoindex/connectors/ |
커넥터 20종 | amazon_s3, azure_blob, bigquery, doris, falkordb, google_drive, iggy, kafka, lancedb, localfs, neo4j, oci_object_storage, postgres, qdrant, snowflake, sqlite, surrealdb, turbopuffer, valkey, zvec |
python/cocoindex/ops/ |
text, code, litellm, sentence_transformers, entity_resolution | 무거운 의존성은 extras로 분리 ([litellm], [lancedb], [postgres] 등) |
rust/core |
엔진, 상태 저장소(state_store), 텔레메트리 | LMDB 맵은 꽉 차면 두 배로 늘려 재시도 |
rust/code_ast · rust/code_match |
tree-sitter 0.25 기반 코드 파싱 · regex/aho-corasick 기반 패턴 매칭 | code_ast는 워크스페이스에서 tree-sitter 문법을 링크하는 유일한 크레이트 |
rust/ops_text |
RecursiveSplitter, SeparatorSplitter | 문법을 아는(syntax-aware) 분할 |
rust/sdk |
Rust 전용 SDK | #[cocoindex::function(memo, batching)] 등 (v1.0.25) |
skills/cocoindex/ |
코딩 에이전트용 스킬 문서 | v1 API, 개념, 패턴을 파일 하나에 모음 |
LMDB 설정에서 알아 둘 기본값이 두 가지 있습니다. max_dbs는 하나의 db 경로를 함께 쓰는 앱 수의 절대 상한(기본 1024)이고, map_size는 시작 크기일 뿐 상한이 아닙니다(기본 4GiB). 맵이 커지는 순간에는 프로세스 안의 LMDB 트랜잭션이 모두 끝나야 하므로, 큰 앱에서 cocoindex show처럼 오래 스트리밍하는 읽기가 돌고 있으면 그만큼 기다립니다. 문서는 내부 저장소가 커지는 주범으로 메모 캐시, 그중에서도 큰 반환값을 꼽습니다.
6. 커밋 의미론과 실행 모드
정합성 측면에서 가장 중요한 문장은 FAQ에 있습니다. 처리 컴포넌트가 끝나면 그 컴포넌트의 타깃 변경을 각 백엔드에 한 묶음으로 보내고, 백엔드가 지원하면 원자적으로(예: DB 트랜잭션) 적용합니다. 백엔드가 묶음을 거부하면 컴포넌트별로 더 작게 쪼개 다시 시도하므로, 한 컴포넌트의 실패가 다른 컴포넌트의 변경을 되돌리지 않습니다. 하지만 서로 다른 타깃 백엔드끼리(예: Postgres와 로컬 파일)는 트랜잭션으로 묶이지 않습니다.
| 구분 | catch-up (기본) | live |
|---|---|---|
| 호출 | app.update() / cocoindex update app.py |
app.update(live=True) / cocoindex update -L app.py |
| 동작 | 소스 전체 스캔 → 바뀐 것만 처리 → 동기화 후 종료 | catch-up 후에도 남아 변경 스트림을 계속 반영 |
| 변경 발견 | 매 실행마다 스캔 비용이 듦 | LiveMapView(스캔 가능한 디렉터리·테이블) 또는 LiveMapFeed(Kafka처럼 스트림만 있는 소스) |
| 변경 감지가 없는 소스 | 그대로 스캔 | coco.auto_refresh(fn, interval=...)로 주기 재실행 |
| 동시성 | 앱당 동시에 도는 처리 컴포넌트 기본 1024개(max_inflight_components). v1.0.26부터 실행 중인 모든 컴포넌트에 적용되고, 부모가 자식에게 슬롯을 빌려줘 깊은 계층에서도 교착이 생기지 않음 |
|
| 오류 | ready()/update_full은 기본적으로 오류를 ERROR 로그로 남기고 넘어감(예외를 던지는 핸들러로 바꿀 수 있음). app.drop()은 어느 깊이에서든 실패하면 예외를 던짐(타깃에 데이터가 남는 누수를 막기 위해) |
|
7. 박스 스모크 테스트: 임베딩 호출 수를 세어 봤다
API 키도 외부 DB도 없이 증분 동작을 확인하려고 최소 파이프라인을 짰습니다. localfs.walk_dir(*.md) → 파일마다 @coco.fn(memo=True) 컴포넌트 → RecursiveSplitter(chunk_size=200) → 가짜 임베딩 함수(@coco.fn(memo=True, version=N), 실제로 실행될 때마다 로그 기록) → SQLite 타깃입니다. 진짜 임베딩 대신 SHA-256 앞자리를 썼으므로 속도 수치는 의미가 없고, 보는 것은 “몇 번 다시 계산했나”뿐입니다. 텔레메트리는 COCOINDEX_DISABLE_USAGE_TRACKING=1로 껐습니다.
python3 -m venv venv && venv/bin/pip install "cocoindex[sqlite]"   # → 1.0.26, Python 3.13.5
export COCOINDEX_DISABLE_USAGE_TRACKING=1
cocoindex update app.py        # catch-up
cocoindex update -L app_live.py   # live (walk_dir(..., live=True))
cocoindex ls app.py| 단계 | CLI 요약 | 컴포넌트 실행 | 임베딩 실행 | SQLite 행 |
|---|---|---|---|---|
| run1 최초 백필 (a·b·c.md, 각 3섹션) | 3 total | 3 added | 3 | 9 | 9 |
| run2 변경 없음 | 3 total | 3 unchanged | 0 | 0 | 9 |
| run3 b.md 끝에 한 줄 추가 | 3 total | 1 reprocessed, 2 unchanged | 1 | 3 | 10 (b.md 3→4청크) |
| run4 c.md 삭제 | 3 total | 1 deleted, 2 unchanged | 0 | 0 | 7 (c.md 행 제거) |
run5 fake_embed version=2 |
2 total | 2 reprocessed | 2 | 7 | 7 (모든 벡터 재계산) |
| live: 새 파일 생성 | Ready (took 1.0s) | Watching for changes… | 1 | 1 | 0.1초 간격 폴링의 첫 확인에서 이미 반영 |
| live: 파일 삭제 | – | 0 | 0 | 2초 대기 후 확인 시 행 제거됨 |
pytest (v1.0.26 태그의 python/tests/core, 설치된 휠 대상) |
636 passed, 7 skipped (42.2초). main 브랜치 테스트를 1.0.26 휠에 돌렸을 때는 1 failed(버전 불일치로 보이며, 릴리스 이후 바뀐 동작) | |||
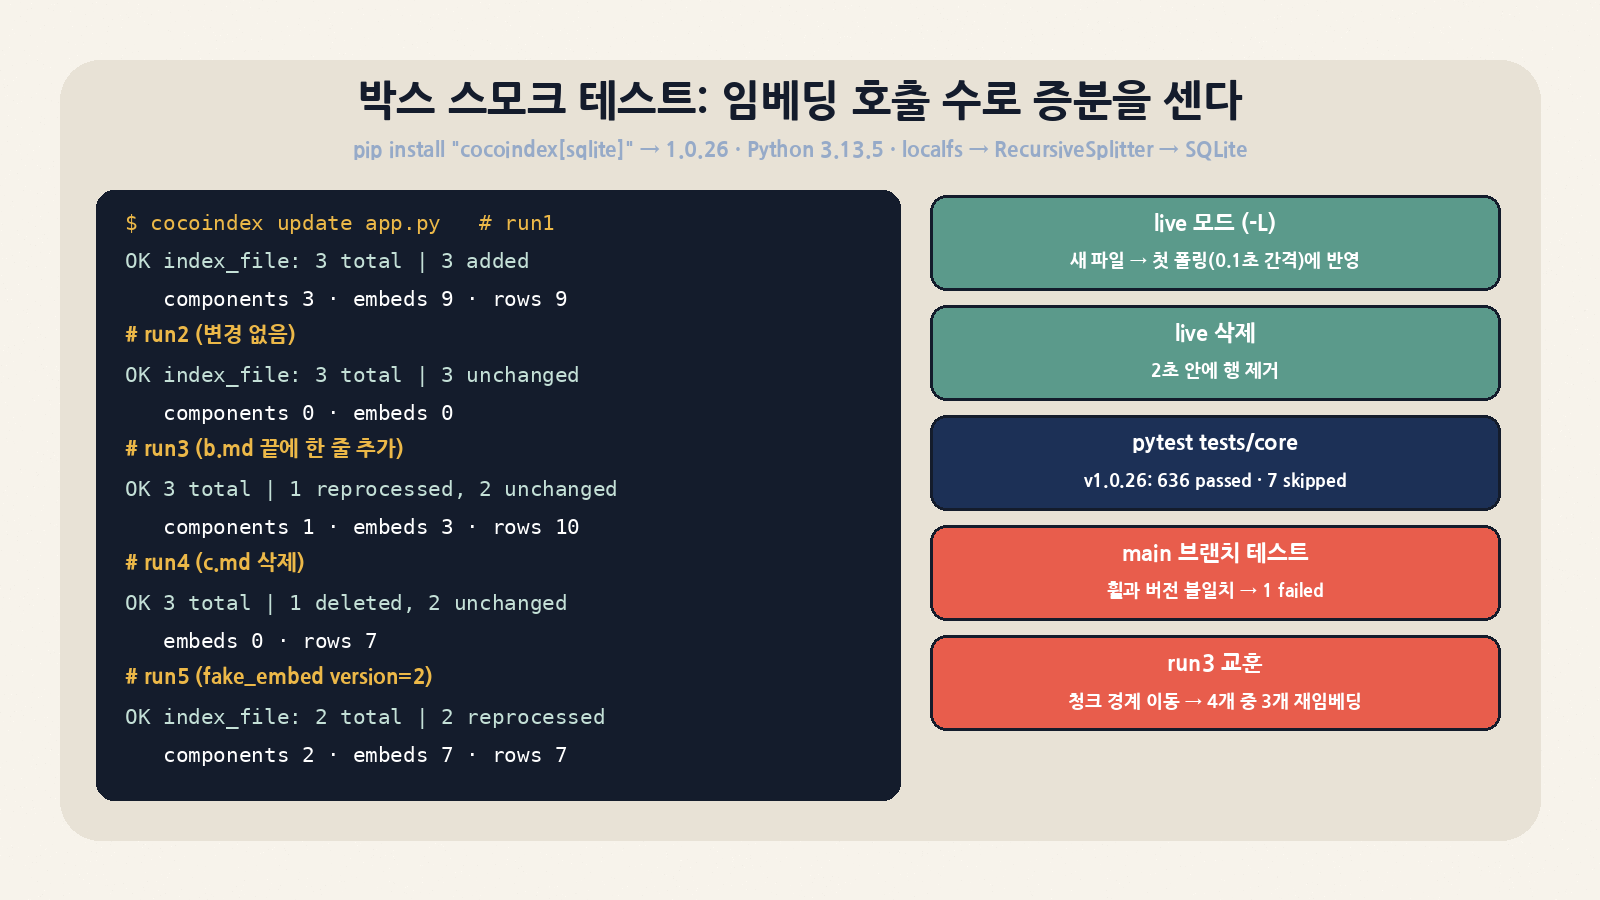
두 가지가 눈에 띄었습니다. 첫째, run5가 핵심 기능을 보여 줍니다. 데이터는 그대로 두고 임베딩 함수의 version만 올렸는데, 로직 지문이 전이적으로 전파되어 파일 컴포넌트까지 무효화됐고, 모든 벡터가 새로 계산됐습니다. “모델을 바꿨으니 전부 다시”를 사람이 기억할 필요가 없습니다. 둘째, run3은 기대보다 비쌌습니다. 한 줄을 덧붙였을 뿐인데 b.md의 청크 4개 중 3개가 다시 임베딩됐습니다. 청크 경계가 밀리면서 텍스트가 달라졌기 때문입니다(첫 청크만 캐시 히트). 증분 효율은 엔진만이 아니라 청크 경계가 얼마나 안정적인가에 크게 좌우됩니다. 기본 키를 문자 오프셋(loc)으로 잡으면, 앞부분을 고칠 때 뒤쪽 행이 줄줄이 지워지고 다시 들어간다는 점도 같은 맥락입니다.
8. 비슷한 도구와 비교
“바뀐 것만 다시 색인”이라는 문제는 여러 도구가 다룹니다. 차이는 무엇을 기준으로 바뀌었다고 판단하는가, 그리고 코드 변경도 그 기준에 들어가는가에 있습니다.
| 도구 | 증분 단위 | 코드 변경 추적 | 상태 저장 | 라이선스 | 잘 맞는 곳 |
|---|---|---|---|---|---|
| CocoIndex v1 | 처리 컴포넌트 + 함수 메모(입력·로직·컨텍스트 지문) | 예: 소스·version·deps가 전이적으로 전파 |
로컬 LMDB | Apache-2.0 | RAG·지식 그래프·에이전트 컨텍스트를 계속 최신으로 유지 |
| LangChain Indexing API | 문서 해시 + RecordManager | 없음(변환 로직이 바뀌면 사용자가 직접 재색인) | RecordManager(SQL 등) | MIT | 이미 LangChain VectorStore를 쓰는 단순한 중복 제거·정리 |
| LlamaIndex IngestionPipeline | docstore 해시 + 변환 캐시 | 제한적(변환 구성 기반 캐시) | docstore / cache 백엔드 | MIT | LlamaIndex 생태계 안의 ingestion |
| Pathway | 스트리밍 데이터플로(Rust 엔진) | 데이터 중심, 코드 메모 개념은 다름 | 엔진 내부 상태 / 영속화 옵션 | BSL 1.1 (GitHub API 표기 NOASSERTION) | 실시간 스트림 분석·ETL, 라이브 RAG |
| cron + 직접 구현 | mtime/해시 테이블을 직접 관리 | 직접 구현 | 직접 구현 | – | 소스 한두 개, 변환이 단순할 때 |
CocoIndex가 가장 분명하게 다른 점은 코드 변경을 일급 변경으로 다룬다는 것입니다. 반대로 LangChain이나 LlamaIndex 파이프라인을 이미 쓰고 있다면 그 위에 얹는 도구가 아니라 파이프라인 자체를 옮겨야 하는 도구라는 점이 도입 비용입니다. Pathway는 스타 수(GitHub API 62,048)로는 더 크지만, BSL 1.1은 OSI 오픈소스 라이선스가 아니라서 상용 사용 조건을 따로 확인해야 합니다.
9. 주의할 점과 한계
| 항목 | 내용 | 대응 |
|---|---|---|
| v0 자료 오염 | v1은 API가 완전히 다름. 외부 튜토리얼과 LLM이 v0 코드를 내놓기 쉬움 | skills/cocoindex/를 에이전트 컨텍스트로 제공, v0 심볼(flow_def, FlowBuilder) 린트 |
| 보이지 않는 헬퍼 | @coco.fn 없는 헬퍼를 고치면 메모가 무효화되지 않아 결과가 조용히 낡음 |
변환 경로의 헬퍼에는 memo 없이도 @coco.fn을 붙이기 |
| 메모 경계 밖 실행 | 처리 컴포넌트 밖(스크립트·테스트)에서 부른 memo=True 함수는 조용히 캐시를 건너뜀 |
단위 테스트에서 캐시 동작을 기대하지 말고 App을 통해 검증 |
| 타입 힌트 누락 | 반환 타입 주석이 없으면 캐시 값이 dict/list로 복원될 수 있음 | 메모 함수에는 반환 타입 필수 |
| 교차 타깃 정합성 | 서로 다른 백엔드 사이는 트랜잭션이 아님 | 소비 측이 일시적인 불일치를 견디도록 설계 |
| 청크 경계 불안정 | 스모크 run3처럼 작은 수정에도 재임베딩이 번질 수 있음 | 문단·구문 단위 분할, 내용 기반 키 검토 |
| LMDB 상태 크기 | 큰 반환값(벡터)을 메모하면 내부 저장소가 빠르게 커짐 | 배치 규칙을 따르고 map_size/max_dbs 모니터링 |
| 공급망 | v1.0.26 릴리스 노트: PyPI에 자격증명 탈취 코드와 백도어가 실린 채 올라온 litellm 1.107.0을 모든 litellm 요구 조건에서 제외(락 버전 1.96.2는 영향 없음) | extras를 쓸 때 락 파일과 해시 고정 |
| 텔레메트리 | 릴리스 빌드는 Scarf 게이트웨이로 익명 이벤트(init, app_create, app_update, app_drop: 플랫폼·언어 버전)를 기본 전송. 데이터·코드·경로·자격증명은 보내지 않는다고 문서에 명시 | 사내 환경은 COCOINDEX_DISABLE_USAGE_TRACKING=1 |
| 마케팅 수치 | README의 “70% 토큰 절감”, “10× 저렴”, “PB 규모” 등은 프로젝트 측 주장 | 자기 데이터로 캐시 히트율과 재임베딩 수를 직접 측정 |
10. 라이선스와 도입 체크리스트
Apache-2.0이므로 상용 사용, 수정, 재배포, 사내 포크가 모두 가능하고 특허 라이선스 조항도 따라옵니다. 재배포할 때는 LICENSE 고지 의무를 지키면 되고(저장소 루트에 별도 NOTICE 파일은 없음), 휠에는 Rust 의존성 고지(THIRD_PARTY_NOTICES.html)가 함께 들어 있습니다. 같은 저장소의 README에 “CocoIndex Enterprise”가 소개되어 있지만, 엔터프라이즈 기능이 별도 라이선스로 나뉘어 있다는 표시는 저장소 코드에서 찾지 못했습니다. 이 글에서 다룬 기능은 모두 Apache-2.0 코드에 들어 있습니다.
| 점검 항목 | 권장 |
|---|---|
| Python 버전 | 3.11 이상(pyproject 기준). 박스에서는 3.13.5로 확인 |
| 내부 상태 위치 | COCOINDEX_DB를 영속 볼륨에 두기. 지우면 처음부터 다시 계산 |
| 시작 경로 | 로컬은 localfs + sqlite로 검증 → 운영은 [postgres](pgvector)·[lancedb]·[qdrant] 중 선택 |
| 평가 지표 | run별 컴포넌트 재실행 수, 임베딩/LLM 호출 수, 타깃 행 증감, LMDB 크기 |
| 회귀 테스트 | 릴리스 태그의 python/tests를 설치 버전에 맞춰 실행(이번 확인: 636 passed) |
| 업그레이드 | 패치 릴리스가 잦음(반년 26회). 릴리스 노트의 Breaking 표기 확인 후 버전 고정 |
11. 정리: 누가 써야 하나
- 잘 맞는 경우: 코드베이스, 문서, 회의록 같은 원본이 계속 바뀌고, 임베딩이나 LLM 추출 비용이 크며, 프롬프트와 모델도 자주 바꾸는 팀. “무엇이 바뀌었는지”를 직접 관리하는 cron 스크립트가 이미 부담이 된 경우.
- 신중해야 하는 경우: LangChain·LlamaIndex 파이프라인에 깊이 묶여 있어 옮길 여력이 없는 팀, 여러 타깃 사이에 강한 트랜잭션 정합성이 필요한 경우, v0으로 만든 기존 코드가 있는 경우(재작성 필요).
- 설계 관점의 수확: 로직 지문의 전이 전파, 메모 상태 검증(mtime → 해시), “바깥이 빗나갈 때만 안쪽 메모가 의미 있다”는 배치 규칙은 CocoIndex를 쓰지 않더라도 증분 파이프라인을 설계할 때 그대로 가져다 쓸 만한 원칙입니다.
테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. 오늘 오후의 결론은 이렇습니다. CocoIndex는 “더 좋은 검색”이 아니라 “덜 다시 계산하는 색인”을 파는 도구이고, 그 효과는 엔진만큼이나 여러분이 메모 경계와 청크 경계를 어떻게 긋느냐에 달려 있습니다.